PAPER DEEP DIVE
WB-WAM:清华叉院把全身动作监督塞进视频预训练,人形数据效率提升 3 倍
清华交叉信息研究院、雄安人工智能研究院与墨尔本大学(Hang Zhao 组)提出 WB-WAM:72 维共享物理动作空间(身体 29 + 根部 3 + 双灵巧手 20+20)把 1,880.2 小时九源异构视频/动捕数据的部分标注统一进掩码流匹配的生成式视频预训练,再经 PICO 第一人称演示中间训练(22h/73 任务,GMR 重定向+约束 IK+MINT)与带前向运动学损失的真机后训练落到宇树 G1 + Wuji 灵巧手。仿真 HumanoidArena 七任务全胜(81.9%);真机五任务 84.0% 超 OpenWAM 的 80.0%(ACT 仅 20%、Fast-WAM 仅 6%);PICO 中间训练让 30 条真机演示达 73.8%,超过 100 条直训的 65.0%——真机数据省 70%。
一句话读懂
清华大学交叉信息研究院(IIIS)、雄安人工智能研究院与墨尔本大学(Hang Zhao 组,秦川、朱少霆共同一作)提出 WB-WAM(Whole-Body World Action Model):一个把显式全身动作监督直接注入生成式视频预训练的世界动作模型。72 维共享物理动作空间统一了身体关节(29)+ 根部运动(3)+ 双灵巧手(20+20)三类标注,让 1,880.2 小时部分标注的异构视频与动捕数据得以联合训练;再经 PICO 第一人称演示的中间训练(mid-training)与带前向运动学损失的真机后训练,落到宇树 G1 + Wuji 灵巧手平台。仿真 HumanoidArena 七任务全胜(81.9% 均值),真机五任务 84.0% 对 OpenWAM 的 80.0%;PICO 中间训练让 30 条真机演示达到 73.8%,超过 100 条直训的 65.0%——真机数据省 70%。
一、问题:人形 loco-manipulation 缺的不是数据量,是「全身动作」监督
通用人形机器人需要身体运动与灵巧操作的协调,但现有大规模机器人预训练数据主要来自单臂、双臂和轮式平台——它们对「协调的人形身体、根部与手部运动」的直接监督几乎为零。与此同时,异构运动来源各有残缺:第一人称操作视频有精细手部标注但没有身体运动,动捕集合有全身轨迹却没有视频。要把这些互补来源拧成一股绳,需要一个允许部分标注的预测接口。
现有方案的动作接地各有取舍:GR00T N1 用流匹配动作策略、Ψ0 预训练双臂任务空间 token、WholeBodyVLA 从视觉转移学离散隐动作、OpenHLM 改造非人形 VLA——但可扩展的视频数据要么没有动作、要么只有代理动作表示,控制器兼容的人形参考主要靠机器人数据或后期适配进入。把时间稠密、物理可解释的身体/根部/ articulated 手部参考直接注入世界动作模型的大规模预训练,此前仍是空白。
二、方法:72 维共享物理动作空间 + MoT 双专家
2.1 动作空间
每个时刻的全身动作参考是一个 72 维物理向量:
$$a_t = \left[\, q^B_t,\; r_t,\; q^L_t,\; q^R_t \,\right] \in \mathbb{R}^{72}$$
其中 $q^B_t \in \mathbb{R}^{29}$ 是 G1 身体关节位置参考,$r_t = (\phi_t, \theta_t, \omega^z_t) \in \mathbb{R}^3$ 是根部的 roll、pitch 与偏航角速度,$q^L_t, q^R_t \in \mathbb{R}^{20}$ 是双手的 articulated 关节参考。这个空间贯穿全部三个训练阶段不变——这正是异构数据能「各填各的坐标」的关键。
2.2 架构:MoT 视频专家 + 动作专家
模型基于 Fast-WAM 的多模态流匹配构建:Mixture-of-Transformers(MoT)骨干里,视频专家与动作专家各持模态专属参数,动作专家经 MoT 注意力条件化于视频专家特征。未来 RGB 帧由冻结的视频模型 VAE 编码,两个专家分别在潜视频与归一化物理参考轨迹上建模流场:
$$y_\tau = (1-\tau)\, y_0 + \tau\,\epsilon, \qquad u = \epsilon - y_0$$
任务建模为联合预测 $p_\theta(V_t, A_t \mid I_t, s_t, \ell)$——给定第一人称 RGB、本体感知状态与语言指令,同时预测未来视频片段与全身动作轨迹。总损失为:
$$\mathcal{L}(\theta; \mathcal{D}) = \lambda_{\text{vid}}\, \mathcal{L}_{\text{vid}} + \lambda_{\text{act}}\, \mathcal{L}_{\text{act}}$$
关键的掩码流匹配设计:二值掩码 $M$ 标记已标注、未填充的动作条目,目标流速度只对有效通道计算:
$$u^a = M \odot (\epsilon^a - A_0)$$
于是视频+身体+手(D_VBH)、视频+手(D_VH)、文本+身体(D_TB)三类监督可以在同一目标下混训——每个样本只为它拥有的通道负责。训练时动作 token 以等概率注意「完整条件视频」或「仅当前帧」,部署时走当前帧通路直接去噪动作轨迹,无需合成未来视频(IDM 可选)。
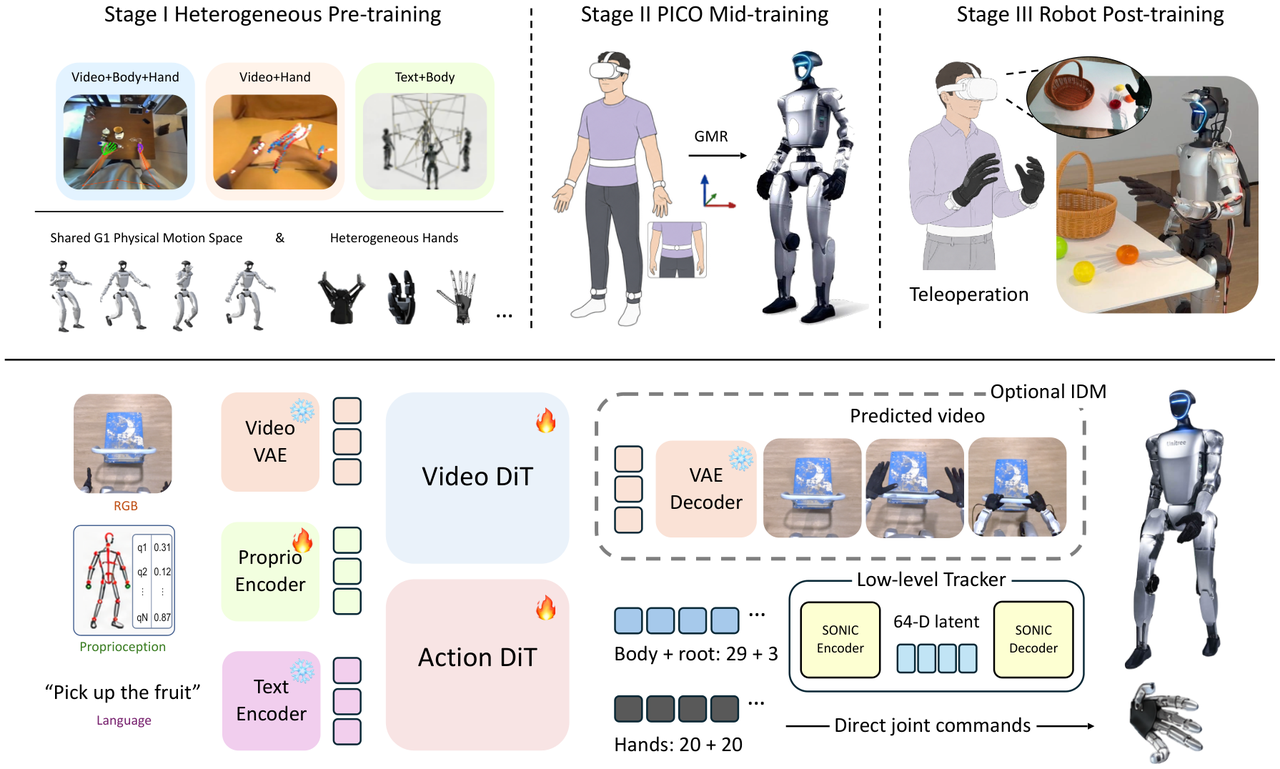
2.3 与操作侧 WAM 的关键差异
与面向固定基座操作的 WAM 相比,WB-WAM 在三处动了手术。其一,动作目标从末端位姿换成全身关节参考——末端位姿无法区分「站着抓」与「蹲着抓」,而人形任务里姿态本身就是任务的一部分(坐沙发、拳击、钻桌底);其二,输出分两路执行——身体/根部参考不直接驱动关节,而是经冻结的 SONIC 编码器变成 64 维控制潜变量交给 50 Hz 全身跟踪策略,这继承了「高层参考 + 低层跟踪」的成熟控制栈,把动力学稳定性外包给下游控制器;手部 40 维则绕过编码器直发关节命令,保住灵巧操作的低延迟。其三,推理走当前帧通路:训练时动作 token 等概率注意完整视频或仅当前帧,部署时无需先合成未来视频再去噪动作——推理解耦了视频生成,约 0.7 Hz 的重规划频率虽不快,但 32 步动作块(1.6 秒 @20 Hz)+ 执行 20 步的设定保证了运动的连续性。
语言与本体感知走 UMT5 文本编码器与本体编码器(均冻结/联合训练见下),条件注入经 MoT 注意力完成——语言不直接生成动作,而是调制视频与动作两个专家的联合去噪过程,这也是水果选择任务能靠单策略完成的结构基础。
三、三阶段课程与 WB-Datasets
| 阶段 | 数据 | 规模 | 作用 |
|---|---|---|---|
| Stage I 异构预训练 | 9 个外部源(Xperience、EgoDex、HIW-500、MotionMillion、BONES-SEED 等) | 1,880.2 小时 | 视频-动作联合学习;EgoDex 占 34.5% |
| Stage II PICO 中间训练 | PICO 4 Ultra + 5 追踪器第一人称演示(GMR 重定向 + 约束全身 IK 精修 + MINT 手部重建) | 22 小时 / 13,396 episodes / 73 任务 | 任务对齐的人类运动监督 |
| Stage III 真机后训练 | SONIC 遥操作演示(MANUS 手套控双手) | 1,011 episodes / 3.37 小时 / 8 任务 | 任务适配 + FK 损失 |
Stage III 的适配目标是任务专属模型 $\theta^k_{\text{III}}$(每个任务一个),在联合视频-动作目标之上增加可微分前向运动学(FK)损失(借鉴 BeyondMimic 的身体跟踪目标):
$$\mathcal{L}_{\text{III}} = \mathcal{L}(\theta; \mathcal{D}^k_R) + \lambda_{\text{FK}}\left(\mathcal{L}_{\text{pos}} + \beta_{\text{rot}}\, \mathcal{L}_{\text{rot}}\right)$$
预测的动作流经反归一化重建关节配置后,在骨盆坐标系下对选定 G1 连杆做位置与朝向误差惩罚——把「预测的参考」与「运动学上可达的姿态」绑定。数据管线还做了姿态有效性、运动连续性、全身碰撞与视频质量四道质检。部署时预测 32 步动作块(20 步去噪),前 20 步以 20 Hz 执行后重规划;身体/根部参考经冻结的 SONIC 编码器压成 64 维控制潜变量驱动 50 Hz 跟踪策略,底层 500 Hz 发电机命令,手部参考绕过编码器直接发关节命令。
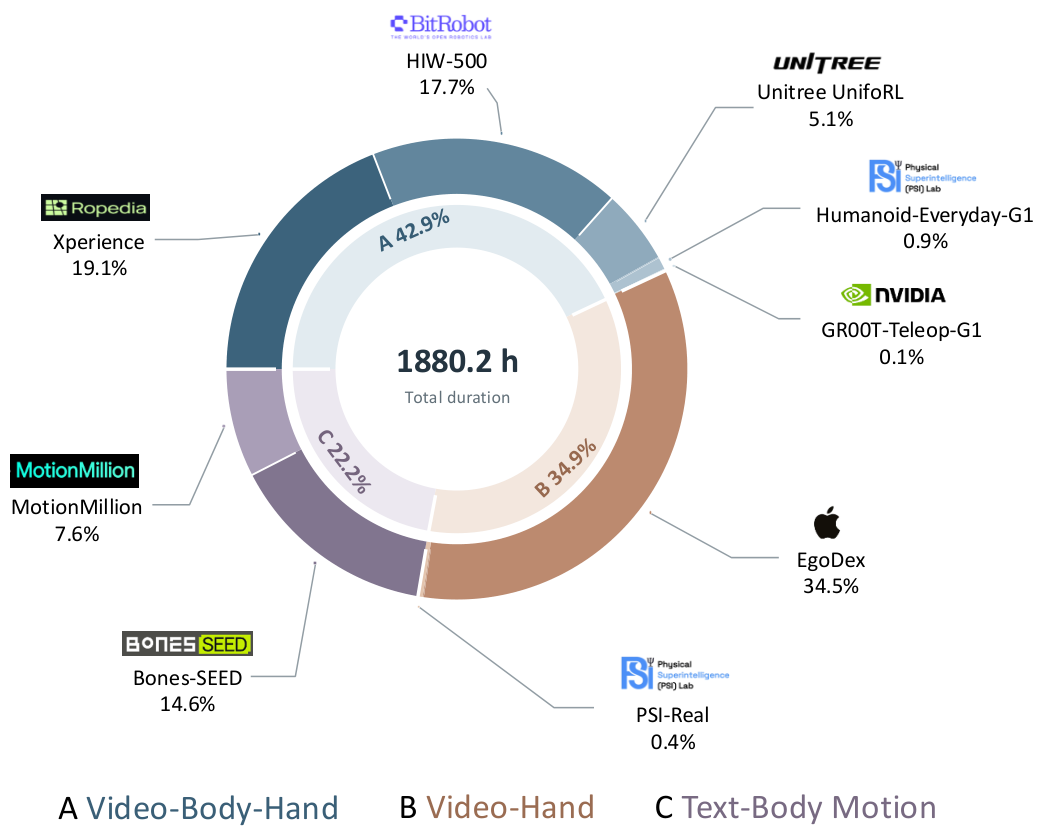
3.1 深挖数据配方:九个源怎么各司其职
图 3 的构成揭示了这一路线的数据策略:纯视频+手部的 EgoDex 一家占 34.5%(648 小时量级),说明灵巧手监督是语料的绝对主力——它与 G1 的 Wuji 手同为 articulated 关节参数化,重定向成本最低;Xperience(19.1%)与 MotionMillion(7.6%)这类人类运动集合经 General Motion Retargeting(GMR)把人体动捕映射到 G1 形态,贡献「大类运动模式」——走路、下蹲、转身、弯腰;HIW-500(17.7%)与 Humanoid-Everyday-G1(0.9%)这类家庭场景数据补物体交互上下文;文本-身体运动(BONES-SEED 14.6%)无视频但给动作专家注入「语言→全身姿态」的先验。注意这些占比是时长占比而非监督价值:0.4% 的 PSI-Real 与 0.1% 的 GR00T-Teleop-G1 是唯二的「机器人坐标原生」数据,无需重定向、物理语义最干净,是策略接地的锚点。
质检管线值得工程团队参考:阈值化的检测器打分区分「明确失败」与「模糊案例」,后者进入人工细查——四道检查分别是姿态无效(如自穿透)、运动不连续(关节命令跳变)、全身碰撞、视频帧缺失/损坏。这套流程处理的是异构数据的现实:GMR 重定向偶尔产生运动学可行但物理荒谬的姿态,若不筛除会直接污染 72 维监督。
3.2 PICO 采集管线:从 20 Hz SMPL 到 G1 关节参考
中间训练数据的采集硬件是一台 PICO 4 Ultra 头显加五个追踪器(双手、双脚、腰部),同步录制第一人称 RGB 与 20 Hz 的 SMPL 身体运动。转换链分四步:GMR 先给出初始 G1 运动序列;约束式全身逆运动学精修——在跟踪标定后的人类任务空间位置与掌心朝向目标的同时,显式满足关节限位、速度界、支撑约束与自碰撞回避;MINT 从第一人称视频重建人手关键点并重定向到 Wuji 关节配置;最后把身体/根部参考与录制的视频做时间对齐。作者诚实指出:重定向只提供运动学监督,动态稳定性与接触可行性并未因此建立——这正是 Stage III 还需要真机演示与 FK 损失的原因。
四、实验战绩
4.1 仿真:HumanoidArena 七任务全胜
| 方法 | Football | DoubleDesk | P&PBox | OpenDoor | SitSofa | Boxing | VisNavi | 均值 |
|---|---|---|---|---|---|---|---|---|
| 逐任务最强基线 | 45.0 | 43.3 | 75.0 | 85.0 | 78.3 | 76.7 | 38.3 | — |
| π0.5 / DP / ACT / FM | 51.2 | 47.6 | 45.0 | 60.0 | 51.2 | 60.0 | — | — |
| WB-WAM | 70.0 | 65.0 | 86.7 | 98.3 | 95.0 | 81.7 | 76.7 | 81.9 |
七个任务全部超过原基准逐任务最强基线,增益横跨运动(Football +25.0、VisNavi +38.4)、姿态调整(SitSofa +16.7)与物体交互(P&PBox +11.7)——正是「全身预训练」区别于纯操作预训练的用武之地。
4.2 真机:G1 + Wuji 双手,六基线对照
五任务(擦桌、关窗帘、铺床、移枕、整理布料;前三含移动)各 20 次真机试验、约 100 条演示/任务、六基线(ACT、π0.5、GR00T N1.6、Fast-WAM、DiT4DiT、OpenWAM)同台:
WB-WAM 均值成功率 84.0%(任务进度 86.67%),超过最强基线 OpenWAM 的 80.0%;ACT 仅 20%(移动类任务全线 0/20)、Fast-WAM 仅 6%。含移动的三任务 WB-WAM 达 76.7% vs OpenWAM 71.7%。基线失败的典型模式是接近不准、抓取失败、操作与身体运动失调——恰是全身监督要解决的坐标耦合问题。
逐任务拆开看更有信息量:移枕任务 WB-WAM 与 OpenWAM 双双 100%(20/20),说明静止类全身操作已接近饱和;差距主要在含移动任务——擦桌 75% vs 90%(OpenWAM 反超)、关窗帘 65% vs 55%、铺床 90% vs 85%。擦桌上的落败值得注意:擦桌要求身体的持续前倾与手臂施加稳定下压力,动作块之间的一致性比单帧姿态更关键,这也暗示动作块长度与重规划节奏(当前 32 步块、执行 20 步)对长时程接触任务仍有调优空间。里程碑指标(接近 A / 接触 C / 成功 S)的分解显示 WB-WAM 的优势集中在 C→S 段——即接触建立后的协调执行,而接近段的鲁棒性各方法差距不大。
4.2.1 语言条件与视觉泛化
语言条件的水果操作(橙/柠/苹果)用单策略 ~300 演示达成 75–85% 的选择接触成功率与 75–85% 的最终成功率(橙 15/20、柠 17/20、苹 16/20),无需为每个目标单独训练——语言指令直接调制作家身体与手部轨迹的生成。视觉运动泛化实验更具启发性:在推车任务中往车上加杂物(改变外观而不改变任务目标),视频专家能对修改后的条件 rollout 未来画面,而 WB-WAM 无需任何再适配即在真机完成推车——视频专家的预测能力在 OOD 条件下为动作专家提供了隐式的场景理解缓冲,这是「动作+视频联合建模」区别于纯动作策略的结构性优势。
4.3 PICO 中间训练:70% 真机数据换更高成功率
| 训练路线 | 真机演示 | 均值 SR | 均值 TP |
|---|---|---|---|
| 直接后训练 | 30/任务 | 48.8% | 51.0% |
| 直接后训练 | 100/任务 | 65.0% | 70.4% |
| PICO 中间训练 + 后训练 | 30/任务 | 73.8% | 78.1% |
同任务对齐的 PICO 演示(每任务约 150 条人类演示)作为中间训练后,30 条真机演示(省 70%)达到 73.8%,反超 100 条直训的 65.0%;在共享任务上,擦桌 90% 追平最强基线、关窗帘 80% 超其 60%——人类运动迁移以一当三。视觉运动泛化方面,视频专家可在未见场景(推车加杂物)rollout 未来画面,真机无需再适配即可执行。
4.4 怎么读这些数字:三个关键对照
第一组对照是 WB-WAM(无 PICO)84.0% vs 有 PICO 的任务策略——细看表 II 与表 III 的重叠任务:PICO 中间训练版在擦桌 90%、关窗帘 80%,均高于无 PICO 版的同任务成绩,说明中间训练不仅省数据,还抬高了性能上限——VR 录制的人类演示虽然便宜,其任务对齐的运动先验是「真」的。第二组对照是 Fast-WAM 6% vs WB-WAM 84%:两者共享同一 MoT 流匹配骨架与 Wan2.2 初始化,唯一差异是 WB-WAM 的全身监督数据与三阶段课程——这 78 个点的差距几乎可以全部归因于「预训练里有没有身体和手」这一变量,是全文最干净的一次消融。第三组对照是 ACT/π0.5/GR00T 在含移动与不含移动任务上的表现断层:三个非全身预训练基线在 w/ locomotion 任务的 SR 均值远低于 w/o locomotion,而 WB-WAM 两者接近——全身预训练抹平的正是「走过去再操作」这类任务切换的鸿沟。
计算开销方面,20 步去噪生成 32 步动作块、每步重规划间隔执行 20 个动作步(1 秒 @20 Hz),对部署硬件的要求与 Fast-WAM 相当;视频分支可选关闭(当前帧通路)进一步省算力。对想复现的团队,成本结构是:1,880 小时外部数据几乎免费(公开数据集 + 重定向),22 小时 PICO 录制需要 VR 头显 + 5 追踪器(一天可录数千条),1,011 条真机遥操作是唯一昂贵的部分,且 PICO 路线可把它再砍 70%。
视频+身体+手 / 视频+手 / 文本+身体"] --> B["Stage I 异构预训练
MoT 视频+动作双专家
掩码流匹配"] B --> C["Stage II PICO 中间训练
22 h / 13,396 eps / 73 任务
GMR 重定向 + 约束 IK + MINT"] C --> D["Stage III 真机后训练
SONIC 遥操作演示
+ 前向运动学 FK 损失"] D --> E["部署:宇树 G1 + Wuji 双手
SONIC 64 维潜变量控身体
手部直接关节命令"] E --> F["HumanoidArena 81.9%
七任务全胜"] E --> G["真机五任务 84.0%
vs OpenWAM 80.0%"] E --> H["PICO 迁移:30 演示 73.8%
超 100 演示直训 65.0%"]
五、边界与启示
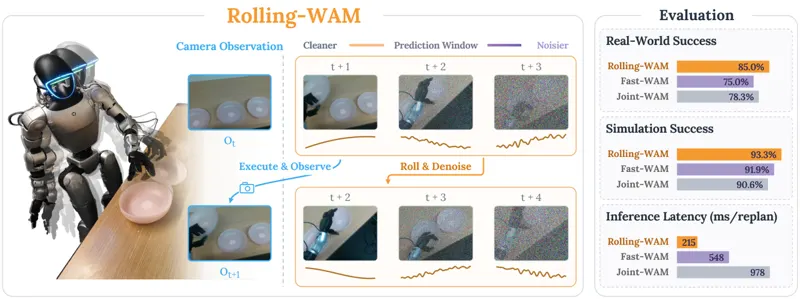
作者坦承当前评估仅限单一机器人平台与任务专属策略(每任务一个 $\theta^k_{\text{III}}$),向未见任务扩展、提升物体交互中的执行精度是未来工作。重定向提供了运动学监督,但物理稳定性与接触可行性仍要靠真机后训练补足。放在技术脉络里,WB-WAM 与 Rolling-WAM(滚动去噪加速 WAM 推理)共同回答了「WAM 如何走向全身人形」:前者补动作监督的覆盖面——让 1,880 小时异构数据里每一份可用的身体/手部标注都变成监督信号;后者补推理效率。而 PICO 中间训练的 73.8% vs 65.0% 则给出一条朴素而有力的工程结论:同任务的人类演示是性价比最高的真机数据替代品——22 小时 VR 遥操作级录制,抵得上 70% 的真机采集成本。项目页 wb-wam.github.io,模型权重与代码即将开源。
六、技术定位:三条路线在 72 维空间交汇
把 WB-WAM 放到 2026 年的人形技术脉络里,它站在三条线的交汇点上:世界动作模型(WAM)提供「动作生成 + 未来视觉预测」的联合建模骨架(Fast-WAM 的 MoT 流匹配、Rolling-WAM 的滚动去噪),人形基座模型提供异构人机数据的预训练范式(GR00T N1、Ψ0、WholeBodyVLA),人类运动迁移提供绕过真机数据瓶颈的路径(重定向 + 第一人称遥操作)。WB-WAM 的独特贡献是把三者拧进同一个 72 维物理动作空间,并用掩码流匹配让部分标注的异构数据真正「拼」起来——不是把数据统一成同一种格式,而是让动作空间容纳各自的原生格式。
这条路线与 GE-Act 2.0 的「原生世界动作模型」、UCAG-P 的「相机中心共享动作空间」构成有趣的对照:三者都在解决「异构本体数据如何共享监督」,但共享的层次不同——GE-Act 共享生成式视频先验、UCAG-P 共享相机可观测几何、WB-WAM 共享物理关节空间的坐标通道(身体-根部-手各占其位,谁有标谁)。UCAG-P 面向机械臂/双臂,WB-WAM 面向人形全身,两者的动作空间恰恰互补:前者管「手在哪、怎么抓」,后者管「身体怎么到那儿、腿怎么站」。一个自然的未来方向是把相机中心几何锚点与 72 维全身关节参考拼进同一接口——那时「人类视频 + 机器人轨迹 + 动捕」将真正无差别地参与人形预训练。