PAPER DEEP DIVE
SSR:面向开放世界的人形机器人稳健对称通行
把第一视角深度图直接变成开放世界里的稳健步伐,是人形机器人落地人类环境的关键一步。SSR 用单阶段端到端强化学习联合习得安全落脚、双侧协调与类人全身动作:想象落脚点引导在摆动期预测未来接触分布并评估其支撑度,把只在触地时刻才出现的稀疏安全信号变成落地前的密集纠正;等变潜空间镜像增强把对称增广从高分辨率深度图移到 48 维潜向量上,训练显存从 28.8 GB 降到 23.7 GB;地形特定多判别器 AMP 让不同地形各自保持自然的动作风格。AgiBot X2 真机零样本跨越 90 cm 沟壑、登上 45 cm 高台,并在户外公园完成 1.3 km、40 分钟无复位长时程通行;同一训练与部署管线迁移到 1.8 m、70 kg 的 DR02 全尺寸人形机器人同样有效。
原标题:SSR: Scaling Surefooted and Symmetric Humanoid Traversal to the Open World
作者:Ruiqi Yu*、Yiwen Wang*、Yuan Hao、Jun Wu、Qiuguo Zhu(通讯作者)(* 同等贡献)
机构:浙江大学
链接:arXiv:2605.30770 ·
项目主页
代码状态:截至入库时未公开代码仓库,项目主页仅提供论文、视频与 BibTeX
一句话总结
SSR 用单阶段端到端强化学习,把「落地前想象落脚点、潜空间里镜像对称、按地形分配风格判别器」三件事装进同一个第一视角深度策略,让人形机器人在真实开放世界走得稳、走得对称、走得像人。
研究背景与动机
人形机器人要进入人类环境,第一道坎不是「会走」,而是「在什么样的地面上都能走」。楼梯有宽窄与层高之差,路边有沟壑与台阶,公园里有草坡与碎石;同一条腿在平地上踩错半厘米无伤大雅,在 22 cm 宽的踏面上踩偏 3 cm 就是一次滑倒。开放世界通行的难点,在于把感知、落脚决策与全身协调放进同一个闭环,并且这个闭环必须跑在机器人自己的传感器与算力上。
近年基于学习的人形运动控制普遍引入本体感知之外的外部感知。其中直接以第一视角深度图为条件的策略尤其适合真实动态场景:它绕开了显式建图,也就绕开了定位漂移、更新延迟与遮挡带来的误差累积。但「看得见」不等于「踩得准」:策略必须从低分辨率深度线索里推断局部地形结构,再把它翻译成可靠的落脚决策。对平底足的人形机器人而言,踩在踏面边缘会急剧缩小有效支撑面积,滑移与摔倒风险随之上升。
仅有安全还不够。人类环境里的通行同时要求协调、可控、自然的全身动作。已有工作通常分别引入对称先验或人体动作模仿:对称先验保证左右腿行为均衡,模仿学习保证动作不像「抽搐的机器」。但把这两者塞进第一视角视觉策略时,代价立刻显现——高维视觉观测让对称学习的算力与显存开销暴涨,而地形依赖的动力学又会让一个共享的「类人风格」先验失稳。安全落脚、对称协调、类人风格,三者在视觉策略里长期是互相挤占的三块预算。
作者观察到,这三块预算之所以互相挤占,是因为它们被放在了错误的层级上。落脚安全的评估过去只在触地时刻或触地之后发生,摆动期的动作拿不到及时反馈;对称增广过去作用在高分辨率深度图与循环隐状态上,每份镜像样本都要重新编码一次;风格先验过去由单一判别器承担,被迫在楼梯、沟壑、高台之间折中。SSR 的三个设计分别把这三件事下移到更便宜、更及时的层级:用想象接触把安全评估前移到摆动期,用等变编码器把对称增广下移到 48 维潜向量,用多个地形判别器把风格先验拆开。
由此,SSR 给出一个统一的单阶段端到端强化学习框架:直接从第一视角深度与本体感知学习,联合获得可靠落脚与高质量全身动作,并把步态对称与类人行为耦合在同一策略中。论文在仿真与真机两侧验证:仿真中在全部训练难度上保持接近 100% 的通过率,并能外推到课程之外的 90 cm 沟壑与 45 cm 高台;真机上零样本完成这些地形,并在户外工业遗产公园连续通行 1.3 km、40 分钟,全程无复位、无踩空。
预备知识
SSR 将人形运动建模为部分可观测马尔可夫决策过程(POMDP),用 PPO 在非对称 actor-critic 架构下优化。策略侧只能看到本体感知历史与深度图,评论家侧额外看到真值基座速度、足端速度、接触状态、肢体位置以及足部与身体周围的高度图——这是典型的特权信息训练:训练时用一个更强的老师估计价值,部署时只留学生。
在时刻 $t$,策略的本体感知 $\mathbf{o}_{t}^{p}\in\mathbb{R}^{72}$ 包含基座角速度、投影重力、速度指令、关节位置、关节速度与上一步动作,并堆叠一段短历史 $\mathbf{o}_{t-h+1:t}^{p}$ 以缓解部分可观测性;深度图 $\mathbf{I}_{t}\in\mathbb{R}^{36\times 36}$ 与之共同构成观测,输出 21 个驱动关节的位置目标。36×36 的分辨率看似粗糙,却是机载算力的现实约束:真机上 Jetson AGX Orin 以 50 Hz 输出动作,深度相机以 60 Hz 供流。
策略网络由三部分组成:跨模态循环编码器、运动状态估计器与混合专家(MoE)actor。编码器用 CNN 编码深度、用 MLP 编码时序本体感知,再由 GRU 融合为带三个头的潜表示 $\hat{\mathbf{z}}_{t}=[\hat{\mathbf{z}}_{t}^{f},\hat{\mathbf{z}}_{t}^{b},\hat{\mathbf{z}}_{t}^{p}]^{\top}$:前两个头分别解码足部与基座为中心的地形几何,第三个头以变分自编码器方式预测下一步本体感知,从而隐式建模系统动力学。估计器从时序本体感知预测基座速度 $\hat{\mathbf{v}}_{t}$。actor 以当前本体感知、$\hat{\mathbf{v}}_{t}$ 与 $\hat{\mathbf{z}}_{t}$ 为输入,5 个专家的 MoE 结构让一个策略足以表示随地形切换的运动模式。
方法详解
想象落脚点引导:把安全评估前移到落地之前。训练时,一个落脚点想象模型学习从特权状态 $\mathbf{s}_{t}$ 与动作 $\mathbf{a}_{t}$ 映射到前瞻接触分布 $\hat{\mathbf{F}}_{t}=\{\hat{F}_{i,t}\}_{i=1}^{2}$。对每只脚,$\hat{F}_{i,t}=(\hat{\bm{\mu}}_{i,t},\hat{\sigma}_{i,t})$ 在当前基座坐标系下参数化一个高斯想象接触分布 $q_{i,t}(\mathbf{p})=\mathcal{N}(\mathbf{p};\hat{\bm{\mu}}_{i,t},(\hat{\sigma}_{i,t})^{2}\mathbf{I})$,其中 $\hat{\bm{\mu}}_{i,t}\in\mathbb{R}^{2}$ 是预期接触位置,$\hat{\sigma}_{i,t}$ 刻画不确定性。监督目标是该脚未来第一个有效接触位置 $\mathbf{p}_{i,t}^{*}$(基座坐标系),训练损失为高斯负对数似然:
$$\mathcal{L}_{\text{pred}}=-\sum_{i=1}^{2}\log q_{i,t}(\mathbf{p}_{i,t}^{*})\propto\sum_{i=1}^{2}\left(\frac{\|\mathbf{p}_{i,t}^{*}-\hat{\bm{\mu}}_{i,t}\|_{2}^{2}}{2(\hat{\sigma}_{i,t})^{2}}+2\log\hat{\sigma}_{i,t}\right)$$
训练早期步态不稳,未来接触目标噪声大,作者以地形课程等级作为可靠性代理:只有超过预设课程等级之后,才启用落地前引导,避免用不可靠的想象信号污染早期学习。
支撑缺失度:给「踩得稳不稳」一个可微的度量。设 $\mathbf{H}^{f}(\mathbf{p})=\{h_{k}(\mathbf{p})\}_{k=1}^{n}$ 为以 $\mathbf{p}\in\mathbb{R}^{2}$ 为中心、尺寸 22.5 cm × 10 cm 的鞋底 patches 高度图,每 2.5 cm 采样一点,$h_{k}(\mathbf{p})$ 是 $\mathbf{p}+\delta_{k}$ 处的地形高度。支撑缺失度定义为:
$$\rho(\mathbf{p})=1-\frac{1}{n}\sum_{k=1}^{n}\mathbb{1}\{h^{f}(\mathbf{p})-h_{k}(\mathbf{p})<\epsilon_{h}\}$$
其中 $h^{f}(\mathbf{p})$ 为鞋底高度;对想象出的落地前位置,取 $h^{f}(\mathbf{p})=\max_{k}h_{k}(\mathbf{p})$。$\rho(\mathbf{p})$ 越大,说明鞋底覆盖范围内缺少支撑的比例越高,通常对应地形边缘或悬空区域。这个量把「踩在边缘」从一句定性描述变成了一个可以在奖励里直接使用的标量。
从稀疏到密集:摆动期的期望支撑缺失。每只脚在支撑相与摆动相之间交替,SSR 据此把落脚引导写进 RL 目标:
$$r^{f}_{t}=\exp\!\left(-\left(\sum_{i=1}^{2}\tilde{\rho}_{i,t}\right)^{2}/\sigma_{f}\right),\quad \tilde{\rho}_{i,t}=c_{i,t}\,\rho(\mathbf{p}_{i,t})+(1-c_{i,t})\,\mathbb{E}_{\mathbf{p}\sim q_{i,t}}[\rho(\mathbf{p})]$$
其中 $c_{i,t}$ 指示脚 $i$ 是否处于支撑相:支撑脚在当前真实接触处评估,摆动脚则在想象接触分布 $q_{i,t}$ 下取期望缺失(以离散高斯加权采样近似)。这一式是全文最关键的一步转换——它把「只在触地时刻出现」的稀疏安全信号,变成摆动期每一步都存在的密集引导,使策略能在落地之前就把脚导向平坦、支撑充分的区域。在坡面地形上,作者将两脚的 $\tilde{\rho}_{i,t}$ 置零(即 $r^{f}_{t}=1$),避免对倾斜接触造成误抑制。
等变潜空间对称增广:把镜像搬到 48 维上。输入级对称增广对视觉循环策略极其昂贵:每份镜像样本都要重新编码深度图,并 rollout 一份镜像的记忆状态。SSR 改为只编码原始观测一次,然后对紧凑的 actor 输入做增广。其前提是编码器必须满足镜像等变:镜像观测的潜表示,等于原始潜表示的镜像。
为此,作者先给潜表示施加一个对称结构:每个头 $\hat{\mathbf{z}}^{(k)}_{t}$,$k\in\{f,b,p\}$,被组织成左右配对的两个通道组,镜像算子 $\mathcal{M}_{c}$ 即交换两组:
$$\mathbf{X}=[\mathbf{X}^{(L)},\mathbf{X}^{(R)}]^{\top},\qquad \mathcal{M}_{c}(\mathbf{X})=[\mathbf{X}^{(R)},\mathbf{X}^{(L)}]^{\top}$$
接着把编码器输入整理成对称结构形式:固定算子 $\mathcal{T}$ 重排时序本体感知为 $\bar{\mathbf{o}}^{p}_{t}=\mathcal{T}(\mathbf{o}^{p}_{t-h+1:t})$,CNN 第一层把图像 lift 成配对通道;MLP、CNN 与 GRU 均用等变线性层或等变卷积层实现(借鉴 Cesa 等的群等变网络构造)。对每个头 $E_{\phi}^{(k)}$,等变条件为:
$$E_{\phi}^{(k)}(\mathcal{M}_{c}\bar{\mathbf{o}}^{p}_{t},\mathcal{M}_{\mathrm{2D}}\mathbf{I}_{t})=\mathcal{M}_{c}\,E_{\phi}^{(k)}(\bar{\mathbf{o}}^{p}_{t},\mathbf{I}_{t})$$
其中 $\mathcal{M}_{\mathrm{2D}}$ 为水平翻转。关节空间的镜像规则同样被显式写出:对 $\mathbf{x}=[\mathbf{x}_{R}^{\mathrm{leg}},\mathbf{x}_{L}^{\mathrm{leg}},x^{\mathrm{waist}},\mathbf{x}_{R}^{\mathrm{arm}},\mathbf{x}_{L}^{\mathrm{arm}}]^{\top}\in\mathbb{R}^{21}$,以符号向量 $\mathbf{s}_{\mathrm{leg}}=[1,-1,-1,1,1,-1]^{\top}$、$\mathbf{s}_{\mathrm{arm}}=[1,-1,-1,1]^{\top}$ 做逐元素符号翻转并交换左右链:
$$\mathcal{F}(\mathbf{x})=[\mathbf{x}_{L}^{\mathrm{leg}}\odot\mathbf{s}_{\mathrm{leg}},\ \mathbf{x}_{R}^{\mathrm{leg}}\odot\mathbf{s}_{\mathrm{leg}},\ -x^{\mathrm{waist}},\ \mathbf{x}_{L}^{\mathrm{arm}}\odot\mathbf{s}_{\mathrm{arm}},\ \mathbf{x}_{R}^{\mathrm{arm}}\odot\mathbf{s}_{\mathrm{arm}}]^{\top}$$
训练时编码器只跑原始观测,随后对紧凑的 actor 观测、特权状态与动作做镜像:$\mathbf{o}^{a,g}_{t}=\mathcal{M}_{o}\mathbf{o}^{a}_{t}$、$\mathbf{s}^{g}_{t}=\mathcal{M}_{s}\mathbf{s}_{t}$、$\mathbf{a}^{g}_{t}=\mathcal{M}_{a}\mathbf{a}_{t}$,得到镜像轨迹 $\tau^{g}$ 并拼进原始 rollout 一起供 PPO 更新。相比输入级增广,这省去了镜像图像编码与循环隐状态 rollout;相比严格等变架构,它又保留了在中性状态附近打破对称、供步态探索的灵活性。
跨地形运动先验:一个地形一个判别器。为鼓励与地形相称的动作风格,SSR 采用多个判别器,每种地形一个 $D_{i}$。每个判别器以五帧历史 $\bm{\psi}_{t}$ 为输入,每帧 $\mathbf{s}_{t}^{\mathrm{amp}}\in\mathbb{R}^{63}$ 含投影重力、基座线速度与角速度、关节位置与速度、肢体位置;沿 AMP 的对抗式训练区分参考动作与策略动作,并产出风格奖励:
$$r^{s}_{t}=\max[\,0,\ 1-0.25\,(D_{i}(\bm{\psi}_{t})-1)^{2}\,]$$
各地形的参考动作来自动捕自采数据与 AMASS 子集,重定向到人形后按地形组织(坡面 261.3 s、楼梯 295.8 s、离散障碍 136.0 s、沟壑 174.5 s、高台 181.6 s)。三组奖励 $r^{l}$(任务)、$r^{f}$(落脚)、$r^{s}$(风格)各配一个评论家,优势权重分别为 $w_{l}=1.0$、$w_{f}=0.25$、$w_{s}=0.2$,以多评论家结构改善各自价值函数的估计。
与部署一致的深度渲染。仿真侧的深度观测必须与真机传感器「同分布」,否则 sim-to-real 会在感知层先裂开。作者用 NVIDIA Warp 实现带自遮挡的高效深度渲染:对静态地形网格与机器人动态连杆网格同时做光线投射,但不每步重建 BVH,而是把相机光线从世界坐标系变换到各网格的局部坐标系再求交——刚体变换下命中距离可直接比较。这一实现让 4096 个并行环境的自遮挡深度渲染不再是瓶颈。
整体流程如下图所示:编码器、估计器与 MoE actor 构成部署时唯一的策略;想象落脚点引导、等变潜空间增广与多判别器 AMP 均为训练期机制,部署时不占机载算力。
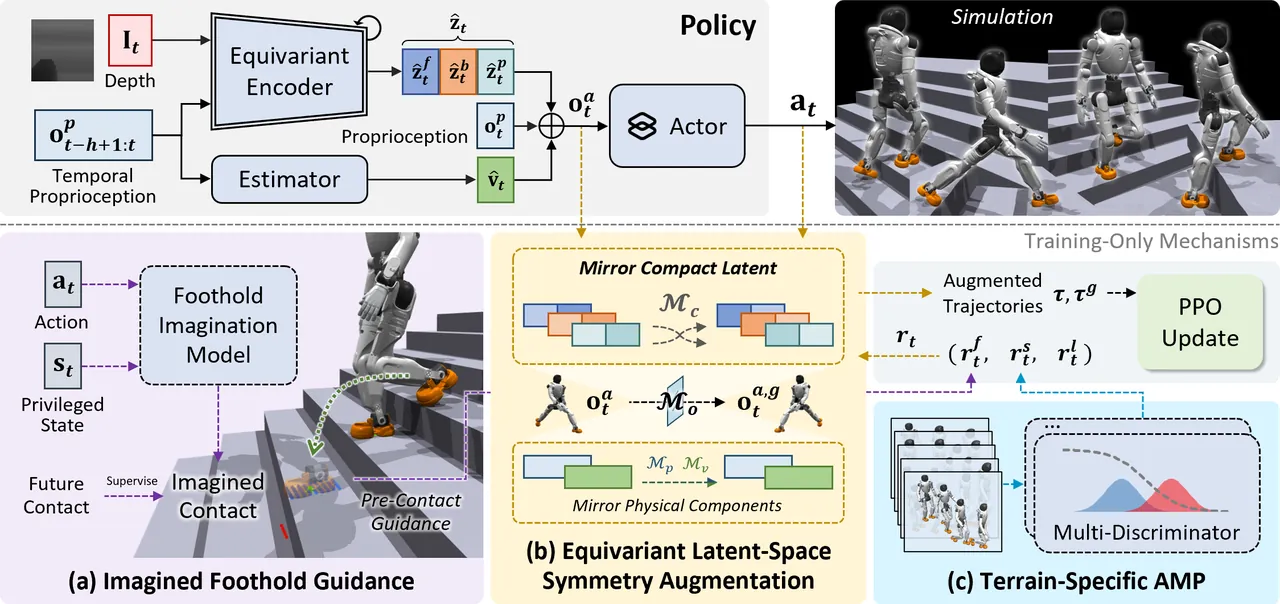
图 1:SSR 框架总览。策略由循环等变编码器、估计器与 MoE actor 组成;训练期三个机制分别为想象落脚点引导、等变潜空间对称增广与地形特定多判别器 AMP。
flowchart TD
  D[Egocentric depth 36x36] --> CNN[Equivariant CNN]
  P[Temporal proprioception] --> MLP[Equivariant MLP]
  CNN --> GRU[Equivariant GRU fusion]
  MLP --> GRU
  GRU --> ZF[latent zf: foot terrain]
  GRU --> ZB[latent zb: base terrain]
  GRU --> ZP[latent zp: VAE dynamics]
  P --> EST[Velocity estimator]
  EST --> V[base velocity estimate]
  ZF --> ACT[MoE actor, 5 experts]
  ZB --> ACT
  ZP --> ACT
  V --> ACT
  P --> ACT
  ACT --> A[21 joint position targets]
  S[Privileged state + action] --> FIM[Foothold imagination model]
  FIM --> Q[imagined contact Gaussian q]
  Q --> RHO[expected support deficiency]
  RHO --> RF[dense swing reward rf]
  ZF --> MIR[mirror latent Mc]
  MIR --> AUG[mirrored trajectory for PPO]
  M[5 terrain discriminators] --> RS[style reward rs]
图 2:按论文真实方法绘制的数据流。部署路径只有编码器-估计器-actor;想象落脚、镜像增广与风格判别器都只存在于训练期。
实验结果
仿真在 Isaac Gym 中以 4096 个 AgiBot X2 并行环境、单张 RTX 4090 训练约 20k 迭代;成功率定义为在 1.0 m/s 前进指令下完成 20 s 通行而不触发终止的试验比例,每种地形 1000 次随机试验。SSR 在全部训练难度上保持接近 100% 的成功率,包括最难的楼梯——22 cm 的脚只有 3 cm 的支撑余量;并且外推到课程之外:90 cm 沟壑与 45 cm 高台(约 1.6 倍小腿长)依然通过。对照的 HPL(多阶段第一视角视觉 parkour)与 PIM(单阶段高度图方法)随难度上升迅速退化,说明稀疏或间接的落脚引导不足以支撑精确落脚学习。消融中掉得最狠的是 NoFoothold(去掉落脚引导)与 NoImgn(只保留触地时刻评估),直接印证「密集落地前信号」是通行能力的主体来源。
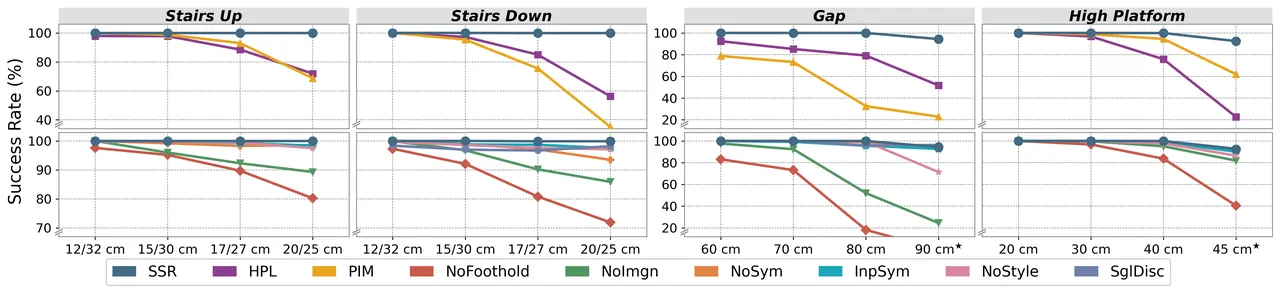
图 3:仿真中各地形、各难度下的通行成功率。上排为与已有方法对比,下排为消融;星号标记超出训练课程的难度。
落脚安全性用两个指标衡量:安全落脚率 SFR(支撑比高于 75% 的落脚占比)与平均支撑比 MSR。SSR 在所有地形上 SFR 最高;在楼梯下行与沟壑这类必须精确落地的地形上,落脚分布被 KDE 平滑后仍集中在有效支撑区内。按每 100 迭代保存的检查点画 MSR 曲线,SSR 最早到达 75% 这条线——想象引导不仅让落脚更稳,还让「学会稳」这件事本身更快。NoImgn 只在触地时刻评估,摆动期的纠正往往推迟到脚已接近地面,接触点仍偏向边缘;NoFoothold 则步态更激进、安全性最低。
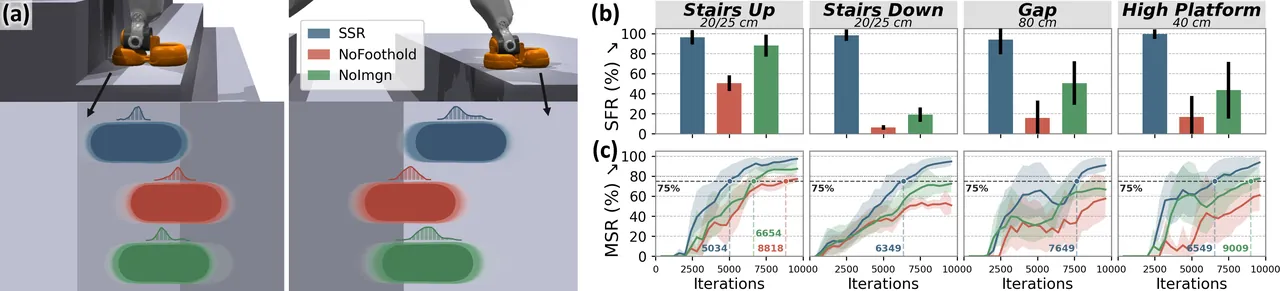
图 4:落脚安全学习消融。(a) 楼梯下行与沟壑上的落脚分布(KDE 平滑);(b) 安全落脚率 SFR;(c) MSR 随训练迭代的变化,虚线标出首次达到 75% 的位置。
对称性消融从三个角度看:八方向线速度指令下的轨迹跟踪、原地转航向指令下的居中能力、以及训练效率。SSR 的轨迹接近镜像对称,原地转向时保持居中;NoSym 累积漂移并出现左右失衡与固定的主导腿。更重要的是,SSR 在沟壑与高台上左右脚都能领步,说明它学到的是双侧技能而非单侧习惯。效率上,与输入级镜像的 InpSym 相比,SSR 在相同训练时间内回报更高、更早到达最高难度,峰值显存从 28.8 GB 降到 23.7 GB(降 18%)——InpSym 因峰值显存超过 24 GB 只能换 48 GB 卡训练,而 SSR 一张 24 GB 的 4090 就够。这正是「把镜像搬到潜空间」的现实意义:对称学习从买不起变成买得起。
类人性用平均功率 AP 与峰值足底接触力 PFCF 两个代理指标衡量:低机械成本与柔和接触是类人步态的特征。下表摘自论文 Table 1,SSR 在四种地形上全面优于去掉风格奖励的 NoStyle 与共享单判别器的 SglDisc,说明按地形拆开的判别器提供了与地形动力学更对齐的运动先验,而不是一个被迫折中的平均风格。
| 方法 | 楼梯上行 AP (W) | 楼梯上行 PFCF (N) | 沟壑 AP (W) | 沟壑 PFCF (N) | 高台 AP (W) | 高台 PFCF (N) |
|---|---|---|---|---|---|---|
| SSR | 381.3 ± 5.4 | 507.7 ± 12.6 | 214.4 ± 5.7 | 463.4 ± 15.3 | 253.0 ± 6.3 | 480.4 ± 14.9 |
| NoStyle | 451.6 ± 10.1 | 538.5 ± 13.5 | 317.0 ± 6.5 | 518.1 ± 16.6 | 292.3 ± 6.3 | 508.7 ± 16.4 |
| SglDisc | 391.8 ± 5.9 | 544.7 ± 9.7 | 241.1 ± 7.4 | 481.8 ± 14.7 | 258.2 ± 5.9 | 505.8 ± 16.4 |
表 1:类人运动消融(均值 ± 标准差)。AP 为平均功率,PFCF 为峰值足底接触力,越低越接近自然步态。
真机零样本部署在 AgiBot X2(29 关节、1.31 m、约 39 kg)上:腰部 RealSense D435i 以 60 Hz 供 640×360 深度,裁剪降采样到 36×36;Jetson AGX Orin 以 ONNX Runtime 50 Hz 推理,与 RK3588 运动控制单元之间是 1 kHz 的 ROS 2 通信。实验室结果如下表:标准设置四种地形全部高成功率,课程之外的 90 cm 沟壑与 45 cm 高台分别为 85% 与 95%,与仿真接近。作者指出,就单一通行策略而言,这些设置属于已公开报道中最难的真实地形等级之一。
| 地形 | 设置 | 成功率(AgiBot X2) | 成功率(DR02,1.8 m / 70 kg) |
|---|---|---|---|
| 楼梯上行 | 15 / 30 cm(X2)、15 / 40 cm(DR02) | 100.0% (20/20) | 100.0% (20/20) |
| 楼梯下行 | 15 / 30 cm(X2)、15 / 40 cm(DR02) | 100.0% (20/20) | 100.0% (20/20) |
| 沟壑 | 80 cm | 95.0% (19/20) | 100.0% (20/20) |
| 高台 | 40 cm(X2)、45 cm(DR02) | 100.0% (20/20) | 95.0% (19/20) |
| 沟壑-难 | 90 cm(超课程) | 85.0% (17/20) | — |
| 高台-难 | 45 cm(超课程) | 95.0% (19/20) | — |
表 2:真机实验室通行成功率,每种地形 20 次试验;右列为同一管线迁移到全尺寸 DEEP Robotics DR02 的跨平台结果。
户外部署是全文最有说服力的一段证据:在工业遗产公园的一条路线上,机器人连续通行 1.3 km、历时 40 分钟,跨越尺寸各异的楼梯、高台、碎石地与草坡,全程无复位、无踩空。三组压力测试进一步刻画鲁棒性:被手推车水平与扭转摇晃、下楼梯时从背后推搡,仍能落在平坦踏面上;草叶遮挡深度时步态无明显退化,并主动绕开观测不良区域;对训练从未见过的穿孔格栅、湿滑手推车、可移动托盘、1.3 m 宽窄的开式踏步楼梯与螺旋楼梯,策略零样本稳定通过。跨平台验证把同一训练与部署管线搬到 1.8 m、70 kg 的 DR02 上,不做任何平台特定算法修改,仍取得上表右列的高成功率——SSR 不与某一具身绑死。
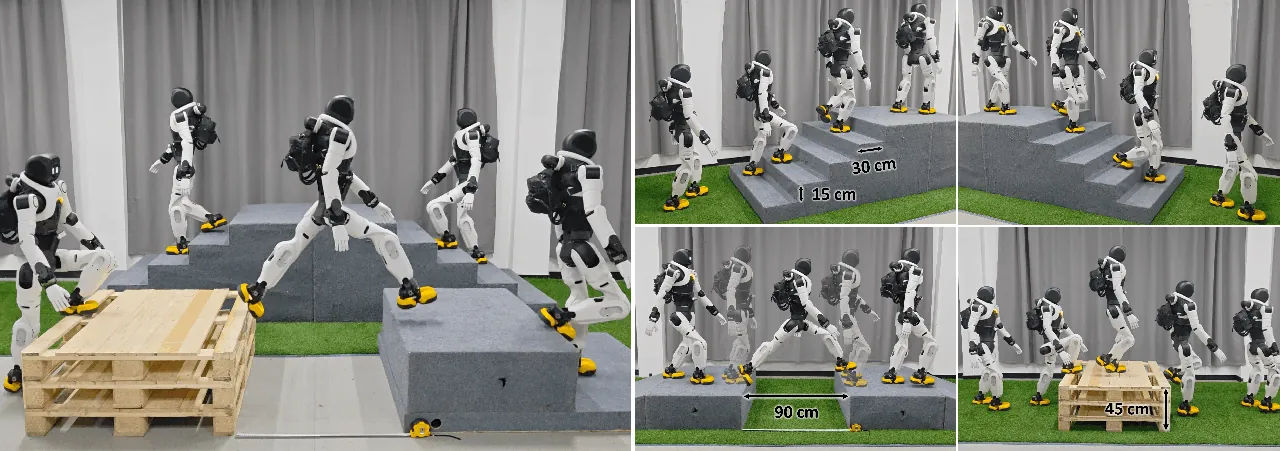
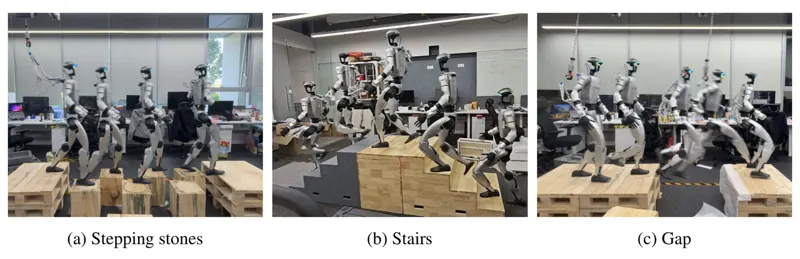
图 5:零样本真机实验室部署关键帧。楼梯通行、90 cm 沟壑跨越与 45 cm 高台攀登,落脚安全且全身动作自然。
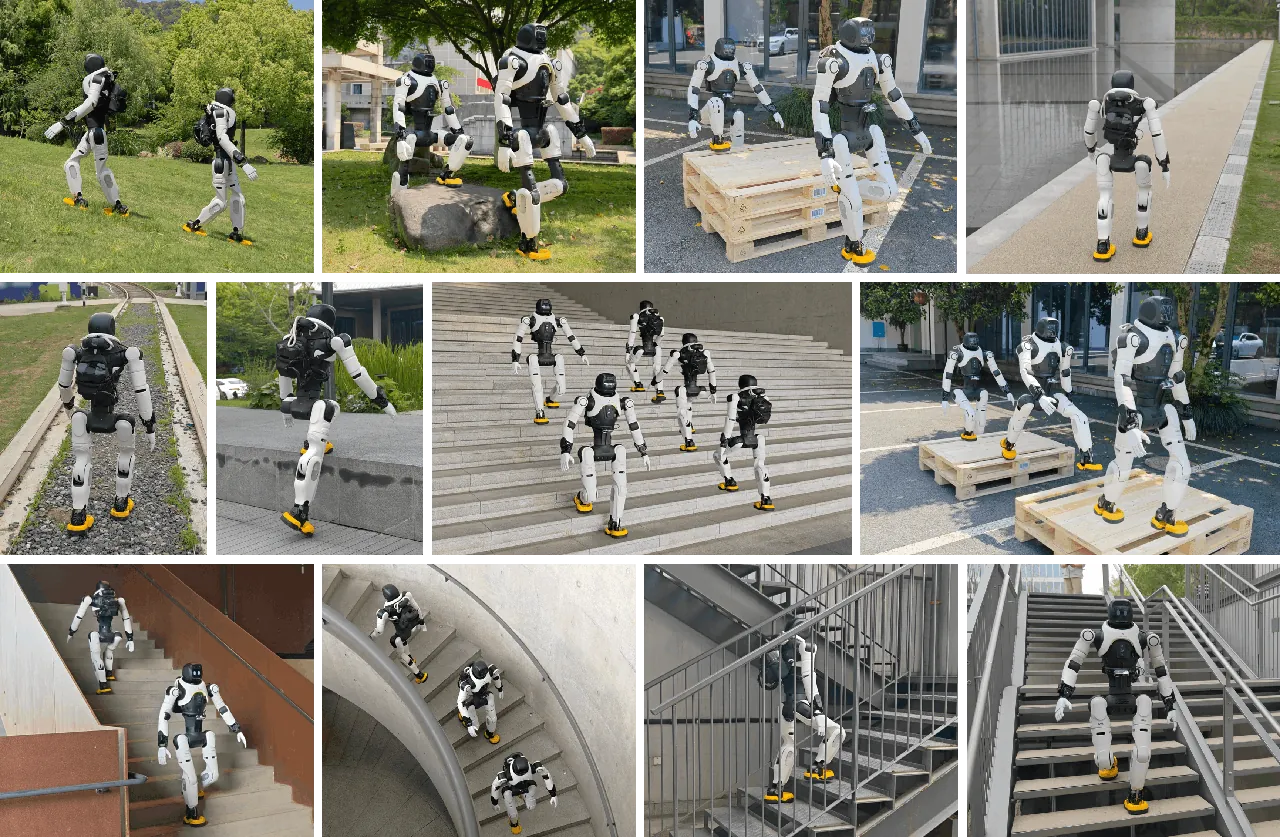
图 6:SSR 在开放世界人类环境中的通行 montage:草坡、尺寸各异的楼梯、高台与宽沟壑,长时程通行中保持安全落脚与协调自然的全身动作。
局限性
作者自述的第一条限制是感知覆盖:固定的前向深度相机只看得到前方,全向通行(例如侧移过窄道、倒退下台阶)因此困难,未来需要多视角感知或主动视点调整。第二条是深度传感的失效模式:尽管策略对草叶遮挡与若干户外 OOD 地形鲁棒,强日照下的镜面反射等严重深度失效仍会扭曲局部几何,需要更鲁棒的感知嵌入。第三条是接触建模的范围:SSR 主要关注脚-地交互,上身接触(扶栏、撑地、搬运中的接触)尚未探索,向多接触技能与更丰富的人体示范扩展是自然的下一步。
除作者自述外,还有两点值得读者留意。其一,长时程户外通行是定性证据:1.3 km 路线只跑了一次,没有重复试验与成功率统计,实验室表格里的数字不能直接外推到这条路线;扰动与遮挡测试同样是演示性质。其二,类人性指标(AP、PFCF)只在仿真中计算,真机侧没有对应的功率或接触力测量,「更像人」这一主张在真机上主要靠视频观感支撑;而 36×36 的深度分辨率虽然换来了机载可行性,也意味着策略对细粒度地形纹理(如湿滑与干燥表面的区分)基本无感知,安全余量更多来自保守的落脚几何而非表面材质理解。
总结与展望
SSR 的贡献不在于某个单点技巧,而在于把三件长期互相挤占的事放回了各自便宜的层级:安全评估前移到摆动期,对称增广下移到潜空间,风格先验按地形拆开。三者共享同一个单阶段 PPO 训练循环,部署时只剩一个编码器-估计器-MoE actor 的策略,机载 50 Hz 可跑。这种「训练期复杂、部署期极简」的结构,是视觉人形控制走向真实开放世界时值得记住的范式。
展望上,论文自己点出的多视角感知、鲁棒深度嵌入与多接触技能,恰好对应开放世界通行的三个剩余缺口:看得全、看得准、用得全身。若想象落脚点引导能与表面材质估计结合、等变潜空间增广能扩展到非对称负载任务(单手提物、扶栏),这套框架距离「在人类环境里像人一样走路」还会再近一步。对工程团队而言,本文最可复用的资产或许是那套与部署一致的自遮挡深度渲染:它让仿真感知与真机传感器同分布,是 sim-to-real 在感知层不裂开的前提。
金句
安全的落脚点不是踩下去之后才知道的,而是在脚还悬空的时候,就已经被想象、被评估、被纠正。