PAPER DEEP DIVE
X-WBC:跨本体人形全身控制基础模型
X-WBC 把人形全身控制重构为跨本体联合训练:以人为中心的命令 token 对齐全身人体动作、机器人参考动作与稀疏 VR 观测,共享因果 Transformer 学习可复用时序结构,轻量本体专属模块负责各机器人的状态与动作映射。九个仿真本体、外部动作与四台真机的实验表明联合训练提升跟踪精度,对齐表示支持跨命令源一致控制。
X-WBC:跨本体人形全身控制基础模型
原标题:X-WBC: A Cross-Embodiment Foundation Model for Humanoid Whole-Body Control
作者:Juntong Zhang、Chun Gu、Li Zhang(通讯作者)
机构:同济大学、复旦大学大数据学院、上海创新研究所
arXiv:arXiv:2609.15213v1(2026-09-14)
会议:CoRL 2026(Austin, Texas)
代码状态:官方仓库 LogosRoboticsGroup/x-wbc 已建立,目前仅托管项目页与发布说明;训练与评估代码、检查点、部署示例在 README 的 Planned Release 清单中仍为未勾选状态,标注「正在准备公开」。项目页 logosroboticsgroup.github.io/x-wbc 提供演示视频。
一句话总结
把「一个机器人训一个策略」换成「九个人形机器人一起训一个共享骨干」:以人为中心的命令 token 对齐全身人体动作、机器人参考动作与稀疏 VR 观测,共享因果 Transformer 学习跨本体可复用的时序运动结构,轻量的本体专属模块负责把共享语义翻译成各机器人可执行的关节动作。
研究背景与动机
人形机器人全身控制(whole-body control, WBC)近几年已经收敛到一种工作范式:用大规模人体动作数据做动作跟踪(motion tracking),把跟踪策略当作遥操作、技能学习与自主行为的低层接口。H2O、OmniH2O、HumanPlus 在这一接口上搭起了 RGB/VR 遥操作与灵巧 loco-manipulation,BeyondMimic 与 SONIC 则把动作跟踪推向可组合行为与「动作基础任务」的规模。这条路线已经证明:只要参考动作足够好,强化学习可以替人手设计出远超规则法的全身行为。
但这些系统的训练单元几乎总是一台机器人。每个平台各自做动作重定向(retargeting)、各自训策略、各自调部署参数,于是 AMASS、LAFAN1、BONES-SEED 这类数据集里宝贵的动作多样性,在进入训练之前就被切成了互不相通的「某机器人专属数据」。一台 H1 学会的踢腿经验,对一台 GR3 没有任何贡献。这与机器人基础模型社区正在发生的事情形成鲜明对照:RT-2、OpenVLA、π0 系列、GR00T 把异构机器人数据当作可扩展的训练混合物,用 Open X-Embodiment、DROID、RoboMIND、AgiBot 等数据集训共享骨干,再用 HPT 的本体感知 stem、CrossFormer 的共享策略、X-VLA 的 soft prompt 这类可训练接口去适配不同本体。
问题是:跨本体共享这件事,能不能搬到闭环的人形全身控制里?操作类基础模型共享的是视觉-语言-动作映射,而 WBC 的共享表示还必须尊重平衡、接触动力学与关节空间控制——摔倒的代价比抓歪一个杯子大得多。论文用一个直觉来切入:人类可以在身高、臂长、力量、关节范围都不同的情况下通过观察学会动作,武术学生不需要和教练拥有完全相同的身体比例,也能理解一次踢腿、转身或下蹲的意图。这说明运动意图存在一种与身体相对无关的表示。
由此得到本文的核心观察:人体动作携带的是相对与本体无关的运动语义,而机器人执行这些语义的方式是本体专属的。走路、踢腿、下蹲、伸手在不同身体之间共享时序结构与几何意图;人形机器人之间的差异主要体现在这些意图如何经由各自的运动学、关节限位、驱动与身体布局变成可执行运动。把同一段人体动作重定向到多台机器人,恰好给出同一意图的多种物理实现——机器人多样性因此不是负担,而是对共享骨干的额外监督。
基于这一观察,X-WBC 把训练单元从「孤立的单机器人策略」改为「多机器人联合动作跟踪」:不同人形机器人的 rollout 混合进同一个 PPO 批次,共同优化一个共享策略骨干;同时用一个以人为中心的命令 token 空间,把全身人体动作、机器人参考动作与稀疏 VR 观测对齐为同一运动意图的三种视图。论文在九个仿真本体、外部动作集与四台真机上验证这一设计。
预备知识
动作跟踪式 WBC 与 PPO。本文把控制问题写成马尔可夫决策过程上的跟踪任务:状态包含机器人本体感知与一条运动命令,动作是关节目标,经低层 PD 控制器转为力矩;训练用 PPO,并采用非对称 actor-critic——critic 额外看到身体连杆位置/朝向与基座线速度等特权信息,actor 只看到可部署的观测。这套配置是当前人形机器人跟踪策略的事实标准。
人体动作数据与重定向。AMASS、LAFAN1、BONES-SEED 提供 mocap 人体动作,SMPL 提供统一的人体模型描述;但人体关节不能直接驱动机器人,需要重定向把人体运动映射到机器人身体空间。论文沿用 GMR 的重定向流程并加入平滑与逐机器人参数,因为 GMR 已证明重定向质量会直接决定跟踪上限,并能给出更干净的机器人参考动作。
跨本体接口。跨本体基础模型的共性做法是「共享骨干 + 可训练的本体接口」:HPT 用本体 stem 把各异观测投影到共享空间,X-VLA 用 soft prompt 区分本体。X-WBC 把同样的思想落到闭环 WBC:共享的是时序运动骨干,本体专属的是命令编码器(机器人路由)、本体感知编码器与动作解码器。
方法详解
3.1 跨本体全身动作跟踪的形式化
论文先给出多机器人跟踪的形式化。每台机器人 $i$ 定义一个 MDP $\mathcal{M}_{i}=(\mathcal{S}_{i},\mathcal{A}_{i},\mathcal{T}_{i},\mathcal{R},\gamma)$:状态空间 $\mathcal{S}_{i}$、动作空间 $\mathcal{A}_{i}$ 与转移动力学 $\mathcal{T}_{i}$ 都是本体专属的,而奖励族 $\mathcal{R}$ 与折扣因子 $\gamma$ 在所有机器人之间共享。共享奖励族是关键约束——它保证不同本体提供的是「可比较的跟踪监督」,否则混合批次里的梯度就没有共同尺度。优化目标在所有机器人的 rollout 上用 PPO 联合求解。
观测采用非对称设计。actor 观测 $s_{t}^{i}$ 由本体感知 $s_{t}^{p,i}$ 与一条运动命令 $s_{t}^{c}$ 组成,其中本体感知为 $s_{t}^{p,i}=(q_{t}^{i},\dot{q}_{t}^{i},\omega_{t}^{i},g_{t}^{i},a_{t-1}^{i})$,即关节位置、关节速度、基座角速度、机体坐标系下的重力投影与上一步动作;命令从机器人参考动作、全身人体动作、稀疏 VR 动作三者中选一。位置、朝向与速度命令默认表达在根节点中心或机器人中心坐标系下。critic 在 actor 观测之外再叠加特权项:机体坐标系下的身体连杆位置与朝向、基座线速度。
动作侧的处理直接服务于「混合批次」。每台机器人的策略输出只在自己动作空间内有效,经 PD 控制器转力矩;由于各机器人观测与动作维度不同,训练时把这些向量 padding 到机器人集合中的最大维度,使不同机器人的 transition 能进同一个批次;执行时本体专属解码器只保留对应机器人的有效动作维。奖励写为 $r_{t}^{i}=\mathcal{R}_{\mathrm{track}}+\mathcal{P}$,跟踪项覆盖根节点朝向、身体连杆姿态与身体速度,惩罚项覆盖动作变化率、关节限位越界与不允许的接触。
附录 A.1 给出了全部奖励项的具体形式,全部是指数型跟踪奖励加指示型惩罚。以根节点位置与身体相对位置为例:
$$r^{\mathrm{root}}_{\mathrm{pos}}(t)=\exp\!\big(-\|\mathbf{p}^{g}_{t,\mathrm{root}}-\mathbf{p}^{p}_{t,\mathrm{root}}\|_{2}^{2}/0.3^{2}\big)$$
$$r^{\mathrm{body}}_{\mathrm{pos}}(t)=\exp\!\big(-\frac{1}{|\mathcal{B}|}\sum_{b\in\mathcal{B}}\|\mathbf{p}^{g,\mathrm{rel}}_{t,b}-\mathbf{p}^{p,\mathrm{rel}}_{t,b}\|_{2}^{2}/0.3^{2}\big)$$
前者衡量根节点位置误差(权重 0.5),后者在跟踪身体集合 $\mathcal{B}$ 上取平均的相对位置误差(权重 1.0);上标 $g$ 是命令参考、$p$ 是机器人当前状态,「rel」表示在命令坐标系下的相对量。惩罚项同样显式,例如关节限位惩罚 $r_{\mathrm{jlim}}(t)=\sum_{j}\mathbf{1}[q_{t,j}\notin[q^{\min}_{j},q^{\max}_{j}]]$ 权重为 -10.0,未允许接触惩罚 $r_{\mathrm{contact}}(t)=\sum_{k\notin\mathcal{C}_{\mathrm{allow}}}\mathbf{1}[\|\mathbf{f}_{k}\|>1.0\,\mathrm{N}]$ 权重为 -0.1。所有机器人共用这一族奖励,正是「共享监督」的具体含义。
3.2 以人为中心的命令编码
命令编码是全文最关键的设计。论文把三条命令路由编码进同一个以人为中心的 token 空间:全身人体动作编码器(共享)把 mocap 全身动作映射为 human motion token,它不绑定任何机器人关节定义,因此充当命令对齐的语义锚点;机器人动作编码器(本体专属)把机器人身体空间中的参考动作映射为 robot motion token,参考通常来自人到机器人的重定向,也可以来自机器人录播、生成动作等其他来源;稀疏 VR 编码器(共享)把稀疏观测映射为 sparse VR token,训练时从全身人体动作中抽取头与四肢端点共五个关键点,部署时同一信号格式可由 VR 设备实时给出。
三条路由在进编码器之前做同样的表示与归一化:目标动作用身体位置、朝向与速度描述,而不是只用机器人关节角;每个身体或关键点贡献 12 维(位置 3 + 6D 朝向 6 + 线速度 3),并在根节点中心或机器人中心坐标系下归一化,使 token 关注相对运动结构、对全局坐标漂移与操作者体型差异保持鲁棒。维度上,全身人体命令为 22 关节 × 12 = 264 维,稀疏 VR 命令为 5 关键点 × 12 = 60 维,机器人命令为 14 身体 × 12 = 168 维。训练时的命令 token 对齐损失鼓励描述同一底层运动的人体、机器人与稀疏 VR token 被共享骨干一致地使用。需要强调的是,稀疏 VR 是一条低带宽控制接口,但它不免除训练期对稠密机器人参考的依赖,也不免除逐机器人的标定与控制配置。
3.3 共享因果 Transformer 骨干与本体专属模块
为什么不用 MLP?多数人形跟踪策略用 MLP 从当前状态与参考动作直接回归动作,这种单步映射在单机器人局部跟踪上够用,但跨本体控制必须从多台机器人、多种命令形式中学到共享的运动结构,而解析运动相位、速度趋势与时间依赖需要历史上下文。因此论文用注意力式的时序骨干处理观测 token 历史。对机器人 $i$,每个控制步先把选中的命令 token $z_{c,t}$ 与本体专属的本体感知 token $z_{p,t}^{i}$ 拼成当前观测 token,因果 Transformer 在长度为 $L$ 的因果历史窗内聚合当前与历史观测 token,输出动作 token:
$$h_{t}^{i}=B_{\theta}\left(\{[z_{c,\tau};z_{p,\tau}^{i}]\}_{\tau=t-L+1}^{t}\right)$$
其中 $B_{\theta}$ 是所有机器人共享的策略骨干,$h_{t}^{i}$ 是当前观测 token 位置上的动作 token 输出。在线 rollout 时用 KV cache 保存历史 token 的键值,每个控制步只处理新观测 token 并更新缓存,而不是重算整个历史窗——这把 32 步历史的代价压到实时控制可接受的范围。网络规格上,actor 与 critic 各有一个独立的 Transformer 骨干:嵌入维 224、深度 3、8 头、头维 32、因果滑窗 32;四个命令/状态编码器是 [256, 256, 64] 的 MLP,actor 融合层与 critic 嵌入层分别是 [128→224] 与 [399→224] 的线性层,输出头为 [224→32] 与 [224→1]。
本体感知编码与动作解码是本体专属的,因为人形机器人在状态维度、关节顺序、驱动限位与动作空间上都不同。与机器人命令编码器一样,这两个模块是按机器人 ID 选择的轻量模块:前者把 padding 后的本体感知观测映射到固定维的本体感知 token,后者把动作 token $h_{t}^{i}$ 映射为机器人 $i$ 的有效关节动作。这一分工让共享 Transformer 专注学习跨本体可复用的运动语义,而把「语义到可执行动作」的翻译留给每台机器人自己的小模块。
flowchart TB
    subgraph CMD["Three command routes of the same motion intent"]
        H[Full human motion
22 joints x 12 = 264 dim]
        R[Robot reference motion
14 bodies x 12 = 168 dim]
        V[Sparse VR observation
5 keypoints x 12 = 60 dim]
    end
    HE[Shared human encoder]
    RE[Robot-specific encoder
routed by robot ID]
    VE[Shared sparse-VR encoder]
    TOK[Aligned command token space
pairwise MSE alignment loss]
    PROP[Robot proprioception
padded to 102 dim]
    PE[Robot-specific proprioception encoder]
    BB[Shared causal Transformer
dim 224, depth 3, heads 8, window 32
KV cache at rollout]
    DEC[Robot-specific action decoder]
    PD[Low-level PD controller
joint targets to torques]
    MIX[Mixed multi-robot PPO batch
1024 envs per robot, 8x H100]
    H --> HE --> TOK
    R --> RE --> TOK
    V --> VE --> TOK
    TOK --> BB
    PROP --> PE --> BB
    BB --> DEC --> PD
    MIX -. joint update .-> BB
    MIX -. joint update .-> DEC
3.4 联合训练
训练在 Isaac Lab 构建的多机器人环境中进行:多台机器人在同一训练框架内 rollout,但各自保留自己的状态、动作、接触与终止逻辑;每个仿真步之后把所有机器人的 transition 收集并混合进同一个 PPO 批次,联合更新共享模块与当步活跃的本体专属模块。对每条动作片段,策略把机器人动作、全身人体动作与稀疏 VR 动作编码成三个命令 token,rollout 开始时按 1:1:1 的比例采样一个,并在整条 episode 内作为骨干输入。训练目标为 PPO 跟踪目标加命令 token 对齐:
$$\mathcal{L}=\mathcal{L}_{\mathrm{PPO}}+\lambda_{\mathrm{align}}\mathcal{L}_{\mathrm{align}}$$
其中 $\mathcal{L}_{\mathrm{PPO}}$ 包含裁剪策略损失、价值回归与熵正则,$\mathcal{L}_{\mathrm{align}}$ 对同一条动作片段产生的三个归一化命令 token 两两计算 MSE,$\lambda_{\mathrm{align}}=1.0$ 且三对 token 等权。终止条件用于剔除明显的跟踪失败:根节点垂直位置误差、根节点朝向误差、末端执行器垂直位置误差超过阈值(训练设为 0.25 m、0.8 rad、0.25 m)即终止 episode,这些失败事件同时为自适应动作采样提供统计。
自适应动作采样沿用跟踪类工作的失败率思路:把动作切成 1 秒的时间 bin,频繁触发提前终止的 bin 提高采样概率,同时保留 0.1 的均匀混合以维持覆盖;由于持续失败也可能意味着重定向坏、接触错误或物理不可行,论文还会把长期低成功率的 bin 从训练池硬移除(失败率 0.98、至少 96 次尝试、至少 32 次触顶、全局 warmup 500 个 PPO 迭代)。域随机化取中等强度:静摩擦 $\mu_{s}\sim\mathcal{U}[0.3,1.6]$、动摩擦 $\mu_{d}\sim\mathcal{U}[0.3,1.2]$、恢复系数 $e\sim\mathcal{U}[0,0.5]$、默认关节位置加 $\mathcal{U}[-0.01,0.01]$ 扰动、基座质心偏移 $\Delta x\sim\mathcal{U}[-0.075,0.075]$ 且 $\Delta y,\Delta z\sim\mathcal{U}[-0.1,0.1]$,并周期性施加根速度推扰($v_{x},v_{y}\sim\mathcal{U}[-0.5,0.5]$、$v_{z}\sim\mathcal{U}[-0.2,0.2]$、持续 1-3 秒)。
规模上,训练使用约 200 小时 BONES-SEED 动作(重采样到 50 Hz),九个本体各 1024 个并行环境,跑在 8 张 NVIDIA H100 上;最终模型训练约两天,控制频率 50 Hz,历史窗 32 步。九个本体覆盖 Unitree G1-29DoF/G1-23DoF/H1/H1-2/R1/H2、Booster T1、Fourier GR3 与 PND Adam Lite,动作维从 19 到 32、身高从 118 cm 到 182 cm、体重从 29 kg 到 71 kg,异构程度足以检验「共享语义 + 专属执行」的分工是否成立。
实验结果
实验分四个层面:策略架构与联合训练、外部动作迁移、命令 token 空间结构、真机部署。训练分布内的评估在 BONES-SEED 训练动作上做(Table 1,评 G1 与 H2),衡量的是架构与拟合行为;外部评估用 100STYLE——一名演员的 100 种行走风格,与八类移动方式组成 800 条片段、133.02 分钟,全部策略权重冻结(Table 2)。评估协议统一:同一 G1 参考轨迹、同一片段窗口、与方法无关的打分;片段在骨盆高度误差超 0.25 m、垂直投影重力分量差超 0.8、或腕/踝高度误差超 0.25 m 时终止;每片段一次确定性 rollout(seed 42、平地、无随机化)。
| 设置 | 命令源 | G1 SR(%) | G1 MPKPE(m) | G1 速度误差(m/s) | H2 SR(%) | H2 MPKPE(m) | H2 速度误差(m/s) |
|---|---|---|---|---|---|---|---|
| X-WBC(共享 Transformer + 联合训练) | VR | 98.60 | 0.0412 | 0.2120 | 93.22 | 0.0629 | 0.4172 |
| X-WBC (MLP 骨干) | VR | 97.70 | 0.0411 | 0.2272 | 91.33 | 0.0652 | 0.4542 |
| Single robot(同架构、逐机器人训练) | VR | 97.69 | 0.0412 | 0.2195 | 92.22 | 0.0698 | 0.4417 |
| X-WBC | Robot | 98.21 | 0.0409 | 0.2164 | 92.08 | 0.0634 | 0.4274 |
| X-WBC | Human | 98.66 | 0.0397 | 0.2098 | 93.02 | 0.0610 | 0.4124 |
| 去掉 human 与 robot 路由 | VR | 95.34 | 0.0492 | 0.2494 | 85.71 | 0.0722 | 0.5016 |
| 去掉对齐损失 | VR | 95.41 | 0.0496 | 0.2469 | 85.68 | 0.0735 | 0.5100 |
| 去掉本体专属模块 | VR | 96.54 | 0.0474 | 0.2241 | 88.65 | 0.0724 | 0.4575 |
架构与联合训练。在 G1 上,X-WBC 成功率 98.60%,高于 MLP 骨干的 97.70% 与逐机器人训练的 97.69%;在更难的 H2 上差距更明显:93.22% 对 91.33% 与 92.22%。完整模型在两台机器人上的身体速度误差也是最低。值得注意的是 G1 的位置误差(MPKPE)三者几乎相同(0.0411-0.0412 m),但成功率与速度跟踪更好——这说明共享 Transformer 带来的主要是闭环稳定性而非单步精度;而 H2 上更大的差距说明在更难的本体上,来自其他机器人的共享监督更值钱。
命令源一致性。同一个完整模型下,VR、机器人动作、全身人体三条路由在训练动作上的成功率非常接近(G1:98.60/98.21/98.66;H2:93.22/92.08/93.02),说明对齐后的编码器确实给共享骨干提供了兼容的输入。人体命令在若干身体指标上略强(G1 MPKPE 0.0397 m),机器人命令的根旋转误差更低(0.3554 rad 对 VR 的 0.4354 rad),因为它本来就处在目标参考空间里;稀疏 VR 只用五个关键点仍能贴近稠密路由,这是它能成为部署接口的直接证据。需要说明:这里的机器人命令是联合训练模型在推理期的输入,而不是一个单独训练的 robot-only 策略。
组件消融。去掉任一或两条稠密命令路由、去掉对齐损失、或去掉本体专属模块,都会降低两台机器人上的训练动作成功率;H2 上掉得最多的是去掉稠密路由(93.22% 降到 83.84%-85.71%)。相对耐人寻味的是「去掉本体专属模块」仍有 96.54%/88.65%——作者据此指出本体感知本身携带了有用的本体信息,专属模块的作用是把这部分信息显式化、结构化。
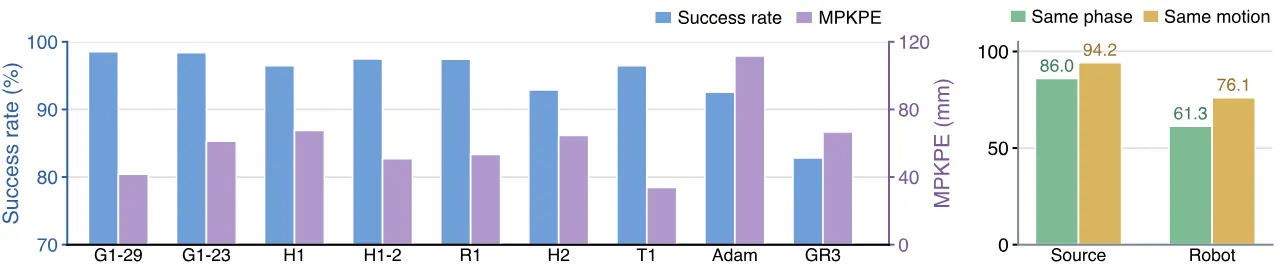
图 3(论文 Figure 3):左为九个本体在稀疏 VR 命令下的训练动作成功率与 MPKPE;右为命令 token 检索 Recall@1。跨源检索同相位 86.0%、同动作 94.2%,跨机器人检索 61.3% 与 76.1%,随机基线仅 0.17% 与 1.04%。
本体覆盖与 token 语义。左图给出共享 Transformer 在九个本体上的训练动作表现:G1-29 与 G1-23 成功率约 98%,H1、H1-2、R1、T1 在 96%-97% 区间,H2 与 Adam 约 93%,最难的 Fourier GR3 约 83%;MPKPE 从 T1 的约 35 mm 到 Adam 的约 115 mm 不等。成功率与 MPKPE 的排名并不一致——前者衡量 rollout 是否避免终止,后者衡量活跃步内的跟踪精度,两者一起报才能区分「活得久」与「跟得准」。右图检验 token 是否保留运动身份:跨源检索(同一运动的不同命令路由)同相位 Recall@1 为 86.0%、同动作 94.2%;跨机器人检索(用 robot motion token)为 61.3% 与 76.1%,显著高于 0.17% 与 1.04% 的随机基线。同动作召回稳定高于同相位召回,说明运动身份比精确时间相位更稳定;跨机器人低于跨源,则说明 token 里仍残留本体专属的执行信息——这既是设计所需(解码要靠它),也说明该空间是「共享语义 + 执行残差」的混合体而非完全本体不变。
| 模型 | 命令源 | SR(%) | 完成率(%) | MPKPE(m) | 速度误差(m/s) |
|---|---|---|---|---|---|
| X-WBC(权重冻结) | VR5 | 91.13 | 91.66 | 0.0649 | 0.5400 |
| SONIC | SMPL | 93.00 | 93.35 | 0.0687 | 0.3419 |
| TWIST | SMPL-GMR | 75.62 | 78.18 | 0.0565 | 0.5261 |
外部动作评估。在完整 800 片段 100STYLE 网格上,冻结权重的 X-WBC 用默认稀疏 VR 接口完成 729 条(91.13%),SONIC 完成 744 条(93.00%),TWIST 完成 605 条(75.62%)。SONIC 的速度误差更低(0.3419 对 0.5400 m/s),TWIST 的 MPKPE 更低(0.0565 对 0.0649 m)但成功率低 15.51 个百分点。由于逐步误差在终止后不再累积,TWIST 的低 MPKPE 必须和它的低完成率一起读:它是在更短的存活窗口里取得的。X-WBC 的取舍是用一点位置误差差距换更广的 rollout 存活,同时成功率贴近 SONIC——而它只用了五个 VR 关键点作为输入,另两者用的是 SMPL 或 SMPL 经 GMR 的稠密输入。
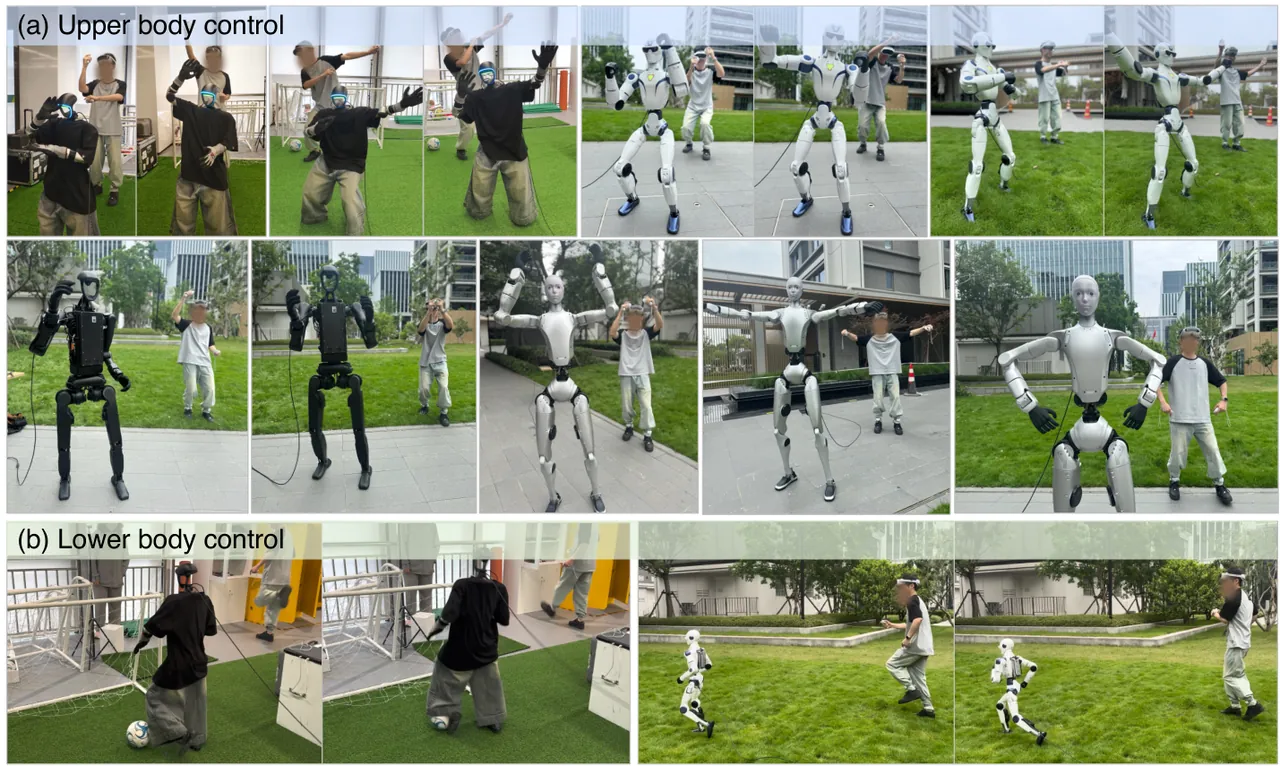
图 4(论文 Figure 4):真机部署。X-WBC 以同一稀疏 VR 接口控制 Unitree G1、R1、H1-2、H2 四台尺寸与关节数差异显著的人形机器人;(a) 为上肢姿态控制,(b) 为踢球与草地跑动。
真机部署。同一策略架构与稀疏 VR 接口部署到 Unitree G1、R1、H1-2 与 H2:操作者使用同一种命令格式,本体专属分支把它映射到各机器人的本体感知与动作空间。演示覆盖上肢姿态与下肢运动(含踢球与草地跑动),说明同一个以人为中心的命令接口与共享骨干可以支撑尺度与运动学结构差异很大的身体。作者同时明确:跨方法的硬件定量对比与跨厂商部署仍留待更广的评估。
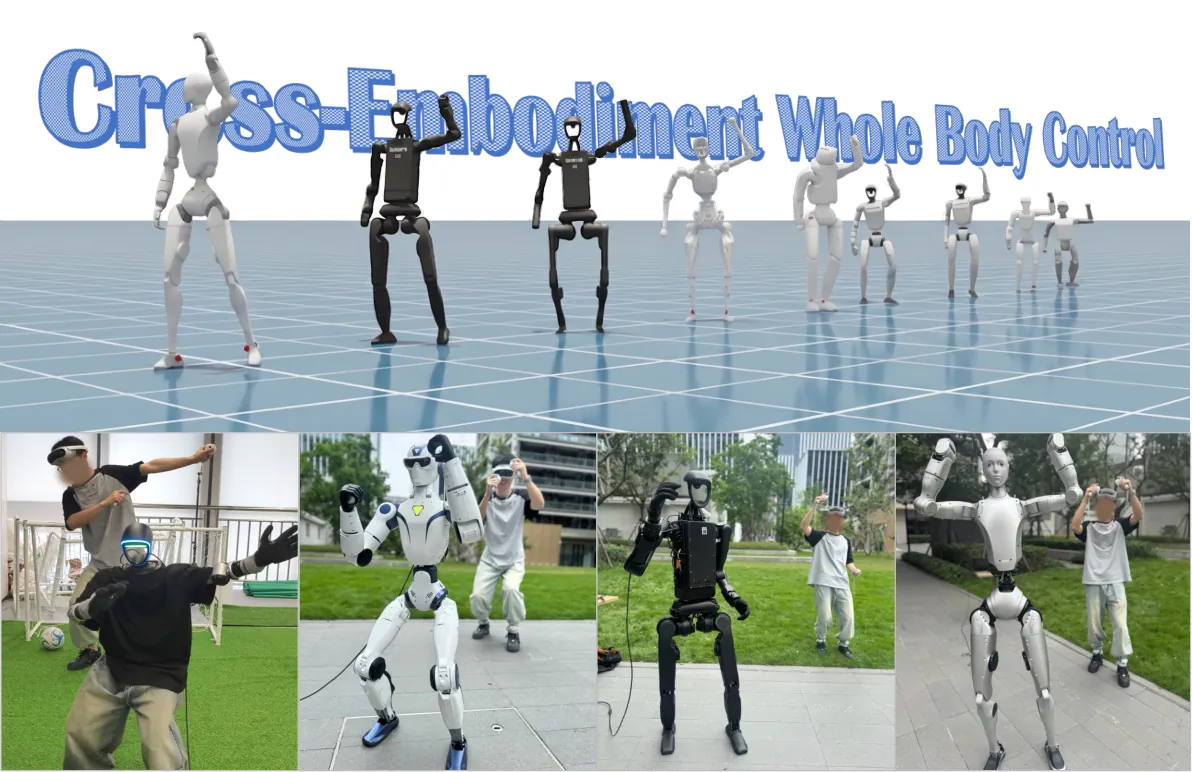
图 1(论文 Figure 1):X-WBC 的概念图。多台人形机器人在仿真中联合训练一个共享全身控制器,共享模块学可复用的人体运动语义,本体专属模块处理与本体相关的执行;真机 VR 遥操作展示跨差异身体的统一「以人为中心」接口。
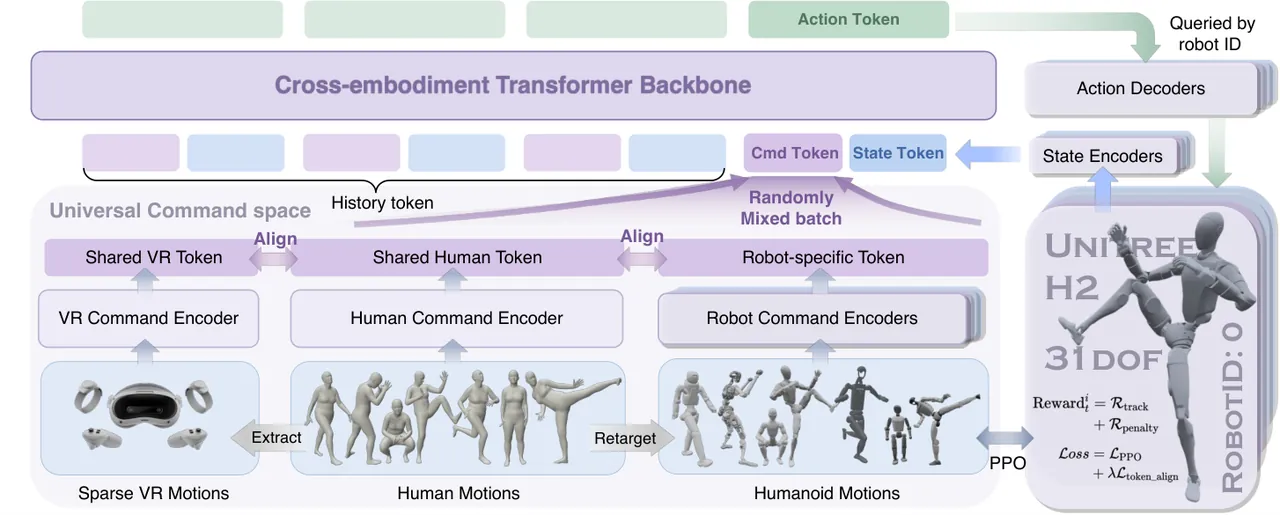
图 2(论文 Figure 2):方法总览。全身人体动作、机器人动作命令与稀疏 VR 命令被编码进共享运动 token 空间;共享 Transformer 骨干把混合 token 批次与机器人本体感知、历史结合;本体专属模块把样本路由到正确的本体接口并解码出可执行关节动作。
局限性
作者自述其一:形态覆盖与本体专属准备。当前研究只覆盖人形机器人,学到的运动表示能否迁到更多样的形态、身体比例与关节布局仍是开放问题;尽管共享骨干累积跨机器人经验,X-WBC 仍需要本体专属的命令/本体感知编码器、动作解码器、控制逻辑与逐机器人重定向来保住各平台可执行的动作空间,这些接口仍是部署管线的一部分。
作者自述其二:硬件证据与鲁棒性。真机验证只在四台 Unitree 机器人与有限的上肢/下肢行为上完成,更广的硬件证据应包含其他厂商、更长任务序列、更多样的接触与地形;对传感 dropout、通信延迟、状态估计噪声与持续扰动的鲁棒性也未系统评估。作者把 zero-shot X-WBC(跨已知本体训练的策略直接控制未见人形、不训新的本体专属模块)列为未来方向,并指出这可能需要从机器人描述直接导出感知与动作映射的 morphology-conditioned 接口。
我们的判断其一:训练分布内的收益不等于泛化。Table 1 评的是 BONES-SEED 训练动作本身,论文明确说它衡量「分布内的架构与拟合行为」;联合训练相对单机器人训练的 +0.91/+1.00 个百分点成功率因此应读作架构与优化层面的证据,而非对未见动作或未见本体的泛化证据。外部评估(Table 2)只覆盖 G1,原因是可用发布检查点只覆盖 G1,且 X-WBC 的速度误差(0.5400 m/s)明显高于 SONIC(0.3419 m/s)——稀疏接口换来了部署便利,也付出了速度跟踪的代价。
我们的判断其二:对齐机制较朴素、缺少敏感性分析。命令对齐只是归一化 token 上的两两 MSE,$\lambda_{\mathrm{align}}$ 固定为 1.0 且三对等权,论文没有给出权重或对齐形式的消融;跨机器人检索 Recall@1 为 61.3%(同相位),低于跨源的 86.0%,说明共享空间并未完全剥离本体信息。这与其说是缺陷不如说是设计取舍(解码需要执行信息),但它意味着「共享语义」的纯度目前只有检索这一个间接度量。
总结与展望
X-WBC 的贡献可以归纳为三层:其一,把人形机器人全身控制的训练单元从孤立单机器人策略改为跨本体联合训练,让不同人形成为同一数据源;其二,给出一个以人为中心的策略架构——对齐的命令 token、共享因果 Transformer 骨干、轻量本体专属模块——把共享运动语义与本体专属执行显式分开;其三,用训练分布内对比、冻结权重的外部动作评估、token 空间检索与四台真机部署,证明联合训练改善跟踪、对齐表示支持跨命令源一致控制、策略在训练语料之外仍具竞争力。
展望上,这篇工作把「多机器人动作跟踪」确立为一条可行的基础任务路线:如果异构人形可以像异构机械臂那样成为联合数据源,那么全身控制经验的积累就不再被平台切割。下一步的关键问题是迁移能力如何随机器人集合规模扩展、本体专属准备能减到多薄,以及 morphology-conditioned 接口能否支撑 zero-shot 控制未见本体——那将是「跨本体基础模型」这一称谓的最终检验。