PAPER DEEP DIVE
TacitVLA:不留推理延迟的推理型VLA
TacitVLA 让动作专家从不关注本次生成的推理文本:训练阶段仍用推理监督塑造骨干表征,部署阶段把记忆台账的生成挪进动作执行窗口。四个基准上与显式推理精度相当而单次调用延迟最多降 3.4 倍,RoboMME 计数 82.7%、RMBench 77.5% 均超过已发表最好成绩。
TacitVLA: Reasoning Vision-Language-Action Models Without Reasoning Latency
Jack Lu、Yurong You、Boyi Li、Yulong Cao、Thomas Tian、Chaowei Xiao、Xiangyu Chen、Wenjie Luo、Boris Ivanovic、Marco Pavone*、Yan Wang*(NVIDIA;另有纽约大学、加州大学伯克利分校、约翰霍普金斯大学、斯坦福大学;* 共同指导,第一作者在 NVIDIA 实习期间完成)
arXiv:2610.17540v1 [cs.AI],提交于 2026-10-13 · arXiv:2610.17540 · 项目页 tacitvla.github.io
代码状态:项目页 Code 一栏写着「Code soon」,截至本文撰写时(2026-10-15)训练与评测代码尚未放出;GitHub 上以 TacitVLA 为名的仓库只有项目页本身(TacitVLA/tacitvla.github.io)。四组策略都只在各基准已公开的演示数据上训练,完整配方(初始化、架构、批大小、学习率、提示词、解码参数、台账协议、每一条已发表对照行的出处)在附录 A 逐项给出,可复现性主要靠这份附录而不是代码。
一句话总结
训练序列、损失、提示词、数据、优化器全部保持不变,只把动作专家对推理 token 的注意力掩掉一格,推理监督带来的性能收益就全部保留下来:TacitVLA 在 RoboMME、RMBench、LIBERO(-Plus)、PhysicalAI-AV 四个基准上都追平自己的显式推理对照组,而单次调用延迟最多低 3.4 倍;在推理文本还要充当记忆台账的长程任务上,台账条目改为在动作执行窗口内异步生成,实测最长一条 180 ms,在所有调用里都没有超出窗口。
一、推理文本在一个策略里同时干三份活
具身思维链(embodied chain-of-thought)这一路的做法是让视觉语言动作模型先输出一段文本——场景描述、计划,或者下一个子任务——再输出动作,实证上强于把观测直接映射到动作的策略(Zawalski et al., 2024),这一模式如今贯穿操作、驾驶与分层策略。本文的第一件事是把这段文本在策略生命周期里承担的角色拆成三份,这个拆分是全文的支点:
(i) 训练期它是一个目标。交叉熵监督塑造骨干的表征,而动作专家正是条件在这份表征上。(ii) 长程任务上它可以充当情景记忆。每生成一个子任务就追加进上下文,记下当前观测已经不再显示的信息,例如按钮已经被按了几下。(iii) 部署期它是一个输入。动作专家条件在本次调用生成的推理文本上,而这段文本是自回归解码出来的,动作必须等解码结束。
延迟的账全部记在第 (iii) 条上。论文给出的实测口径是:在它们为 LIBERO 与 PhysicalAI-AV 训练的推理 VLA 上,生成推理文本占单次调用延迟的 53% 到 70%。换成已有文献的频率尺度更直观——具身思维链策略在同一张 GPU 上跑 0.3 到 0.5 Hz,而同一个架构不做测试期推理能跑 3 到 4 Hz(Chen et al., 2025b);DeepThinkVLA 的混合动作解码把这个差距收窄到 1.4 倍(Yin et al., 2026)。
已有的降延迟路线各有取舍。双系统设计让视觉语言模型以低于控制频率的速率运行、由一个独立控制器跟进(Helix、Fast-in-Slow),但它要么没有消除等待,要么让控制器去执行针对更早观测算出来的结果。跨调用复用可能已经过期的思维链(Fast ECoT)、用隐变量推理替代 token、以及早退、token 缓存、状态空间骨干这些通用 VLA 推理加速手段,做的都是把推理的延迟成本压低,而不是取消「动作之前必须先生成」这件事。
另有一批工作在推理文本上训练、部署时不生成:VLA-OS 的隐式规划、π0.5 不做子任务推理直接部署、ECoT-Lite 的推理预训练与 dropout 配方、ZR-0、ERVLA。它们确立了「推理监督能帮到一个部署时不出文本的策略」这一点,但比较口径都不干净:要么没有显式推理对照组(ZR-0),要么对照同时改了动作解码方式(ERVLA)或训练混合比例(ECoT-Lite),要么是在一个训练时条件在文本上的检查点上直接把生成关掉(π0.5),要么用的是从零训练的小策略(VLA-OS)。语言建模里也有同族证据:只当训练目标用的 rationale 能改善答案(Hsieh et al., 2023),思维链可以被内化(Deng et al., 2023;Hao et al., 2025;Kim et al., 2026)。Fast-WAM 则对「未来视频」问了同一个问题,结论是世界模型的视频预测主要在训练期改善表征,而不是靠测试期真的把未来生成出来。
于是论文把问题收成一句可以证伪的问句,也是项目页的正中标语:动作必须条件在本次推理上,还是学会生成它就够了?如果收益主要经由第 (i) 条通道到达,那么生成推理文本只是增加延迟、并不改善性能;而在推理文本同时充当记忆 (ii) 的任务上,它仍然必须为后续调用生成,但这件事可以发生在动作执行期间,而不是动作之前。
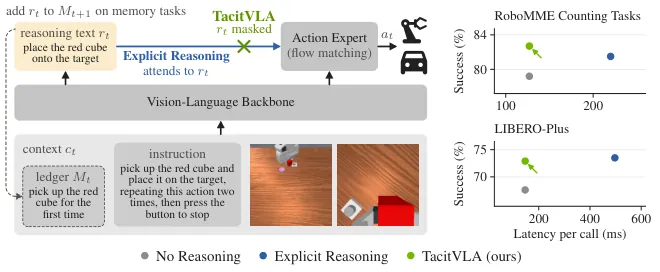
图1(论文 teaser):左半是一次调用里三种策略各自怎么走。给定上下文 $c_t$(记忆任务上还含过往子任务的台账 $M_t$),骨干生成推理 $r_t$ 并条件化输出动作块 $a_t$ 的动作专家;Explicit Reasoning 的动作专家要 attend $r_t$,所以每个动作块都得等它。TacitVLA 在同一条序列上训练,把 $r_t$ 对动作专家掩掉,非记忆任务因此完全不必生成 $r_t$;记忆任务上 $r_t$ 仍会成为下一条台账(虚线回环),但改成在执行期间异步生成。右半是延迟与成功率的对照。
为回答这个问题,论文在每个基准上训练同一架构的三个版本,只在三处不同:动作专家对推理 token 的注意力、有没有推理监督、以及记忆任务上台账条目何时写入。Explicit Reasoning 按具身思维链的部署方式跑,动作专家 attend 刚生成的推理,每个动作块都要等;TacitVLA 在同一条序列上训练,唯一差别是把动作专家对推理 token 的注意力掩掉;No Reasoning 是同架构、去掉推理监督,它的延迟与 TacitVLA 相同,用来量化监督本身值多少分。四个基准按推理文本的用途二分:RoboMME 与 RMBench 是记忆任务,生成的每个子任务成为台账的下一条、被之后每一次调用读取;LIBERO 与 PhysicalAI-AV 是非记忆任务,推理文本只服务当前动作,随后丢弃。
二、共同骨架:一个骨干 + 一个流匹配动作专家
论文研究的是近期推理 VLA 普遍采用的形式:视觉语言骨干生成推理文本,动作专家条件在骨干的表征上(π0.5、Alpamayo-R1、WLA、OneTwoVLA、ZR-0、ERVLA 都属这一族)。一次调用把上下文映射成一个动作块,块的一部分或全部在下次调用到期前被执行掉。第 $t$ 次调用的上下文 $c_t$ 装着指令与观测:相机视图、机器人或车辆状态、策略自己维护的历史;记忆任务上还有一份过往子任务的台账 $M_t$。骨干从中生成推理文本 $r_t$——按基准不同,它是下一个子任务、一段场景描述加计划,或者一条因果链。
动作专家用流匹配在 $K$ 步 Euler 去噪里生成动作块 $a_t$。骨干与动作专家构成 Mixture-of-Transformers:两套权重、一套注意力——动作位置逐层 attend 骨干同层的 key 与 value。两者在同一批样本上联合训练,目标是
$$\mathcal{L}\;=\;\mathcal{L}_{\text{flow-matching}}(a_t)\;+\;\lambda\,\mathcal{L}_{\text{cross-entropy}}(r_t,\tilde{a}_t) \tag{1}$$
其中流匹配项是动作专家在被加噪动作块上的去噪目标,交叉熵项是骨干在推理文本与 $\tilde{a}_t$ 上的下一 token 损失。$\tilde{a}_t$ 是同一个动作块的 token 化形式,由骨干在 $r_t$ 之后预测:操作任务用 FAST+ token(Pertsch et al., 2025),驾驶用轨迹 token。让骨干在 token 化动作上一起训练、而部署的动作只由流匹配专家产出,这个安排沿用 π0.5,token 化动作能加快训练。
动作位置的实现细节值得记下,因为后文那「一格掩码」的差异就发生在这里:动作专家是第二个 transformer stack,沿用骨干的注意力几何但没有词表;在第 $\ell$ 层,它的位置同时 attend 骨干第 $\ell$ 层的 key/value 与自己那一叠,于是两套权重在同一条序列上构成一次注意力。动作位置接着前缀的 position ID 往下排,彼此之间不加因果掩码,一个动作位置对应块里的一个动作。RoboMME 上流匹配的时间步通过 adaptive RMSNorm 注入(同 π0.5),帧采样记忆在两套 stack 的每一层加一次记忆注意力与记忆条件调制;RMBench 与 LIBERO 的动作专家把加噪动作与流时间一起嵌入,再追加一个干净的状态 token;驾驶的动作专家用 Fourier 特征编码每个航点,输出加速度与曲率,由单车模型积分。
规模(附录 Table 7 与 Table 1):RoboMME 3.7B(其中 0.315B 是帧采样记忆,历史帧与当前帧共用同一个冻结的 SigLIP)、RMBench 2.6B、LIBERO 2.5B、PhysicalAI-AV 3.9B。非记忆任务上 Explicit Reasoning 比 TacitVLA 多 0.05B,原因是一个不生成文本的策略(No Reasoning,以及非记忆任务上的 TacitVLA)只需要最后一个语言层的 key 与 value,不需要该层其余部分与最终 norm。
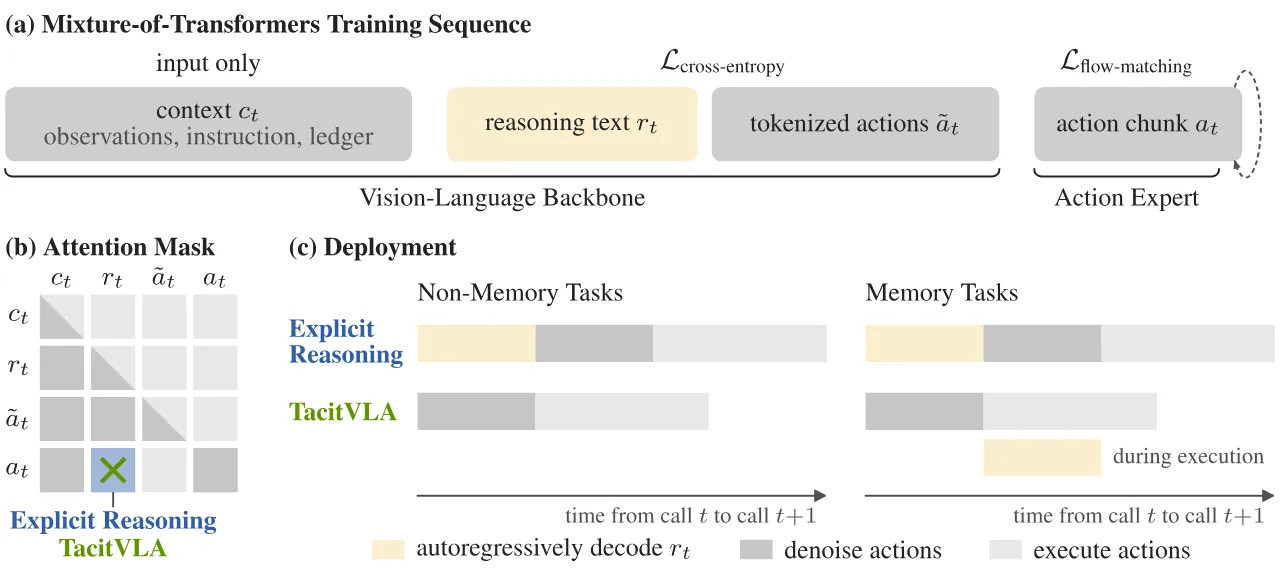
图2(论文 Figure 2):Explicit Reasoning 与 TacitVLA 的训练与部署。两者共享同一条训练序列,差别只有注意力掩码里的一格(图中打叉的那格),正是这一格把 TacitVLA 的动作与文本生成在部署期解耦。(a) 骨干在交叉熵下预测推理 $r_t$ 与 token 化动作 $\tilde{a}_t$(辅助目标),动作专家在流匹配下去噪动作块 $a_t$。(b) 行 attend 列:骨干是因果的,动作专家 attend $c_t$ 与自己的动作块,只有 Explicit Reasoning 还 attend $r_t$,两者都不 attend $\tilde{a}_t$。(c) 非记忆任务上 Explicit Reasoning 必须先生成 $r_t$ 才能去噪与执行;记忆任务上两者都生成台账条目 $r_t$,Explicit Reasoning 在执行前,TacitVLA 在执行中并行。
三、把一次调用的时间拆成三段账
论文用三个时间段描述一次调用。$T_{\text{action}}$ 是动作路径:视觉编码、提示词 prefill、去噪,对三个策略是同三段。$T_{\text{reason}}$ 是显式推理的成本:生成 $r_t$,外加在动作专家条件于它时骨干对这些已生成 token 的那一遍前向。$T_{\text{exec}}$ 是执行窗口:已提交的动作在下次调用到期之前物理执行掉的时间,与真实部署同义。延迟定义为从观测到动作块就绪的时间,于是
$$T_{\text{No Reasoning}}=T_{\text{action}},\qquad T_{\text{Explicit}}=T_{\text{action}}+T_{\text{reason}}$$
记忆任务与非记忆任务在这一式上没有区别:Explicit Reasoning 的动作都要等文本。执行窗口由仿真器自己的控制频率决定:LIBERO 每次调用执行 5 个动作、20 Hz,窗口 250 ms;RoboMME 执行 16 个动作,窗口 800 ms;闭环驾驶在每 100 ms 控制步重规划,一次只执行一个航点。RMBench 没有控制频率——动作是关节位置目标,仿真器把一个 plan 的 32 个目标交给运动规划器,在关节速度与加速度限制下以 4 ms 步长推进物理直到手臂到位,单个目标 218 到 349 ms,一个 plan 的均值按每任务 100 个 case 统计为 6,972 到 11,181 ms。这个窗口比文本生成大一到两个数量级,也是「延迟生成在记忆任务上免费」的物理基础。
四、方法之一:注意力掩码里被挖掉的那一格
两种策略的训练输入是同一条序列:上下文 $c_t$,接推理目标 $r_t$,接 token 化动作 $\tilde{a}_t$,末尾是留给动作专家的动作块占位位置。Eq.(1) 的损失、提示词、数据、优化器全部相同,唯一差别是动作位置的注意力模式:
$$\text{Explicit:}\quad \pi\bigl(a_t\mid c_t,r_t\bigr),\qquad \text{动作专家 attend } c_t \text{ 与 } r_t \tag{2}$$
$$\text{TacitVLA:}\quad \pi\bigl(a_t\mid c_t\bigr),\qquad \text{动作专家只 attend } c_t \tag{3}$$
推理因此有两条通道能到达动作:一条是推理文本上的交叉熵训练了骨干、而动作专家条件在骨干表征上;另一条是动作专家直接 attend $r_t$ 本身。Explicit Reasoning 两条都有,TacitVLA 只有第一条,No Reasoning 两条都没有——于是「TacitVLA 对 No Reasoning」隔离出第一条通道,「TacitVLA 对 Explicit Reasoning」隔离出第二条。这是全文最干净的一处论证设计。
支撑它的关键判断是一句关于信息量的话:部署时 Explicit Reasoning 的 $r_t$ 也是仅从 $c_t$ 生成的,所以第二条通道增加的是计算量,而不是信息量。四个基准上 TacitVLA 都追平 Explicit Reasoning,意味着这份额外计算买不到性能。反过来说,如果某个任务上第二条通道确实携带信息(例如推理文本里出现了骨干表征没能编码的内容),TacitVLA 就会掉分——论文用四个基准、两套训练规模、一次 $\lambda$ 扫描去检验这件事没有发生。
还有一点常被忽略:两种模式都是加在同一条共享序列上的掩码,序列形状完全一致,所以这个对照不是「换了一个模型」,而是「换了注意力里的一格」。附带的好处是 TacitVLA 每次更新的训练算力略低于 Explicit Reasoning(它的动作位置不 attend $r_t$),而 No Reasoning 的序列不带推理文本,最便宜。
五、方法之二:把文本生成推迟进执行窗口
非记忆任务上,部署期没有任何东西消费 $r_t$,TacitVLA 干脆不生成它,延迟就是 $T_{\text{action}}$,与 No Reasoning 逐毫秒一致。记忆任务上,TacitVLA 先算动作、后写台账:第 $t$ 次调用时动作专家从 $c_t$ 出发行动,而 $c_t$ 已经包含 $M_t$;机器人执行这个动作块的同时,骨干生成 $r_t$,它像 Explicit Reasoning 一样进入台账、供第 $t+1$ 次调用读取。台账的更新式是
$$M_{t+1}=M_t\oplus r_t$$
生成只有在超出执行窗口时才会推迟下一次调用,而且只推迟超出的那部分:
$$T_{\text{Tacit}}=T_{\text{action}}+\max\bigl(0,\;T_{\text{reason}}-T_{\text{exec}}\bigr) \tag{4}$$
台账语义(附录 A)是这套设计成立的前提,论文写得很细:RoboMME 上每次调用生成一句子任务,用基准自带的 simple subgoal 标注、不带 grounded 变体里的图像坐标;一条条目只有在它对应的 16 动作块执行完之后才进台账,所以第一条出现在第二次调用;相邻重复条目被删除;台账按 episode 重置、从不截断。Explicit Reasoning 在它所要条件的那个动作之前生成条目,TacitVLA 在算完动作之后生成,但两者在同一个边界上追加,因此后续每一次调用读到的台账是在同一份协议下建起来的。两种策略的条目都只写「正在做的子任务」、不写结果:一次失败的抓取照样留下它的条目,计数靠下一次调用重新生成同一个子任务来自我修正。RMBench 上每个 32 动作 plan 贪心解码下一条子任务。
部署实现上,延迟生成复用动作路径已经建好的 KV cache 继续解码;如果下一个观测到达时它还没写完,下一次调用就等它,也就是 Eq.(4) 的第二项生效。训练时台账前缀是标注好的子任务序列,部署时是模型自己生成的——这份 train/deploy 偏移 Explicit Reasoning 同样要面对,不是 TacitVLA 独有的账,但它确实是「延迟生成是否安全」的真正风险点:错的条目会留在台账里被后续每一次调用读到。
flowchart TD
    C[上下文 c_t 指令 观测 记忆任务还含台账 M_t] --> PF[骨干 prefill 建 KV cache]
    PF --> A1[Explicit 自回归生成 r_t
RoboMME 93 ms LIBERO 345 ms 驾驶 143 ms]
    A1 --> A2[骨干再过一遍已生成 token 5 到 8 ms]
    A2 --> A3[流匹配去噪 K 步 Euler
动作专家 attend c_t 与 r_t]
    A3 --> A4[动作块就绪 T_action + T_reason
220 ms 495 ms 269 ms]
    A4 --> A5[执行动作块 窗口 T_exec]
    PF --> B1[Tacit 流匹配去噪
动作专家只 attend c_t 掩掉 r_t 那一格]
    B1 --> B2[动作块就绪 T_action
127 ms 147 ms 127 ms]
    B2 --> B3[执行动作块 窗口 800 ms 到 11181 ms]
    B2 -->|记忆任务 复用同一份 KV cache| B4[异步生成台账条目 r_t
实测最长 180 ms 最多占窗口 23%]
    B4 --> B5[在同一边界追加 M_t+1 = M_t + r_t]
    B3 --> B6[下一次调用不等生成]
    B5 --> B6
    B2 -->|非记忆任务 无人消费 r_t| B7[完全不生成文本]
六、实验设置:四个基准、三次训练、一份配方
比较在四个基准上进行,两个记忆、两个非记忆(表1)。每一行是一个架构,在同一份数据上训练三次,分别作为 No Reasoning、Explicit Reasoning、TacitVLA。在记忆任务上,No Reasoning 因此衡量的是「推理监督 + 台账」的联合价值——它连台账都不带。
| 基准 | 任务类型 | 推理文本 | 骨干 | 规模 | 观测与动作(附录 Table 10) |
|---|---|---|---|---|---|
| RoboMME | 记忆 | 下一个子任务 | PaliGemma(π0.5) | 3.7B | 前视 + 腕部视图、至多 32 帧采样历史;预测 20 个动作(32 维,8 维有效),执行 16 个,10 步 Euler |
| RMBench | 记忆 | 下一个子任务 | RynnBrain-2B | 2.6B | 首帧、32 动作前的头部帧、当前头/左/右三视图;预测 32 个 14 维目标并全部执行,32 步 Euler |
| LIBERO(+Plus) | 非记忆 | 场景描述与计划 | RynnBrain-2B | 2.5B | agent 与腕部图像、8 步前的 agent 图像;预测 10 个 7 维动作,执行 5 个,32 步 Euler |
| PhysicalAI-AV | 非记忆 | 因果链 | Qwen3-VL-2B | 3.9B | 两路前向相机各 4 帧(10 Hz)、16 个历史 ego 状态;预测 64 个航点 / 6.4 s,闭环每 100 ms 执行 1 个 |
表1:四个基准与三种策略的共同配置(整理自论文 Table 1 与 Table 10)。规模是 TacitVLA 的总参数量,含动作专家。
四个基准各自的口径:RoboMME 是 16 任务记忆基准,其中 4 个计数任务要求数清重复动作或事件;它的作者发现感知记忆与符号记忆互补并建议合并,本文就在一个骨干里合并——所有策略在 16 个任务上都带基准自带的感知记忆 FrameSamp 及其 modulator,推理策略只在计数任务上加台账,用基准的 simple subgoal 标注训练;策略分别「只在 4 个计数任务上训练」与「在全部 16 个任务上训练」两套。RMBench 测长操作 episode 上的记忆,本文用其 9 个任务中 WLA-0 报告过的那 4 个,每任务 100 个 case:Blocks Ranking Try、Battery Try、Press Button、Cover Blocks。LIBERO 是 4 个 10 任务套件的标准操作基准,推理标注用 DeepThinkVLA 发布的版本;为测分布外鲁棒性另评 LIBERO-Plus,7 个扰动轴、10,030 个 case、zero-shot。PhysicalAI-AV 在一份 380 万驾驶事件的专有语料上训练,标注是 Alpamayo-R1 风格的因果链;开环在公开发布版的 1,434 段留出片段上评测,闭环在 AlpaSim 驾驶挑战赛的 441 场景公开分组上跑,20 s rollout、10 Hz、每场景 3 次,失败 rollout 计为失败,路线不是模型输入。
训练配置(附录 Table 9):全部用 AdamW,节点是 8×H100。RoboMME 批 64、峰值学习率 $5\times10^{-5}$、warmup 5k(计数)/10k(16 任务)、更新 60k/80k,warmup 后学习率恒定;RMBench 与 LIBERO 批 512、学习率分视觉塔/语言模型/动作专家为 $5\times10^{-6}$ / $5\times10^{-5}$ / $2\times10^{-4}$,cosine 衰减到峰值的 10%,更新 80k/40k,每样本 16 次噪声采样;驾驶批 256、$1\times10^{-5}$ / $1\times10^{-4}$ / $4\times10^{-4}$,衰减到 1%,更新 100k。Eq.(1) 的交叉熵权重 $\lambda$ 在 LIBERO 与驾驶上是 0.1、在 RMBench 上是 1.0,RoboMME 上每个策略在 $\lambda\in\{0.1,0.01,0.001\}$ 三个值上各训一次并报告其最好成绩。同一个 $\lambda$ 在所有策略里都缩放 token 化动作那一项,在 No Reasoning 里它只缩放这一项。动作专家回传到骨干的梯度在 RMBench 与 LIBERO 上 2k 步后开启、驾驶上 4k warmup 之后开启、RoboMME 上从头开启。
评测口径同样统一:三个机器人基准只用各自公开的演示数据训练,成功率是三个评测种子的均值 ± 标准差,走各基准官方协议与 case;机器人在提示词上区分「推理示例」与「直接示例」,推理提示多一个固定 cue,LIBERO 的 201 个无标注演示只用直接提示做动作监督;三个机器人基准上推理文本贪心解码,上限 128 token(RoboMME)或 256 token(RMBench、LIBERO),驾驶上以温度 0.6、top-p 0.98 采样;开环 minADE 是 6 条采样轨迹里平均位移误差的最小值。三个策略跑同一套推理实现,计时都在一张 H100 上。
七、RoboMME:执行期间生成的台账保住了全部收益
只在计数套件上训练、在其 4 个任务(200 case)上评测时,TacitVLA 得 89.5,Explicit Reasoning 得 86.7,No Reasoning 得 79.0(表2)。基准的人类参考是 88.5——而那份参考里人类只负责选择每个高层动作,由一个不会出错的 oracle planner 执行;TacitVLA 还得自己把每个动作做出来。推理监督给 TacitVLA 加了 10.5 分、给 Explicit Reasoning 加了 7.7 分,也就是说在执行期间生成的一条台账,保住了在动作之前生成的全部收益。
在全部 16 个任务上训练时(表2 右半),三个策略的全任务成绩是 46.5、45.8、48.1,对照基准已发表的最好成绩 FrameSamp + Modulator 的 44.5。计数任务上 TacitVLA 的 82.7 比已发表最好的 FrameSamp + Expert(66.8)高 15.9 分,与拿到仿真器真值子目标的两行 oracle-subgoal 结果(83.9 与 82.6)相差 1.2 分以内,也高于那些额外跑第二个视觉语言模型来生成子目标的符号系统(38.0 到 48.8)。
| 策略 | 计数套件训练 Counting(200 case) | 16 任务训练 Counting | 16 任务训练 Permanence | 16 任务训练 Reference | 16 任务训练 Imitation | 16 任务训练 全任务(800 case) |
|---|---|---|---|---|---|---|
| 人类(oracle planner) | 88.5 | — | ||||
| π0.5(已发表) | — | 28.8 | 17.0 | 17.2 | 8.8 | 17.9 |
| MemER(已发表) | — | 48.8 | 53.2 | 38.0 | 29.5 | 42.4 |
| FrameSamp + Expert(已发表) | — | 66.8 | 25.2 | 24.1 | 28.9 | 36.3 |
| FrameSamp + Modulator(已发表最好) | — | 65.2 | 25.1 | 36.3 | 51.4 | 44.5 |
| No Reasoning(本文) | 79.0 ± 1.0 | 79.2 ± 1.0 | 23.8 ± 2.6 | 35.2 ± 2.0 | 48.0 ± 1.0 | 46.5 ± 0.9 |
| Explicit Reasoning(本文) | 86.7 ± 2.0 | 81.5 ± 1.8 | 26.8 ± 0.6 | 27.7 ± 2.0 | 47.0 ± 2.6 | 45.8 ± 1.5 |
| TacitVLA(本文) | 89.5 ± 1.3 | 82.7 ± 3.8 | 23.8 ± 3.1 | 37.8 ± 2.9 | 48.0 ± 1.5 | 48.1 ± 1.0 |
表2:RoboMME 成功率(%)。左列是只在计数套件上训练的策略,右侧五列是在全部 16 个任务上训练的策略;只有计数任务带推理监督。本文三行是三个评测种子的均值 ± 标准差,已发表行按原文照抄(整理自论文 Table 2 与 Table 3)。
$\lambda$ 扫描(论文 Table 11)给出一个不那么舒服但更完整的画面:计数套件上 No Reasoning 是 77.3 / 79.0 / 74.5($\lambda=0.1$ / 0.01 / 0.001),Explicit Reasoning 是 86.7 / 84.7 / 73.0,TacitVLA 是 85.5 / 89.5 / 82.5;16 任务上分别是 43.6 / 46.5 / 44.0、43.5 / 45.8 / 43.8、44.0 / 47.6 / 48.1。TacitVLA 在全部六种设置里都高于 No Reasoning,在五种设置里是三个策略中最好的,第六种(计数套件 $\lambda=0.1$)比 Explicit Reasoning 低 1.2 分。要注意的是论文报告的主表数字是每个策略在三个 $\lambda$ 里的最好成绩,而三个策略的最优 $\lambda$ 并不相同(Explicit Reasoning 在 $\lambda=0.1$ 最好,TacitVLA 在 16 任务上 $\lambda=0.001$ 最好),这等于给每个策略都做了一次小规模超参选择。
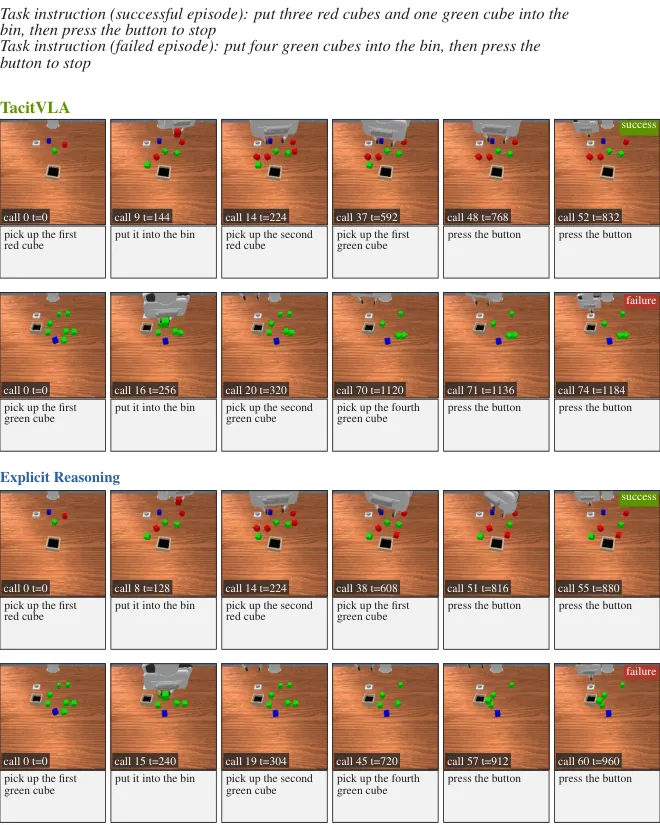
图3(论文 Figure 4):RoboMME BinFill 的前视相机画面,取在生成新台账条目的那些调用与 episode 的最后一次调用上,用的是表2 左列那套只在计数套件上训练的策略。台账条目只记「正在做的子任务」,不记结果。
八、RMBench:只存在于台账里的那个计数
RMBench 的四个任务里,Blocks Ranking Try、Battery Try、Cover Blocks 上三个策略彼此相差不超过 1 分;差别集中在 Press Button——按了几次这件事只存在于台账里,当前观测看不出来。No Reasoning 得 7.7,Explicit Reasoning 得 73.3,TacitVLA 得 74.3(表3)。两个推理策略在 99.7% 的 episode 里都维持了正确的台账。四任务均值是 60.4、77.0、77.5,三者都高于 WLA-0 的四任务均值 56.5,TacitVLA 相对 No Reasoning 提升 17.1 分,正是摘要里那个「+17.1%」。
| 策略 | Blocks Ranking Try | Battery Try | Press Button | Cover Blocks | 四任务均值 | 台账正确率(Press Button) |
|---|---|---|---|---|---|---|
| DP / ACT / π0.5 / X-VLA(已发表) | 10 / 0 / 6 / 1 | 10 / 19 / 16 / 26 | 0 / 0 / 0 / 0 | 0 / 0 / 0 / 2 | 5.0 / 4.8 / 5.5 / 7.3 | — |
| MemER(已发表) | 0 | 27 | 0 | 6 | 8.3 | — |
| QwenOFT / HiMem-WAM(已发表) | 37 / 24 | 14 / 28 | 0 / 8 | 0 / 19 | 12.8 / 19.8 | — |
| MemoryVLA(QwenOFT,已发表) | 53 | 33 | 0 | 69 | 38.8 | — |
| EventVLA(已发表) | 81 | 35 | 3 | 97 | 54.0 | — |
| WLA-0(已发表最好) | 23 | 45 | 74 | 84 | 56.5 | — |
| No Reasoning(本文) | 94.3 ± 2.5 | 42.0 ± 1.7 | 7.7 ± 2.1 | 97.7 ± 2.1 | 60.4 ± 1.5 | — |
| Explicit Reasoning(本文) | 94.3 ± 1.2 | 42.3 ± 1.5 | 73.3 ± 2.5 | 98.0 ± 1.0 | 77.0 ± 1.9 | 99.7 |
| TacitVLA(本文) | 94.7 ± 1.5 | 43.0 ± 2.6 | 74.3 ± 2.5 | 98.0 ± 1.0 | 77.5 ± 1.1 | 99.7 |
表3:RMBench 成功率(%),每任务 100 个 case(整理自论文 Table 4 与 Table 14)。台账正确率是「最终生成的台账与被要求的计数一致」的 episode 占比;RoboMME 侧同一张表里 BinFill 是 90.0(Explicit)对 92.0(Tacit),PickXtimes 与 SwingXtimes 两者都是 100.0。
台账正确率是这篇论文里最该被单独看的一组数字,因为延迟生成的安全性完全押在它上面:如果异步写出的条目更容易错,错误就会被后续每一次调用读到并累积。论文的结论是两者在每个任务上相差不到 2 分,而且 TacitVLA 在 Press Button 上的每一次失败都是耗尽步数预算、物理按压次数没达标,台账本身是对的。这句限定很重要——失败发生在执行侧,不在记忆侧。
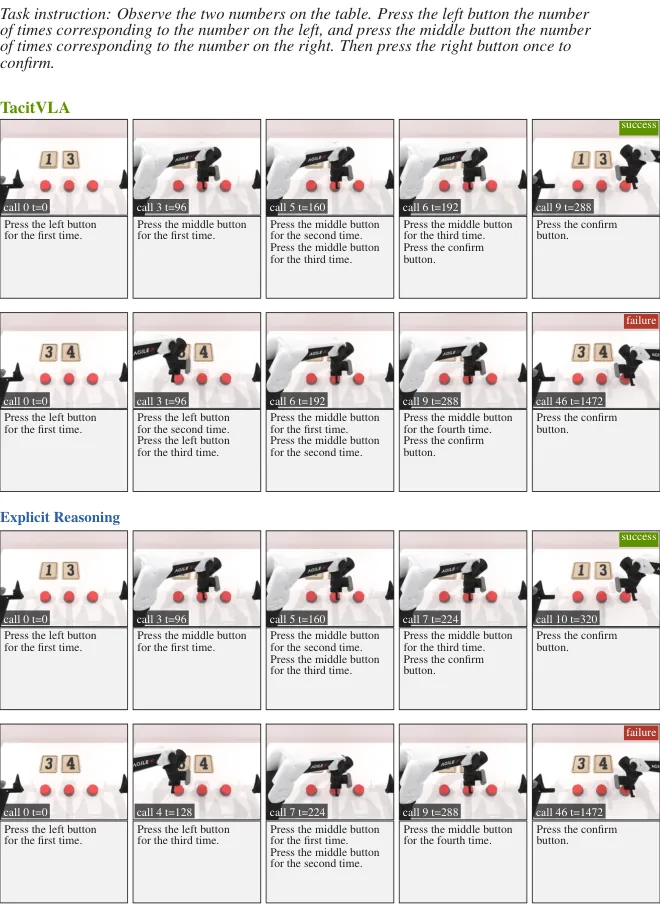
图4(论文 Figure 5):RMBench Press Button 的头部相机画面,取在生成新台账条目的调用与最后一次调用上。一次调用可以写入两条条目,因为一次按压可能在同一个动作块里完成。
九、LIBERO 与 LIBERO-Plus:一行文本都不生成,却涨了 5.3 分
LIBERO-Plus 上,推理监督把成功率从 No Reasoning 的 67.6 抬到 Explicit Reasoning 的 73.5,TacitVLA 得 72.9,与 Explicit Reasoning 相差不到 1 分、比 No Reasoning 高 5.3 分。四个标准套件已接近饱和,三个策略是 98.5、98.1、98.6,彼此以及与 WLA-0 的 98.6 都在 1 分以内。这里的关键是:TacitVLA 在这个基准上部署时不生成任何文本,所以这 5.3 分只能通过表征这一条通道到达动作。
与同样只用 LIBERO 演示数据训练、已发表的策略相比,两个推理策略占据 LIBERO-Plus 榜上最高的两个位置:MergeVLA 72.4、Evo-Depth 69.6、π0.5(LIT 复现的基线)69.0、LoopOFT α 65.8、MolmoAct2 63.6、MolmoAct† 60.8、VLA-Adapter 59.1、DreamVLA 48.9。同骨干类别、不带推理监督的策略与本文 No Reasoning 的 67.6 接近——LoopVLA 的 Qwen3-VL-2B 加直接动作 MLP 基线是 68.8,LIT 的 π0.5 基线是 69.0——所以 No Reasoning 是它那一类里称职的策略,抬高它的是推理监督。论文明确把带机器人动作预训练的系统(DeepThinkVLA 79.0)与参数量显著更大的系统(VLA-GSE 81.2、FoMoVLA 80.5)排除在这个对齐比较之外,这条边界画得比多数论文清楚。
| 策略 | Robot init. | Sensor | Camera | Language | Objects | Background | Light | LIBERO-Plus 全部 | 标准四套件均值 |
|---|---|---|---|---|---|---|---|---|---|
| case 数 | 1,550 | 1,601 | 1,599 | 1,537 | 1,525 | 1,076 | 1,142 | 10,030 | 2,000 |
| No Reasoning | 59.7 ± 1.1 | 51.7 ± 1.1 | 41.0 ± 1.1 | 76.6 ± 0.9 | 73.2 ± 1.0 | 92.9 ± 0.7 | 94.0 ± 0.6 | 67.6 ± 0.4 | 98.5 ± 0.3 |
| Explicit Reasoning | 71.1 ± 0.8 | 51.1 ± 0.9 | 51.5 ± 0.9 | 83.7 ± 0.6 | 78.3 ± 0.7 | 97.2 ± 0.3 | 96.8 ± 0.4 | 73.5 ± 0.3 | 98.1 ± 0.4 |
| TacitVLA | 69.9 ± 0.8 | 60.0 ± 0.8 | 42.2 ± 0.8 | 83.0 ± 0.6 | 77.1 ± 0.7 | 98.0 ± 0.3 | 95.4 ± 0.4 | 72.9 ± 0.3 | 98.6 ± 0.3 |
表4:LIBERO-Plus 按七个扰动轴拆分,以及标准四套件(整理自论文 Table 12 与 Table 13;标准套件逐套为 Spatial 99.2 / 98.4 / 99.2、Object 99.6 / 99.8 / 100.0、Goal 98.8 / 97.8 / 98.0、Long 96.4 / 96.4 / 97.2)。
逐轴看,相对 No Reasoning 增益最大的是机器人初始状态被改变这一轴:Explicit Reasoning +11.4 分、TacitVLA +10.2 分。但两个推理策略在轴上的胜负并不一致:TacitVLA 在 Sensor 轴上反而比 Explicit Reasoning 高 8.9 分(60.0 对 51.1),在 Camera 轴上低 9.3 分(42.2 对 51.5)。论文没有解释这两处的反向差异,而它们的绝对量都大于两者在总分上的 0.6 分差距——换句话说,总分上的「追平」是几处方向相反的偏差相互抵消的结果,而不是逐轴一致。三个评测种子的标准差在 0.8 分左右,不足以判定这两处差异是噪声还是真实效应。
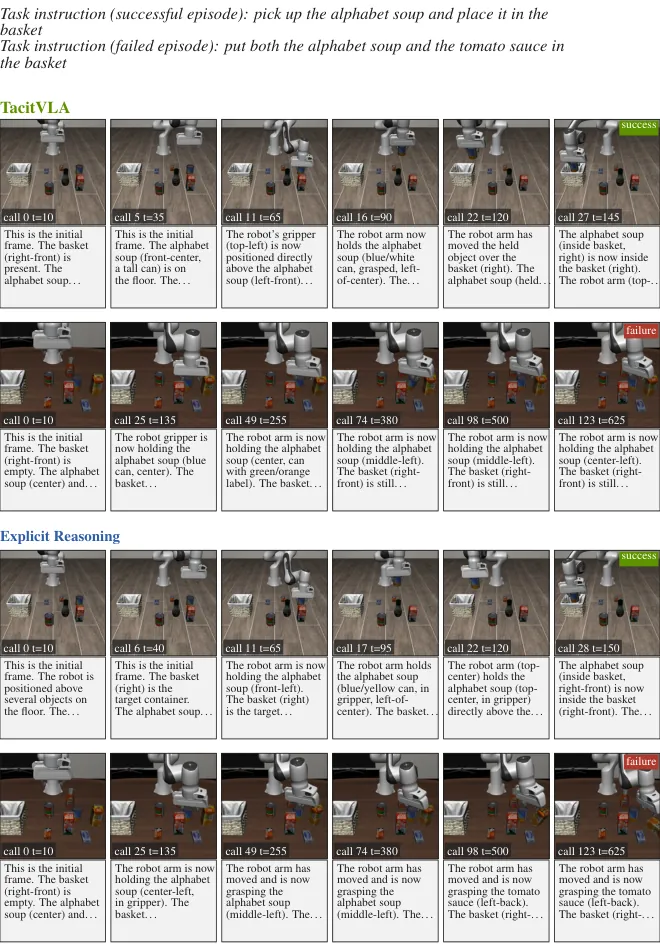
图5(论文 Figure 6):LIBERO 的 agent 相机在六次调用上的画面,附每次调用生成的推理文本开头,用的是表4 那套策略。非记忆任务上 TacitVLA 部署时不生成这些文本,图中它的那一行来自训练期的推理监督。
十、PhysicalAI-AV:把同一套论证搬到闭环驾驶
三个策略在驾驶语料上训练、在与训练不相交的场景上评测。开环上两个推理策略都把位移误差压到 No Reasoning 的 1.166 m 之下:Explicit Reasoning 1.140 m,TacitVLA 1.116 m。闭环上 TacitVLA 的场景分是 52.5%、Explicit Reasoning 52.3%、No Reasoning 46.4%,两个推理策略都通过了更多场景、造成更少的有责碰撞。
参照系是这样的:在同一批场景与同一协议下,主办方公布的参考 rollout 里 Alpamayo-R1——一个 10B、四路相机的模型——得 55.0%;VaVAM 在挑战赛控制器下得 11.0%,在一个比赛里拿不到的线性控制器下得 31.4%;五份未署名提交在 5.8% 到 16.8% 之间。TacitVLA 用不到一半的参数量与一半的相机数逼近到 2.5 分以内。
| 策略 | minADE (m) ↓ | 通过率 (%) ↑ | 任意碰撞 (%) ↓ | 有责碰撞 (%) ↓ | 出界 (%) ↓ | 每次违规公里数 ↑ | 场景分 (%) ↑ |
|---|---|---|---|---|---|---|---|
| VaVAM(非线性控制器,已发表) | — | 15.0 ± 0.7 | 24.3 ± 0.6 | 18.0 ± 0.6 | 28.0 ± 1.1 | 0.14 | 11.0 ± 0.7 |
| VaVAM(线性控制器,已发表) | — | 42.1 ± 0.5 | 33.3 ± 0.3 | 16.4 ± 0.7 | 15.2 ± 0.8 | 0.35 | 31.4 ± 0.6 |
| No Reasoning(本文) | 1.166 ± 0.010 | 50.1 ± 2.2 | 16.1 ± 1.3 | 6.9 ± 1.6 | 9.5 ± 0.5 | 0.87 ± 0.08 | 46.4 ± 2.2 |
| Explicit Reasoning(本文) | 1.140 ± 0.015 | 56.4 ± 1.5 | 16.9 ± 0.7 | 5.5 ± 0.5 | 9.0 ± 0.1 | 1.01 ± 0.03 | 52.3 ± 1.4 |
| TacitVLA(本文) | 1.116 ± 0.011 | 55.8 ± 0.0 | 15.6 ± 0.2 | 6.7 ± 0.3 | 10.0 ± 0.9 | 0.87 ± 0.08 | 52.5 ± 0.3 |
表5:PhysicalAI-AV。开环 minADE 是公开发布版 1,434 段留出片段上 6 次采样的最小平均位移误差;闭环是 AlpaSim 挑战赛 441 场景公开分组、每次调用采样一条轨迹、每场景 3 次 rollout 的均值(整理自论文 Table 6)。违规指有责碰撞与出界事件。
细看表5 的违规列,「场景分追平」并不等于逐项追平:TacitVLA 的有责碰撞 6.7% 高于 Explicit Reasoning 的 5.5%,出界 10.0% 高于 9.0%,每次违规公里数 0.87 也低于 1.01,而它靠更低的任意碰撞率(15.6% 对 16.9%)与几乎相同的通过率把场景分拉了回来。场景分是一个把多项指标合成到一起的赛制分数,安全相关的分项上这 1 分级别的差异,在 441 个场景、3 次 rollout 的样本量下没有做显著性检验。附录 D 给了每个基准上两个推理策略各一次成功与一次失败 episode 及其生成的推理文本,论文的说法是「在这些例子里,没有哪种失败模式明显是 TacitVLA 独有的」——这是定性观察,不是统计结论。
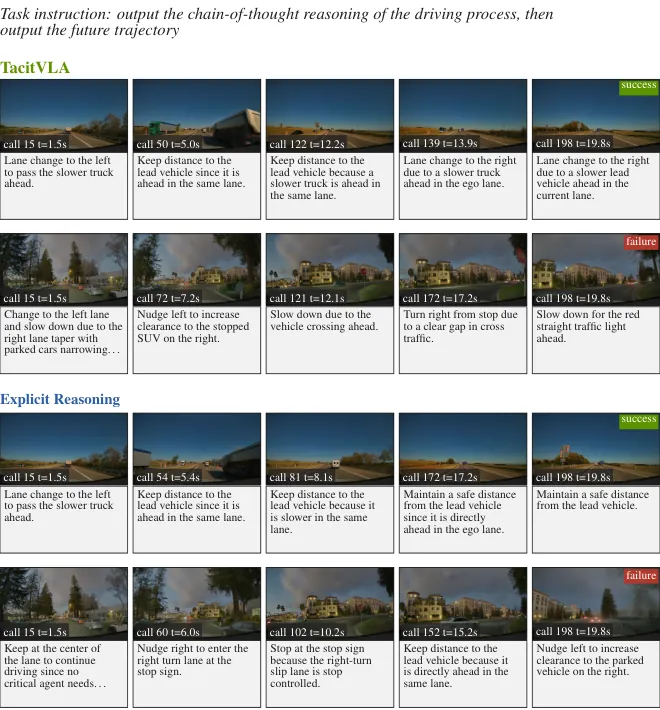
图6(论文 Figure 8):PhysicalAI-AV 闭环中两个公开分组场景的前视相机画面,各取五次调用,附每次调用生成的因果链。驾驶上推理文本以温度 0.6、top-p 0.98 采样,而不是贪心解码。
十一、延迟实测:省下来的到底是哪一段
计时方法是主机侧 wall-clock 计时器,在每个阶段边界做设备同步,一张 H100 80 GB、bf16,一次只跑一个策略进程;视觉编码器、提示词 prefill 与每个去噪步都以捕获好的 CUDA graph 运行,文本生成则在静态 KV cache 上每 token 重放一次图。$T_{\text{action}}$ 是视觉编码、prefill 与去噪三段,对三个策略相同;prefill 记在 $T_{\text{action}}$ 里(Explicit Reasoning 下它作为生成的第一步运行);$T_{\text{reason}}$ 是 $r_t$ 的自回归生成,加上 Explicit Reasoning 专有的「骨干再过一遍已生成 token」那 5 到 8 ms。记忆任务上 TacitVLA 的动作与延迟生成共用一次 prefill,所以它的 $T_{\text{action}}$ 比 No Reasoning 高出几毫秒——这是异步生成唯一可见的代价。
| 基准 | 执行窗口 $T_{\text{exec}}$ (ms) | $T_{\text{action}}$:No Reasoning | $T_{\text{action}}$:TacitVLA | $T_{\text{reason}}$:TacitVLA | $T_{\text{reason}}$:Explicit | 延迟:No Reasoning | 延迟:TacitVLA | 延迟:Explicit |
|---|---|---|---|---|---|---|---|---|
| RoboMME,计数 | 800 | 127 | 127 | 93 | 93 | 127 | 127 | 220 |
| RMBench,Press Button | 6,972 | 170 | 171 | 66 | 66 | 170 | 171 | 236 |
| RMBench,Blocks Ranking Try | 8,116 | 162 | 171 | 81 | 87 | 162 | 171 | 257 |
| RMBench,Cover Blocks | 9,359 | 170 | 170 | 101 | 106 | 170 | 170 | 275 |
| RMBench,Battery Try | 11,181 | 162 | 169 | 120 | 126 | 162 | 169 | 294 |
| LIBERO | 250 | 147 | 147 | — | 345 | 147 | 147 | 495 |
| LIBERO-Plus | 250 | 147 | 147 | — | 347 | 147 | 147 | 497 |
| PhysicalAI-AV,闭环 | 100 | 127 | 127 | — | 143 | 127 | 127 | 269 |
表6:各阶段耗时与单次调用延迟(ms),整理自论文 Table 15。记忆任务上 TacitVLA 在执行窗口内生成,非记忆任务上完全不生成;RMBench 的窗口是运动规划器执行一个 plan 的平均时间。
把表6 读成结论有三层。第一层是倍数:Explicit Reasoning 的延迟是 TacitVLA 的 1.4 到 3.4 倍,最大的一处正是非记忆任务——LIBERO 上 495 ms 对 147 ms,因为差值全部来自「下一次调用根本不会用到的文本生成」。第二层是窗口约束是否被满足:LIBERO 的执行窗口是 250 ms(5 个动作、20 Hz),TacitVLA 的 147 ms 达标,Explicit Reasoning 的 495 ms 不达标,也就是说显式推理在这个基准上连自己的动作块都执行不完就得开始算下一个。第三层是异步生成的余量:记忆任务上没有任何一次延迟生成超出窗口,RoboMME 最长一条 180 ms(窗口 800 ms)、RMBench 最长一条 225 ms(窗口 6,972 ms 起),最多只占执行窗口的 23%,所以 TacitVLA 的延迟在表6 每一格里都等于 $T_{\text{action}}$。
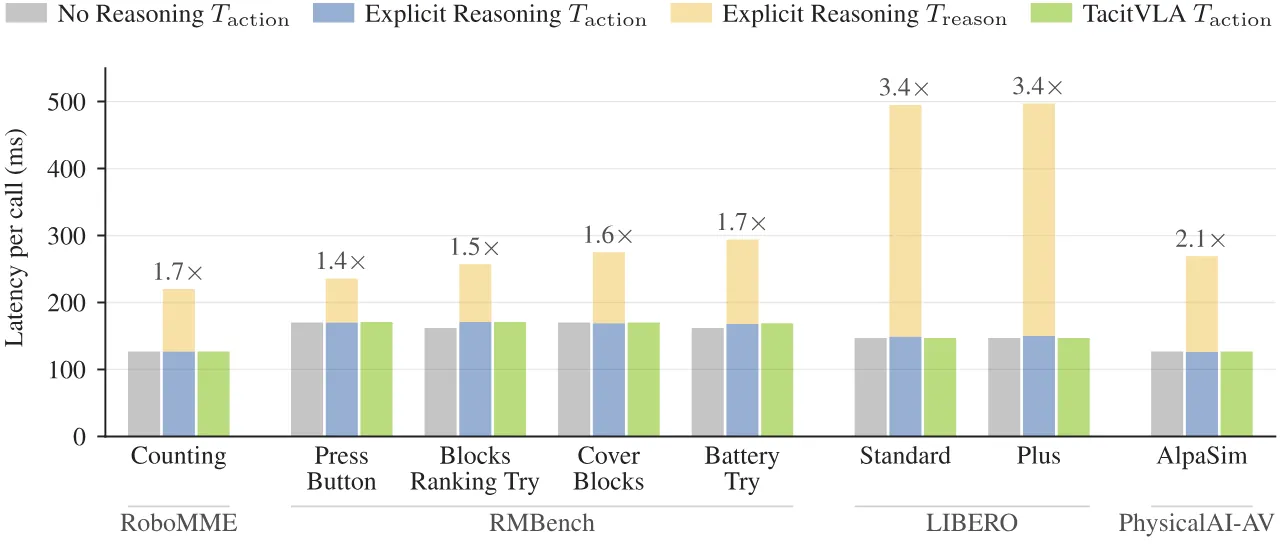
图7(论文 Figure 3):每个基准上三种策略的单次调用延迟。No Reasoning 与 TacitVLA 的每根柱子都是 $T_{\text{action}}$,Explicit Reasoning 的是 $T_{\text{action}}+T_{\text{reason}}$,柱组上方标注的是 Explicit Reasoning 相对 TacitVLA 的倍数。所有值是单张 H100 上按调用取的均值。
还有一个容易漏读的细节:RoboMME 那一行是 16 任务策略在四个计数任务上的数字;在其余 12 个不带台账的任务上,三个策略都不生成文本,三种延迟重合在 143 到 144 ms。这说明「延迟差」不是架构属性,而是调度属性——同一个模型在不写台账的任务上本来就一样快。
十二、局限
(作者自述)性能依赖推理数据的质量。TacitVLA 的收益完全经由「推理监督塑造表征」这一条通道到达动作,所以标注写得差,通道就窄。这一点在本文的实验里被部分掩盖了:LIBERO 用的是 DeepThinkVLA 发布的逐帧标注,RoboMME 用基准自带的 simple subgoal,RMBench 走 WLA 的子任务台账形式,驾驶用的是 Alpamayo-R1 风格的因果链标注——四份都是成熟标注,论文没有做「标注质量下降时三个策略各自掉多少」的对照。
(作者自述)延迟生成只在条目塞得进执行窗口时才是免费的。本文基准上它最多占窗口 23%,但更长的条目或更短的窗口会把超出的那部分时间原样加回延迟(Eq.4)。闭环驾驶那一格其实已经贴着边界:窗口只有 100 ms,而驾驶策略的 $T_{\text{reason}}$ 是 143 ms——它之所以不需要付这笔钱,仅仅因为驾驶是非记忆任务、根本不生成文本。一旦要把因果链当台账用,这个配置立刻回到 Eq.(4) 的第二项。
(作者自述)可解释性用途被留给未来工作。非记忆任务上 TacitVLA 仍然可以在动作之后生成推理文本供检查,这在驾驶这类安全关键场景里有价值,但论文没有评估这份「事后文本」是否忠实描述了动作的真实成因——一个不再条件在文本上的动作专家,其事后解释与动作之间的耦合强度是未知的。
(本文判断)全部结果都在仿真里。四个基准分别是 RoboMME、RMBench、LIBERO(-Plus) 的仿真环境与 AlpaSim,没有真机实验。$T_{\text{exec}}$ 是仿真器控制频率或运动规划器时间,真机上的执行窗口更抖、通信与安全检查还会吃掉一部分余量,因此「延迟生成从不超窗」这个结论的余量(最多 23%)在真机上需要重测。
(本文判断)主表数字带一次超参选择,逐轴一致性没有成立。RoboMME 上每个策略报告的是三个 $\lambda$ 里的最好成绩,而三者最优 $\lambda$ 不同;LIBERO-Plus 的逐轴拆分里 TacitVLA 与 Explicit Reasoning 在 Sensor(+8.9)与 Camera(−9.3)两轴上方向相反,绝对量都大于总分差 0.6。加上标准 LIBERO 四套件已经饱和(98.1 到 98.6,彼此 1 分以内)、「追平显式推理」的证据其实集中在少数几个尚未饱和的度量上:RoboMME 计数、RMBench Press Button、LIBERO-Plus、驾驶场景分。
(本文判断)驾驶那一组不可复现,且与 Alpamayo-R1 的比较不是等条件。训练语料是 380 万条专有驾驶事件,外部无法重跑;对比时 TacitVLA 用两路相机、约 3.9B 参数,Alpamayo-R1 用四路相机、10B 参数——「用一半的相机与参数逼近到 2.5 分以内」是事实,但少两路相机同时意味着输入信息更少,这个方向的差异既可能低估也可能高估 TacitVLA 的相对能力。
十三、总结与展望
这篇论文的贡献与其说是一个新模型,不如说是一次干净的归因实验。它把推理 VLA 里「训练期监督」与「部署期条件」这两件一直被捆在一起的事拆开,用只差一格注意力掩码的三个版本、四个基准、两套任务类型证明:在所研究的范围内,动作专家从不条件在本次推理上,与条件在它上面,成绩相同。收益经由监督塑造的表征到达动作;在记忆任务上,另一部分收益经由上下文里那些更早的台账条目到达动作——本次这一条不参与。
工程上它的价值在于零额外部件:仍然是一个骨干喂一个动作专家,没有第二个模型、没有调度器、没有双系统的频率划分。论文因此给出一个很实的推论——任何这一形式的推理 VLA 都可以被训成 TacitVLA:把推理 token 对动作专家掩掉,部署时要么省略生成,要么在推理文本要当记忆用时让它在动作执行期间跑。
往前看有两条明确的台阶。一是把「事后生成的文本」变成可验证的解释,用于驾驶这类安全关键场景的审查,这是作者自己点出的方向。二是与 Fast-WAM 的结论合并:既然未来视频预测的收益也主要在训练期的表征上,那么一个带三个专家(推理、未来视频、动作)的骨干、在三个目标上联合训练、部署时既不生成推理也不生成未来视频,是本文论证的自然延伸。这两个方向都还没有结果,但它们共用同一个前提,而这篇论文刚好把这个前提验证了一遍。
金句
动作必须条件在本次推理上,还是学会生成它就够了?在四个基准上,答案是后者:一个从不读自己刚写下的推理的动作专家,与一个非读不可的动作专家,成绩相同——而前者不必等。