PAPER DEEP DIVE
RoboPrompt:用稀疏人类输入直觉式引导机器人策略
模仿学习训练的端到端机器人策略受限于数据多样性,零样本部署常常失败;遥操作纠正依赖专用硬件与熟练操作员,而把人类指导作为策略额外输入的方法又需要修改架构并专门训练可引导性。RoboPrompt 提出一个通用、轻量的机器人策略引导系统:用户只需用画出的轨迹、目标点或粗方向指令等稀疏输入,就能在线纠正策略行为。系统用一个 0.77B 参数的 VLA(Evo-1)作为人类意图翻译器,把稀疏提示转换为时空完整的动作草稿,再借助基策略(Diffusion Policy、π0.5、FastWAM)自身的扩散/流匹配去噪动力学,在噪声空间中平衡人类意图与策略先验,无需改动基策略架构或为可引导性微调。真机实验中三种策略的提示对齐率达 99.44%、97.1%、100.0%;将引导 rollout 用于 DAgger 在线改进,2–3 轮后 π0.5 三个任务平均成功率提升 15.5%,三个策略在 Insert Bread 上提升 21.3%,人工干预次数分别下降 44.0%(2.86→1.60)与 81.9%(2.60→0.47)。
RoboPrompt: Intuitive Robot Policy Steering with Sparse Human Input
Yanwen Zou、Chenyang Shi、Guoxuan Xu、Wenye Yu、Wendi Chen、Ye Pan、Cewu Lu†、Chuan Wen†(上海交通大学 / 上海创新研究院 / Noematrix)
arXiv:2610.10534v1 [cs.RO],提交于 2026-10-07 · arXiv:2610.10534 · 项目页 · 代码仓库 github.com/yanwen-zou/Roboprompt
IEEE 索引术语:Robot Policy Steerability、Robot Manipulation、Imitation Learning
一句话总结
模仿学习训出来的策略一上线就暴露数据分布的短板,而纠正它要么靠遥操作硬件与熟练操作员,要么靠给策略加条件输入并为此重新训练。RoboPrompt 走了第三条路:不动基策略一个字节,用一个 0.77B 参数的轻量 VLA(Evo-1)把人类画的一个点、一条轨迹或一句粗方向指令翻译成「动作草稿」,再把这个草稿扔进基策略自己的扩散/流匹配去噪过程里精炼。控制旋钮是去噪步数比例 $\gamma$:$\gamma=0$ 时输出完全听人类的,$\gamma=1$ 时完全回落到基策略。在 Diffusion Policy、$\pi_{0.5}$、FastWAM 三个策略上,提示对齐率分别达到 99.44% / 97.1% / 100.0%;把引导成功的 rollout 过滤后喂给 DAgger,2–3 轮后 $\pi_{0.5}$ 三个任务平均成功率 +15.5%,人工干预次数从 2.86 降到 1.60(−44.0%)。
一、问题:纠正一个失败中的策略,现有三条路都贵
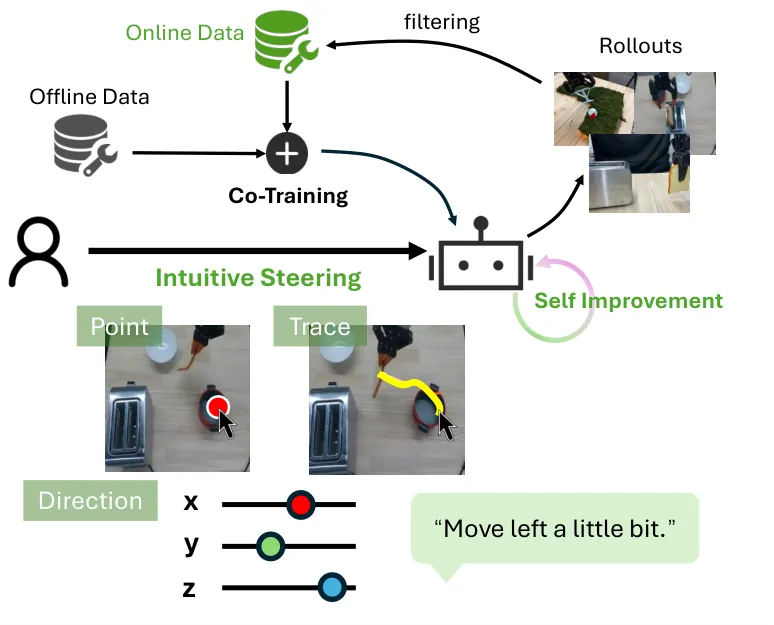
图1(论文 Fig.1):RoboPrompt 的系统愿景。离线数据与在线 rollout 共同训练策略,人类用点(Point)、轨迹(Trace)、方向滑杆(Direction,配一句「Move left a little bit.」)三种稀疏输入在推理时直觉式引导策略;引导成功的 rollout 经过滤后回流,构成自我改进闭环。
端到端视觉-动作策略的能力上限由训练数据的多样性决定,这件事在真机上表现为零样本部署不可靠:策略会在没见过的摆放位置、没见过的光照、没见过的干扰物面前失败。论文把现有的纠正手段归成三类,并逐一点出代价。
第一类,共享自主/遥操作纠正。人在回路直接接管低层控制,效果最直接,但需要一个遥操作设备(本文实验用 Sigma.7)和一位会用的操作员。这把「纠正策略」变成了「雇一个人全职开机器人」,规模化部署无从谈起。
第二类,把人类指导作为策略的额外条件输入。Steerable Policies 把提示翻译成语言条件,$\pi_{0.7}$ 让世界模型把子任务语言提示转成目标图像。问题有二:语言天然表达不好细粒度空间与运动信息(「往左一点」到底是 2 厘米还是 5 厘米?);而且这类方法要求为可引导性专门修改架构或微调,换一个基策略就要重来一遍。
第三类,推理时免训练干预。Inference-Time Policy Steering 用视觉引导目标去偏置扩散策略的采样过程,不需要训练。但重加权只能在该策略自己学过的动作流形内挪动输出——当失败恢复需要的动作恰好落在流形之外时,这条路走不通。
RoboPrompt 的定位因此很清晰:人类意图的翻译与基策略的执行解耦。翻译器是一个独立的小模型,一次训练、多处复用;基策略保持冻结,只借用它的去噪动力学做精炼。这样既不需要遥操作硬件,也不需要为每个基策略重训可引导性,还能产出流形之外的纠正动作。
二、Phase I:把稀疏提示翻译成时空完整的动作草稿
2.1 三种提示与它们的后验标签
人类教别人做事的方式就是画个草图、指一个位置、说一句大概方向。RoboPrompt 把这三种形式直接定义为提示接口:点提示与轨迹提示以视觉形式叠加在环境相机观测上,全局动作提示以文本形式追加到任务指令后。形式化地,一条 episode 记为 $\tau=\{(O_t, Q_t, a_t)\}_{t=0}^{T-1}$,其中 $O_t$ 是视觉观测、$Q_t$ 是 TCP 位姿、$a_t$ 是低层动作,动作时域为 $H$;投影函数
$$u_t = f_{\mathrm{proj}}(Q_t) \in \mathbb{R}^2 \tag{1}$$
把 TCP 投到固定环境相机的图像平面。点提示的后验目标是短时域运动结束时的投影终点:
$$p_t^{\mathrm{pt}} = u_{\bar{t}}, \qquad \bar{t} = \min(t+H-1,\ T-1) \tag{2}$$
模型输入是把这个点画在观测上的图 $\tilde{O}_t^{\mathrm{pt}} = \mathrm{Overlay}_{\mathrm{pt}}(O_t, p_t^{\mathrm{pt}})$。轨迹提示的后验目标是未来 TCP 投影序列 $P_t^{\mathrm{traj}} = (u_t, u_{t+1}, \ldots, u_{\bar{t}})$,把这些稀疏点连成线叠加在观测上得到 $\tilde{O}_t^{\mathrm{traj}}$。全局动作提示描述基坐标系下的粗笛卡尔位移,后验目标是对同一时域内原始 XYZ 动作求和再归一化:
$$g_t = \mathrm{Norm}_g\!\left(\sum_{k=0}^{H-1} a_{t+k}^{xyz}\right) \in [-1,1]^3 \tag{3}$$
再 verbalize 成文本(如图3 右侧的「Cook bread, move x:0.128, y:0.465, z:-0.140 in global frame.」)。论文特意说明:虽然 VLM 也能生成这类标签,但在语义歧义、视觉遮挡、需要精细运动推理的场景下并不可靠,所以他们用上述几何后验流程从 play data 自动造标签。考虑到人类提示天生不精确,训练时对提示施加随机位置与尺度扰动。
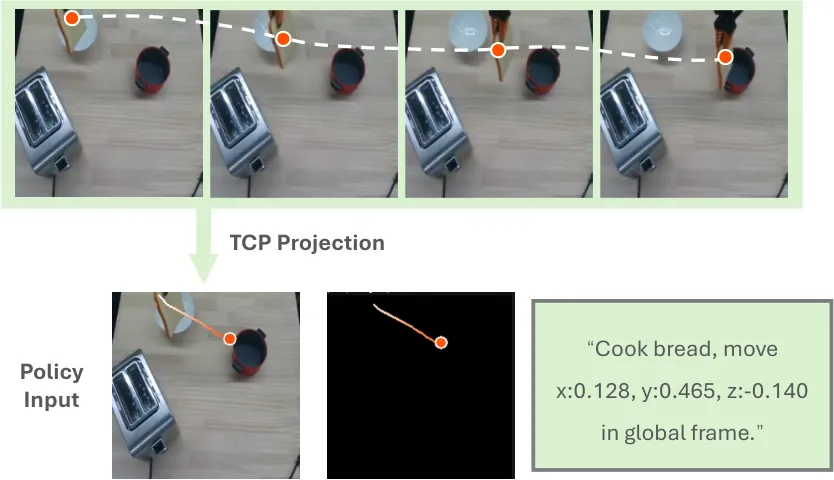
图2(论文 Fig.3):提示标签生成。对未来 n 帧的 TCP 投影连线与终点投影分别作为轨迹提示与点提示的真值;累积并归一化的动作监督全局动作提示。策略实际接收两路视觉输入:带提示的相机图,以及一张只有提示、没有背景的黑底图。
2.2 0.77B 的草稿模型 Evo-1
Phase I 的架构是一个 0.77B 参数的 VLA(Evo-1)。对点/轨迹提示,提示直接渲染在环境相机图上作为主视觉输入;同时再渲染一张不含相机背景的纯提示图作为第二路视觉输入,防止引导信号被场景外观稀释。对全局动作提示,归一化位移被 verbalize 后拼进任务文本。模型输出时间上连续的动作块:
$$a_{\mathrm{I}} = \pi_\phi(O_t^{(1)}, O_t^{(2)}, q_t) \tag{4}$$
训练只用 500 条在同一机器人平台上采集的 play data 轨迹,损失为主任务动作损失加三路辅助监督:
$$\mathcal{L}_{\mathrm{I}} = \mathcal{L}_{\mathrm{act}}(a_{\mathrm{I}}, a_{t:t+H-1}) + \lambda_{\mathrm{aux}}(\mathcal{L}_{\mathrm{pt}} + \mathcal{L}_{\mathrm{traj}} + \mathcal{L}_{\mathrm{global}}) \tag{5}$$
其中 $\mathcal{L}_{\mathrm{pt}}$ 与 $\mathcal{L}_{\mathrm{traj}}$ 在视觉输入空间做像素级监督(即要求模型重建提示的像素位置),$\mathcal{L}_{\mathrm{global}} = \operatorname{MSE}(\hat{g}_t, g_t)$。这个设计的含义是:Phase I 不追求执行精度,只追求「与人类意图一致、与当前观测相容、时空完整」的草稿;精度留给 Phase II。
三、Phase II:在噪声空间里平衡人类意图与策略先验
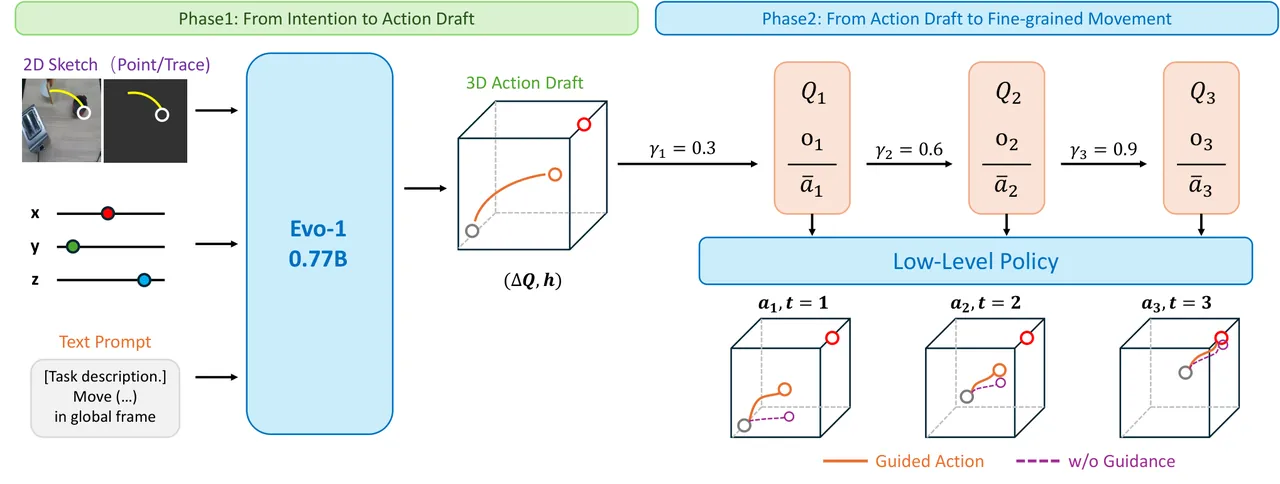
图3(论文 Fig.2):系统架构。Phase I 中提示输入经轻量 VLA 产出 6D 动作块草稿;Phase II 中基策略精炼该草稿,加噪比例 $\gamma$ 控制人类引导与基策略先验的平衡,且 $\gamma$ 随重规划步递增(0.3 → 0.6 → 0.9),把控制权逐步交还给基策略。
3.1 渐进偏置去噪(PBD)
主流机器人策略的动作生成都走扩散或流匹配。RoboPrompt 利用迭代去噪的数学结构做融合:设提示发出后的重规划块索引为 $m$,基策略总去噪步数为 $N$,当前去噪步 $k^m$ 以固定增量 $\Delta k$ 递增:
$$k^m = \min(k^0 + m\,\Delta k,\ N), \qquad \gamma^m = k^m / N \tag{6}$$
基础做法是把 Phase I 草稿按 $\gamma^m$ 加噪后用基策略去噪:
$$z_{\gamma^m} = (1-\gamma^m)\,a_{\mathrm{I}} + \gamma^m \epsilon, \quad \epsilon \sim \mathcal{N}(0, I), \qquad a_{\mathrm{II}} = \mathcal{D}_\theta(z_{\gamma^m},\ \gamma^m \rightarrow 0) \tag{7}$$
$\gamma$ 是一个可调的控制比:$\gamma=0$ 时 Phase II 输出就是 Phase I 草稿本身,$\gamma=1$ 时完全回落到基策略的无引导动作。一次人类 sketch 往往对应超过一个动作块的运动,$\gamma^m$ 的单调递增让同一份人类输入跨多个重规划块持续生效:第一个块强跟随人类,后续块逐步 reintroduce 基策略先验,控制权平滑交接。
3.2 噪声增强流反转引导(NA-FRS)
但论文实测发现一个关键事实:去噪带来的动作改变在去噪时间上是不均匀的——很少几步去噪就能把动作挪动很多,而高噪声端的最后几步接近收敛、几乎不动。这意味着「直接加随机噪声」的 $\gamma$ 不是一个线性旋钮,跨块交接会显得突兀。为此他们在 Flow Reversal Steering 的基础上提出 NA-FRS:先把学到的去噪动力学从干净的 Phase I 动作反向积分到目标去噪水平,
$$z_{\gamma^m}^{\mathrm{rev}} = \mathcal{R}_\theta(a_{\mathrm{I}},\ 0 \rightarrow \gamma^m), \qquad \epsilon_{\mathrm{rev}} = \big(z_{\gamma^m}^{\mathrm{rev}} - (1-\gamma^m)a_{\mathrm{I}}\big)/\gamma^m \tag{8}$$
反向路径最大程度保留 Phase I 信息,但会限制原策略性能的发挥;于是把反向噪声与纯高斯噪声按比例混合,随 $\gamma^m$ 增大逐步腐蚀 Phase I 分布:
$$\epsilon_{\mathrm{mix}} = \sqrt{1-\rho^2}\,\epsilon_{\mathrm{rev}} + \rho\,\epsilon, \qquad z_{\gamma^m}^{\mathrm{NA}} = (1-\gamma^m)a_{\mathrm{I}} + \gamma^m \epsilon_{\mathrm{mix}} \tag{9}$$
其中 $\rho \in [0,1]$ 控制随机噪声占比,最终把 $z_{\gamma^m}^{\mathrm{NA}}$ 去噪回 $t=0$ 得到精炼动作。反向分量把输出锚在草稿附近,随机分量让大 $\gamma$ 端恢复纯噪声去噪的行为,两者叠加得到跨去噪水平近似线性的平滑过渡——这正是跨动作块引导需要的控制特性。
flowchart TD
    H[人类稀疏输入
点 / 轨迹 / 方向文本] --> P1[Phase I: Evo-1 0.77B VLA
提示图 + 纯提示图 + 任务文本]
    PLAY[500 条 play data 轨迹
几何后验标签 + 随机扰动] --> P1
    P1 --> DRAFT[动作草稿 a_I
时空连续的 6D 动作块]
    DRAFT --> GAMMA[按重规划块 m 递增去噪水平
gamma^m = min(k0 + m*dk, N)/N]
    GAMMA --> NA[NA-FRS
反向积分得 eps_rev
与高斯噪声按 rho 混合]
    NA --> DEN[基策略去噪 D_theta
pi0.5 / Diffusion Policy / FastWAM
冻结 不微调 不改架构]
    DEN --> ACT[精炼动作 a_II 执行]
    ACT --> ROLL[引导 rollout]
    ROLL --> TOT[TOT 过滤
与专家轨迹的 OT 距离 + 时长惩罚]
    TOT --> MIX[与离线数据 50/50 混合]
    MIX --> DAG[DAgger 新一轮训练]
    DAG --> DEN
把整条链路画出来能看清代价结构:需要训练的只有 Phase I 那 0.77B 的小模型(500 条轨迹),而它对所有基策略复用;Phase II 完全借用冻结基策略的现成去噪过程。DAgger 回路则把「人类纠正」从一次性消费变成可累积的资产。
四、引导 rollout 不是白拿的数据:TOT 过滤
引导成功的 rollout 仍可能带着振荡、重复开合夹爪、绕远路。这类数据会把「相似观测」配到「不一致或滞后的动作」上,在 DAgger 式训练里毒化马尔可夫模仿学习策略。论文引入时间加权最优传输(TOT)做准入:对引导 rollout $\tau^r = \{x_i^r\}_{i=1}^{T_r}$ 与专家轨迹 $\tau^e = \{x_j^e\}_{j=1}^{T_e}$,取策略嵌入 $\phi(x)$,定义时间步级代价
$$C_{ij} = 1 - \frac{\phi(x_i^r)^\top \phi(x_j^e)}{\lVert \phi(x_i^r)\rVert_2\, \lVert \phi(x_j^e)\rVert_2} \tag{10}$$
再求与最近专家轨迹的 OT 距离,并对「不必要的长」施加惩罚。记 $\bar{T}_E = \mathrm{median}_{\tau \in \mathcal{D}_E}|\tau|$:
$$D_{\mathrm{OT}}(\tau^r, \tau^e) = \min_{\Pi \in \mathcal{U}(T_r, T_e)} \sum_{i=1}^{T_r}\sum_{j=1}^{T_e} \Pi_{ij} C_{ij} \tag{11}$$
$$S(\tau^r) = \min_{\tau^e \in \mathcal{D}_E}\Big[D_{\mathrm{OT}}(\tau^r, \tau^e) + \lambda \max\big(0,\ T_r/\bar{T}_E - 1\big)\Big] \tag{12}$$
$\mathcal{U}(T_r, T_e)$ 是具有均匀时间边际的传输计划集合。分数低意味着「语义上接近专家行为且不长得离谱」。只保留 $S(\tau^r)$ 低于阈值的 rollout,并按已有做法与原始离线数据以 50%/50% 混合进入下一轮 DAgger——既把策略分布往纠正后的部署分布推,又保留基策略先验。
五、实验:三种基策略、三个目标、六个首次用户
5.1 平台与引导主结果
真机平台为 Flexiv Rizon4 机械臂配 Robotiq 2F-85 夹爪,遥操作采集用 Sigma.7,每个任务 100 条演示训基策略。引导实验的任务是「从碗里拿面包放进三个目标之一」(锅 / 左烤面包机 / 右烤面包机),训练集每个目标 46 条演示且三个目标共用同一句文本描述——基策略因此天然是多峰的,不引导时按自己的偏好随机选目标(图4 右侧饼图:$\pi_{0.5}$ 40%/25%/20%、DP 40%/25%/5%、FastWAM 60%/25%/15%,不足 100% 的部分是未到达任何目标就失败的试验)。
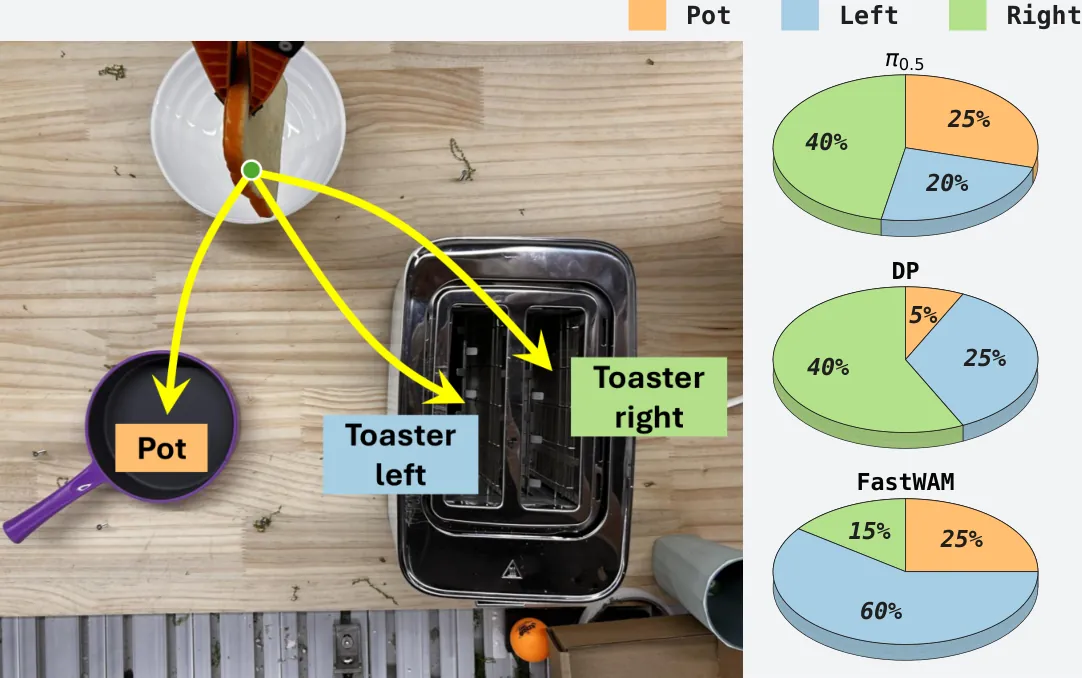
图4(论文 Fig.4):引导实验设置与基策略的自然分布。左:机器人从碗中取面包放入锅、左烤面包机、右烤面包机三者之一;右:三个基策略在不引导时对三个目标的偏好分布。
| 基策略 | 目标 | 不引导进度 | 引导后进度 | 平均引导次数 | 其中视觉提示 | 其中全局提示 | 提示对齐率 |
|---|---|---|---|---|---|---|---|
| $\pi_{0.5}$ | Left | 59.6% | 77.5% | 2.50 | 1.45 | 1.90 | 99.44% |
| Right | 72.4% | 2.95 | 2.50 | 2.50 | |||
| Pot | 89.8% | 2.35 | 1.80 | 1.25 | |||
| Diffusion Policy | Left | 46.5% | 71.3% | 4.80 | 3.10 | 3.40 | 97.1% |
| Right | 64.75% | 3.45 | 1.85 | 1.95 | |||
| Pot | 57.95% | 4.40 | 3.95 | 1.85 | |||
| FastWAM | Left | 46.2% | 57.4% | 3.15 | 2.15 | 2.30 | 100.0% |
| Right | 62.3% | 3.10 | 1.90 | 2.10 | |||
| Pot | 52.3% | 2.65 | 1.70 | 1.55 |
这张表(论文 Table I)要分两块读。左块是「引导有没有用」:三个策略、九个策略-目标组合上,引导后进度全部高于不引导基线,最大的单点提升是 $\pi_{0.5}$ 的 Pot(59.6% → 89.8%,+30.2 个点)与 DP 的 Left(46.5% → 71.3%,+24.8 个点)。右块是「引导得准不准、贵不贵」:提示对齐率(人类干预中机器人运动沿提示所指方向走的比例,未指定的维度不计)三个策略都 ≥95%,其中 FastWAM 达到 100.0%;平均引导次数在 2.35–4.80 次之间,$\pi_{0.5}$ 最省(2.35–2.95 次),DP 最费(3.45–4.80 次)——这与 DP 基线本身最弱(46.5%)一致:基策略越弱,人类需要出手的次数越多。
5.2 DAgger:把纠正变成训练数据
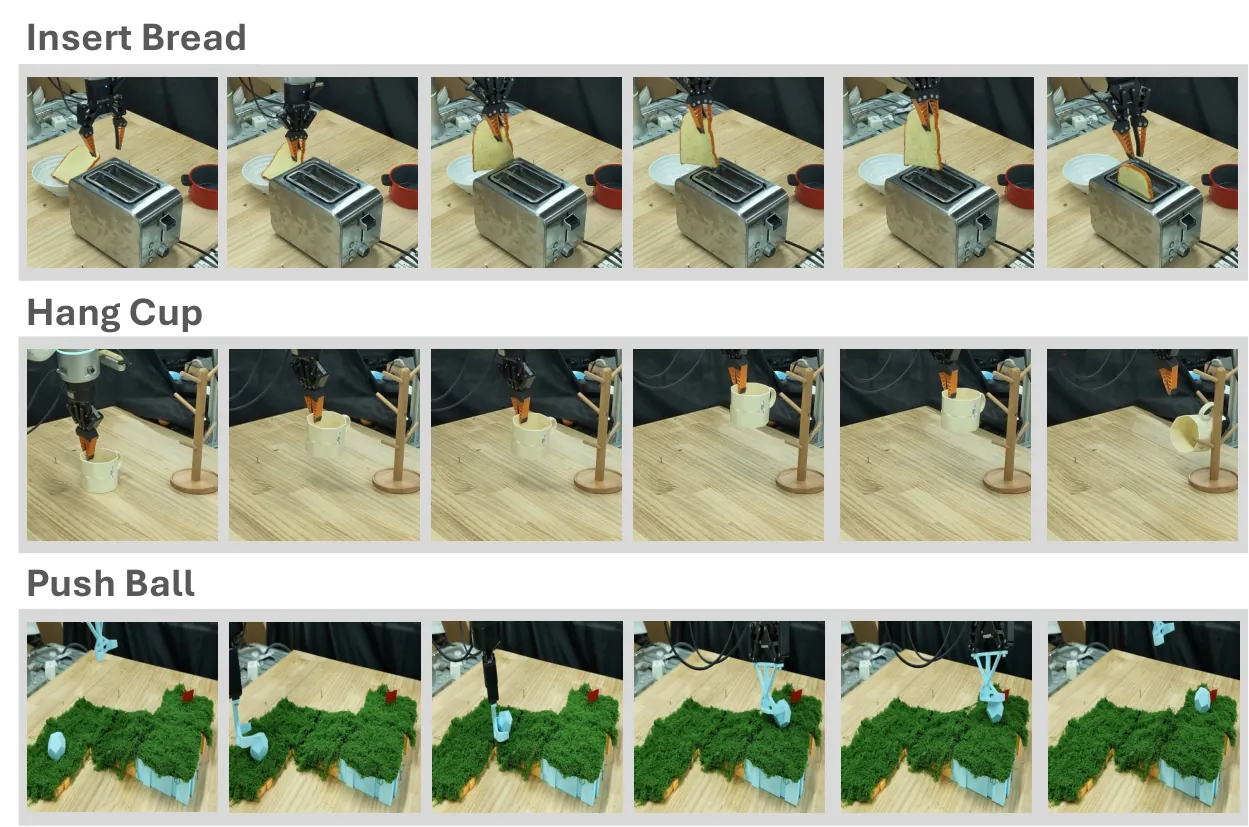
图5(论文 Fig.5a):DAgger 实验的三个真机任务。Insert Bread:从碗中取面包插入烤面包机右槽(注意与引导实验不同,这里训练演示只含右槽);Hang Cup:把杯子挂到第二高的挂钩上;Push Ball:把多面体球推过不平整平台直到触旗。
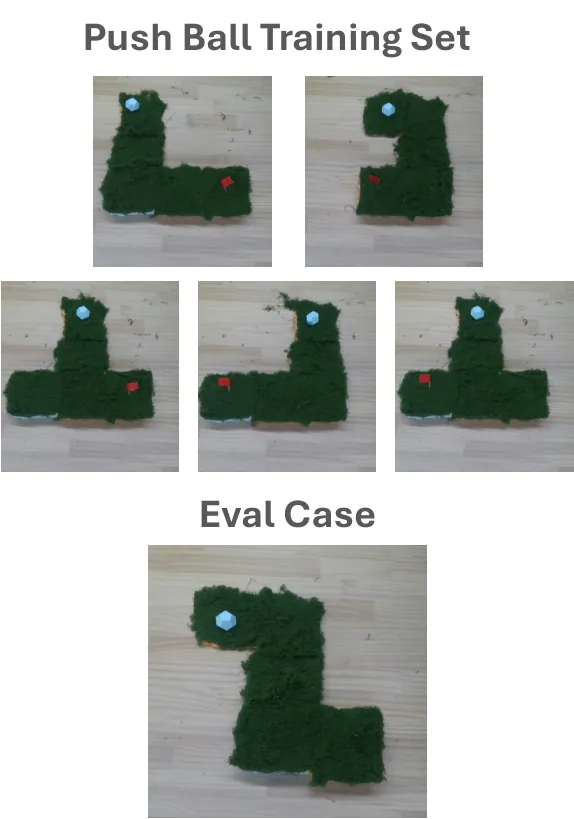
图6(论文 Fig.5b):Push Ball 的训练集含 5 种迷宫布局(20 条演示 × 5 路线),评测在另一种未见过的布局上进行——引导 rollout 让策略在新布局里完成任务,同时为后续 DAgger 轮次提供数据。
| 实验设置 | 指标 | 结果 |
|---|---|---|
| $\pi_{0.5}$,Insert Bread / Hang Cup / Push Ball,2–3 轮 DAgger | 平均成功率提升 | +15.5% |
| DP / $\pi_{0.5}$ / FastWAM,Insert Bread,同协议 | 平均成功率提升 | +21.3% |
| $\pi_{0.5}$ 三任务 | 平均人工干预次数 | 2.86 → 1.60(−44.0%) |
| 三策略 Insert Bread | 平均人工干预次数 | 2.60 → 0.47(−81.9%) |
| 6 名首次用户,5 分钟介绍,每人 5 次面包插入 | 任务进度 / 干预次数 | 进度与熟练用户相当、显著高于无引导基线;干预次数略多 |
| 20 条成功 rollout、1 轮 DAgger,TOT 过滤 vs 随机选取 | 三任务进度 | 过滤后三个任务全部更高,且干预次数更低 |
趋势比单点数字更说明问题:每一轮 DAgger 都同时抬高成功率、压低下一轮所需引导次数,即「中等初始性能 + 频繁人工干预」的策略在几轮内滑向「基本自主执行」。三策略 Insert Bread 上干预次数降到 0.47 次/episode,意味着多数 episode 已不需要人类出手。用户研究(Q4)里 6 名从零开始的志愿者只听了 5 分钟介绍,任务进度就与熟练用户相当——「直觉式」这个定语在论文里是有数据支撑的;熟练用户干预更少,作者的解释是熟悉策略后能预防失败而非事后恢复。
5.3 去噪动力学与数据质量两个消融
Q3 的去噪动力学实验(论文 Fig.8)是 NA-FRS 的存在理由:对流匹配与扩散两类策略,动作改变在去噪步上分布不均——前几步就能大幅挪动动作,高噪声端接近收敛几乎不动。原始 FRS 把输出锚在 Phase I 动作附近但牺牲了基策略性能,NA-FRS 的反向+随机混合则给出跨去噪水平近似线性的平滑过渡。Q5 的过滤消融(论文 Fig.10)则证明「成功」不等于「可训练」:未过滤的成功 rollout 会引入运动抖动,造成失败或额外干预;TOT 保留的是「平滑且与人类意图一致」的那部分轨迹。
六、代码与可复现性
仓库 yanwen-zou/Roboprompt 与论文同步公开,结构与方法一一对应:Evo-1/ 是 Phase I 模型、提示条件数据集与训练实现;openpi/、diffusion_policy/、FastWAM/ 是三个 Phase II 基策略及其配置;steering/ 负责 Phase I + Phase II 的组合与策略适配器;scripts/labeling/ 是把 TCP 轨迹投影成提示标签的后验标注脚本;scripts/realworld/train/evo1/ 给出两阶段训练启动器(先冻 InternVL3 训动作头 5,000 步,再解冻 VLM 联合训 30,000 步);web_steer/ 是基于浏览器的提示界面;hardware/ 是机械臂/相机集成与标定配置。训练与评测数据在 HuggingFace 的 ywzou/Roboprompt_Play_Data(含 bread 训练集、maze 观测与示例 checkpoint),离线评测不需要真机:下载 checkpoint 后用交互式可视化窗口在观测图上画点/画轨迹、调方向滑杆,左侧显示无提示的 Phase II 采样、右侧显示 Phase I 草稿与 Phase I+II 精炼结果。--phase2-steps 接受小数步数,调小保留更多 Phase I 提案、调大放更多精炼给下游——这正是 $\gamma$ 旋钮的工程化暴露。
七、局限性:作者自述两条,我的判断四条
作者自述。其一,引导目前只作用于末端执行器位姿,不支持灵巧手/多指控制;其二,Phase I 引导模块虽不限定本体与环境,但当前只在单一平台的数据上训练,跨本体零样本引导需要更大更多样的数据。
我的判断。第一,500 条 play data 与「通用引导」之间的张力没有被量化。Phase I 宣称 task-agnostic,但训练数据来自与实验相同的平台与相近任务族;论文没有做「在 A 平台训、去 B 平台引导」的跨域实验,所以「可复用翻译器」目前是一个架构声明而非实验结论。第二,提示对齐率的定义偏宽松:只评估提示所指维度、未指定维度不计,且是「运动方向是否跟随」而非「是否到达提示位置」的度量;99.44%/100.0% 这样的高分与引导后进度仍只有 57.4%–89.8% 并存,说明对齐与成功之间还隔着执行精度这一层,读者不应把对齐率读成成功率。第三,DAgger 汇总数字缺少逐轮逐任务表格:+15.5% 与 +21.3% 来自 Fig.6/Fig.7 的曲线,正文没有给出每轮每任务的成功率与标准差,也没有种子数;干预次数 −81.9%(2.60→0.47)的方差信息同样缺失,小样本真机实验的这个量级波动并不小。第四,TOT 的嵌入 $\phi(x)$ 与阈值、$\lambda$ 均未交代:式 (12) 的代价依赖「策略嵌入」的余弦相似度,但论文没说是哪个模型的哪一层嵌入,也没给准入阈值与时长惩罚系数的敏感性分析——而这恰好是决定「过滤掉多少数据、留下什么偏差」的关键旋钮。
八、总结与展望
RoboPrompt 的贡献可以压成一句:把「人类意图 → 动作」拆成「人类意图 → 草稿」与「草稿 → 动作」两段,前段用一个可复用的小模型,后段借用冻结基策略的去噪动力学。这个拆法的价值不在单点性能,而在接口:它让引导能力与基策略解耦,$\pi_{0.5}$、Diffusion Policy、FastWAM 三个架构迥异的策略共用同一个 Phase I 与同一套 $\gamma$ 语义;又让「人类纠正」从消耗品变成 DAgger 的训练资产,2–3 轮把干预次数压到接近零。PBD 的单调 $\gamma$ 调度与 NA-FRS 的反向+随机混合,解决的是同一个工程问题——跨动作块的控制权平滑交接,前者给语义、后者给数学性质。
往前看,作者给出的路线图是「更大更多样的 Phase I 数据 → 跨本体零样本引导」与「灵巧末端的支持」。从本文证据出发,我更关心两个中间台阶:一是 Phase I 的跨域迁移实验(换平台、换相机布局后对齐率掉多少),这决定「一次训练、处处复用」是否成立;二是把 TOT 过滤的嵌入与阈值开源成可复现的默认配置——目前仓库给了标注与训练脚本,但过滤细节仍留在论文公式里。若这两块补齐,RoboPrompt 这条「免训练引导 + 引导数据自改进」的路线,会是真机策略部署期运维的一个实用范式。
金句
人类不需要会开机器人,只需要会指路;把指路翻译成动作是小模型的事,把动作做精准是基策略自己的去噪过程的事——RoboPrompt 的全部设计,就是让这两件事各自待在自己最擅长的噪声水平上。