PAPER DEEP DIVE
PriMoRetarget:通过优先级运动重定向实现人形机器人动作迁移
运动重定向是把人类动捕数据迁移到人形机器人的关键预处理步骤。现有方法多将重定向写成加权多目标优化,目标冲突时只能靠手工调权妥协,难以保证脚部落点、人-物接触等关键特性不被姿态目标牺牲。本文提出 PriMoRetarget,用显式优先级层次取代相对权重:低优先级目标的梯度更新被投影到高优先级目标雅可比的零空间中,使接触与脚步约束严格优先于姿态相似度。方法包含逐帧分块投影(复杂度从 O(T^3 m^3) 降至 O(T m^3))、自由目标机制与加权和热身三个设计。在 LAFAN1、OMOMO、Inter-X 与 35 分钟双人协作数据上,接触保持率全面领先 PHC、GMR、OmniRetarget(OMOMO 96.9%),跟踪策略成功率在 LAFAN1 与 OMOMO 达 100%,并在 Unitree G1 真机完成搬箱部署。
论文元信息
- 标题:PriMoRetarget: Humanoid Motion Transfer Through Prioritized Motion Retargeting
- 作者:Nicholas Ioannidis*、Dun Yang*(共同一作)、Max Smith、Tue Vu、Ziyu Zhang、Shayegan Omidshafiei、Xue Bin Peng
- 机构:Simon Fraser University、FieldAI、NVIDIA、Alberta Machine Intelligence Institute(Amii)
- 链接:arXiv:2610.12642v1(2026-10-08);项目页 nickioan.github.io/primoretarget-page
- 代码状态:论文承诺代码与重定向后的动作数据将在发表后公开;项目页当前标注 Code (coming soon),截至本文撰写时仓库中仅有项目页与演示视频,尚无算法实现
一句话总结
PriMoRetarget 把运动重定向从"给每个目标调权重"改成"给每个目标排座次":低优先级目标的梯度更新被投影到高优先级目标雅可比矩阵的零空间中,因此脚部落点与人-物、人-人接触这类不可谈判的物理约束永远先于姿态相似度被满足。
研究背景与动机
人形机器人的行为数据极度稀缺,而人类动作捕捉库却积累了数十小时的行走、搬运、协作行为。运动重定向(motion retargeting)是连接两者的桥梁:它把源角色的动作参数映射到目标机器人的关节结构上,同时保留定义这段动作的特征。对于单一角色的动作,这条路线已经相当成熟;无论是基于逆运动学的优化方法,还是学习形态无关表示的数据驱动方法,都能在行走、跑步这类动作上给出可用结果。
一旦动作里出现物体或第二个角色,问题就变了性质。搬箱子时手与箱面的接触、扶人起身时两手与对方躯干的相对位置、双人抬物时的协调节奏,这些关系才是动作"成立"的原因。重定向若只保住各自的姿态而丢掉这些关系,得到的参考轨迹在物理上就不可行:手悬在箱子外面、脚踩进地面、两个机器人互相穿模。这类错误不会停留在可视化层面,它会直接加重下游强化学习与控制的负担,甚至让跟踪策略根本学不会。
主流重定向方法把这些需求写成一个加权多目标优化问题:姿态关键点匹配、脚部落点、接触保持、关节限位各是一个损失项,用权重 $w^k$ 表示相对重要性。问题在于目标之间会冲突——想把姿态贴得更近,往往就要牺牲接触精度。权重只编码"相对偏好",它无法保证"接触误差绝不为姿态让路"这种硬性优先关系;于是实践中只能针对每个任务、每种形态反复手工调权,而调出来的权重换一个动作就可能失效。
多目标优化社区对"不调权"的冲突处理有两条路线。一条是梯度手术,如 PCGrad 与 CAGrad,通过修改互相干扰的梯度来缓解冲突,但它们并不强制重要性顺序;另一条是优先级优化(prioritized optimization),把目标组织成层次,让低优先级目标只在高优先级目标已最优的解集内继续优化。机器人控制领域早就在用后者利用运动学冗余:全身控制与逆运动学中,"保持脚不滑"天然比"摆好手臂姿态"更重要。但这类方法此前主要出现在在线控制与模型预测控制的场景里。
本文的贡献正是把优先级优化搬到离线运动重定向上,并解决搬过去之后的三个工程难题:长序列上投影矩阵的立方级复杂度、时间平滑这类全局正则项在层次中无处安放、以及初始解离可行域太远时投影会锁死优化路径。作者给出逐帧分块的批处理投影、"自由目标"机制与加权和热身三个设计,在四个数据集(单人、人-物、人-人、多人协作)上验证了这套框架。
预备知识
重定向的优化变量是目标机器人每一帧的运动参数:根位置 $r_t\in\mathbb{R}^3$、根朝向 $\omega_t\in\mathbb{R}^3$ 与关节角 $\theta_t\in\mathbb{R}^{n_\theta}$,每帧共 $d=6+n_\theta$ 个参数。多个机器人时所有角色的参数被联合优化。前向运动学把参数映射为关键点位置 $p_{t,i}$ 与朝向 $R_{t,i}\in SO(3)$,源角色与目标机器人之间的关键点对应由用户预先指定。论文 Table I 汇总了全部误差函数:姿态项比较关键点位置 $\hat{p}_{t,i}-s_\dagger\cdot\bar{p}_{t,i}$ 与朝向 $\hat{R}_{t,i}\ominus\bar{R}_{t,i}$;交互项保持关键点对的相对位移(同一角色内为 self,跨角色为 cross);接触项作用于源动作中距离低于阈值 $c_{\mathrm{th}}$ 的身体对,分为手-物与手-手两类;帽号与横杠分别代表重定向后与源动作的量。
加权多目标的标准形式是
$$x^{\star}=\arg\min_{x}\sum_{k=1}^{K}w^{k}L^{k}(x)$$
其中 $x$ 是整段目标动作,$L^k$ 是第 $k$ 个损失。这个形式灵活,但冲突目标之间只能妥协:即使某一项代表更重要的物理要求,它的误差仍可能被其他项的下降"买走"。这正是本文要替换的对象。
优先级优化的思想来自冗余利用:高优先级目标的最优解通常不唯一,剩下的自由度构成一个解集,低优先级目标可以在其中继续优化而不破坏已达成的结果。任务优先级法(task-priority)把这一思想形式化为"在保持高优先级误差不变的方向上更新",历史上用于关节角色的逆运动学与人形机器人全身控制。本文把它从在线控制推广到整段动作的离线优化。
方法详解
层次的形式定义。设目标按优先级从高到低排为 $L^1,\ldots,L^K$,$S^0$ 为全部目标动作的集合。在第 $k$ 级,优化只在上一级的最优解集内进行:
$$x_k^{\star}\in\arg\min_{x\in S^{k-1}}L^{k}(x)$$
优化完成后,解集收缩为保持第 $k$ 级最优值的子集:
$$S^{k}=\left\{x\in S^{k-1}\;\middle|\;L^{k}(x)=L^{k}(x_k^{\star})\right\}$$
这个递归定义是全局的,但实现上作者在每一步梯度更新时局部地执行它:低优先级更新被限制在"一阶保持高优先级目标不变"的方向上。下面展开这个局部执行机制。
保持误差向量而非标量损失。设高优先级目标的向量值误差为 $f^{\mathrm{H}}(x)\in\mathbb{R}^m$,标量损失 $L^{\mathrm{H}}(x)=\|f^{\mathrm{H}}(x)\|^2$(例如若干对应身体的三维位置误差堆叠)。作者要求的不是损失不变,而是整个误差向量不变:
$$f^{\mathrm{H}}(x+\delta x)=f^{\mathrm{H}}(x)$$
这一选择有实质含义:若只冻结标量损失,误差的不同分量之间仍可互相补偿(左手偏一点、右手补一点,范数不变),接触关系照样被破坏。冻结向量则杜绝了这种补偿。
一阶线性化与零空间。对小更新 $\delta x$ 做泰勒展开:
$$f^{\mathrm{H}}(x+\delta x)\approx f^{\mathrm{H}}(x)+J^{\mathrm{H}}\delta x$$
其中 $J^{\mathrm{H}}=\partial f^{\mathrm{H}}/\partial x$。与上式联立得到约束 $J^{\mathrm{H}}\delta x=0$:合法更新必须落在高优先级雅可比的零空间里。设低优先级梯度为 $g^{\mathrm{L}}=\nabla_x L^{\mathrm{L}}$,用零空间投影器把它投影进去:
$$P^{\mathrm{H}}=I-(J^{\mathrm{H}})^{\top}\left(J^{\mathrm{H}}(J^{\mathrm{H}})^{\top}\right)^{-1}J^{\mathrm{H}}$$
$$x\leftarrow x-\alpha P^{\mathrm{H}}g^{\mathrm{L}}$$
论文 Fig. 2 用两个竞争的二次目标画出了与加权和的本质区别:加权和收敛到两者之间的妥协点,而投影更新会先走到高优先级目标的最优流形上,之后只沿该流形的切方向改善低优先级目标。实践中 $J^{\mathrm{H}}$ 可能秩亏或病态,因此实际使用阻尼版本,以小正数 $\lambda$ 正则化中间的 $m\times m$ 矩阵:
$$P^{\mathrm{H},\lambda}=I-(J^{\mathrm{H}})^{\top}\left(J^{\mathrm{H}}(J^{\mathrm{H}})^{\top}+\lambda I\right)^{-1}J^{\mathrm{H}}$$
逐帧可分:把立方复杂度砍成线性。对整段序列做投影的代价是灾难性的:投影矩阵规模随帧数 $T$ 与误差维数 $m$ 增长为 $(Tm)\times(Tm)$,稠密求解复杂度 $O(T^3m^3)$。作者观察到多数重定向目标在帧间可分——某帧的误差只依赖该帧的参数——于是高优先级雅可比在时间上是块对角的。记第 $t$ 帧上所有更高优先级目标雅可比的堆叠为
$$J_t^{{<k}}=\begin{bmatrix}(J_t^{1})^{\top}&\cdots&(J_t^{k-1})^{\top}\end{bmatrix}^{\top}$$
则整段投影分解为 $T$ 个互相独立的每帧系统,第 $k$ 级梯度在第 $t$ 帧的投影为
$$\tilde{g}^{k}_{t}=\left(I-(J_t^{{<k}})^{\top}\left(J_t^{{<k}}(J_t^{{<k}})^{\top}+\lambda I\right)^{-1}J_t^{{<k}}\right)g^{k}_{t}$$
每个系统只涉及一个 $m\times m$ 线性求解,$T$ 个系统作为批处理在 GPU 上并行,复杂度降为 $O(Tm^3)$。论文 Fig. 5 在 RTX 5090 上实测:稠密求解的耗时随序列长度快速上升,而逐帧公式在评估区间内几乎恒定(此时耗时由 GPU 启动开销主导),并且在超过 5000 帧的 LAFAN1 长序列上保持同样行为。这是本方法能处理 35 分钟多人协作数据的前提。
自由目标:全局正则项的正确位置。时间平滑、关节限位、地面穿透这三类目标不适合放进层次:它们作用于几乎所有自由度。若给高优先级,零空间里将不留余地给后续目标;若给低优先级,投影之后它们的影响又被高优先级雅可比削掉大半。作者的做法是把它们设为"自由目标"——不占优先级名额,梯度直接累加进总投影梯度,只起正则作用而不新增零空间约束。
加权和热身:给投影一个能走的起点。零空间投影在每次迭代都按当前高优先级目标裁剪低优先级更新,当初始动作离可行解很远时,这种裁剪会让优化难以在参数空间里做大距离移动。因此优化先用一小段均匀加权和把动作拉到合适区域,再切换到优先级层次。消融显示这一步对需要大修正的数据(LAFAN1 与 in-house)至关重要。
一次迭代的完整流程。论文 Algorithm 1 把上述部件串起来:对每个优先级 $k$,计算梯度 $g^k=\nabla_x L^k(x)$,用当前已堆叠的更高优先级雅可比 $J^{{<k}}$ 投影得到 $\tilde{g}^k$,累加进总梯度,再把本级雅可比 $J^k=\partial f^k/\partial x$ 追加到行栈;循环结束后加上自由目标梯度,做一次梯度下降 $x\leftarrow x-\alpha g_{\text{total}}$。注意雅可比行栈是逐级增长的,这保证第 $k+1$ 级的更新同时保持前 $k$ 级不变。
实验中使用的层次与缩放。作者在所有动作上共用一个三层层次:(1) 脚位置匹配,保住源动作的步态节奏;(2) 与物体或其他角色的接触保持;(3) 其余姿态与交互目标,用剩余自由度去贴近源动作。缩放策略也按场景区分:单人动作用身高比 $s_{\mathrm{s}\rightarrow\mathrm{t}}=h_{\mathrm{tgt}}/h_{\mathrm{src}}$ 均匀缩放;涉及物体时场景尺度取 $s_\dagger=1$,完整保留物体的几何与轨迹;人-人交互指定一个锚角色,$s_\dagger$ 取它的身高比,从而保持两人之间的相对空间关系。交互关键点对通过源构型的逐帧 Delaunay 四面体剖分选取。
flowchart TD
  S0["S^0: all target motions"] --> P1
  P1["Priority 1
foot-position error
min over S^0"] --> S1["S^1: foot placement preserved"]
  S1 --> P2["Priority 2
contact preservation
min over S^1"]
  P2 --> S2["S^2: hand contacts preserved"]
  S2 --> P3["Priority 3
pose and interaction
min over S^2"]
  P3 --> PROJ["project gradient into nullspace
of stacked Jacobians J"]
  FREE["free objectives
smoothness, joint limits, ground
gradients added directly"] --> PROJ
  PROJ --> UPD["x = x - alpha * g_total"]
  UPD --> OUT["retargeted motion
for RL tracking and hardware"]
flowchart LR
  DENSE["dense projection
(Tm) x (Tm) system
cost O(T^3 m^3)"] --> SLOW["solve time grows
with sequence length"]
  BLOCK["per-frame block diagonal
T independent m x m systems
cost O(T m^3)"] --> FAST["batched on GPU
near-constant runtime
even beyond 5000 frames"]
实验结果
设置。四个数据集覆盖交互复杂度的阶梯:LAFAN1(单人)、OMOMO 大箱子子集(人-物)、Inter-X 辅助子集(一人扶另一人起身)、以及 35 分钟的 in-house 双人协作搬运与递接数据。目标形态以 Unitree G1 为主。基线为三个常用方法:PHC(轨迹级关键点拟合)、GMR(逐帧逆运动学加权和)、OmniRetarget(基于交互网格的约束优化);多角色场景下基线对每个角色独立重定向。运动学指标包括地面、物体与机器人穿透的时长与深度、源支撑相内的脚滑速度与悬空高度、以位置三阶导估计的 jitter、以及源手部接触被复现的比例。RL 侧按 DeepMimic 范式为每条动作在仿真 G1 上训练独立 PPO 策略,共 50 条动作;成功定义为全程无机器人或物体偏离参考超过 0.5 米。
主对比:交互越复杂,收益越大。Table II 显示 PriMoRetarget 在所有交互设置上取得最高接触保持率:OMOMO 上 96.9%,而 PHC 63.2%、GMR 48.6%、OmniRetarget 86.4%;Inter-X 上 78.8% 对基线最高 35.2%;in-house 上 92.4% 对基线最高 29.3%。下游跟踪同样全面领先:LAFAN1 与 OMOMO 的成功率都是 100%,身体跟踪误差分别 1.8 厘米与 2.8 厘米(OMOMO 物体误差 3.0 厘米),Inter-X 成功率 93.6%、误差 4.5 厘米。单人场景各方法差距不大(GMR 与 OmniRetarget 也能到 90% 成功率),说明优先级机制的价值集中在冲突密集的交互动作上。in-house 成功率 62.6%、物体误差 47.4 厘米仍是全表最弱的一格,作者将其归因于多机器人与物体联合控制本身的难度。论文 Fig. 3 的定性对比与数字一致:基线在搬箱序列中丢手-箱接触或扭曲交互,PriMoRetarget 的手始终贴在箱面上。
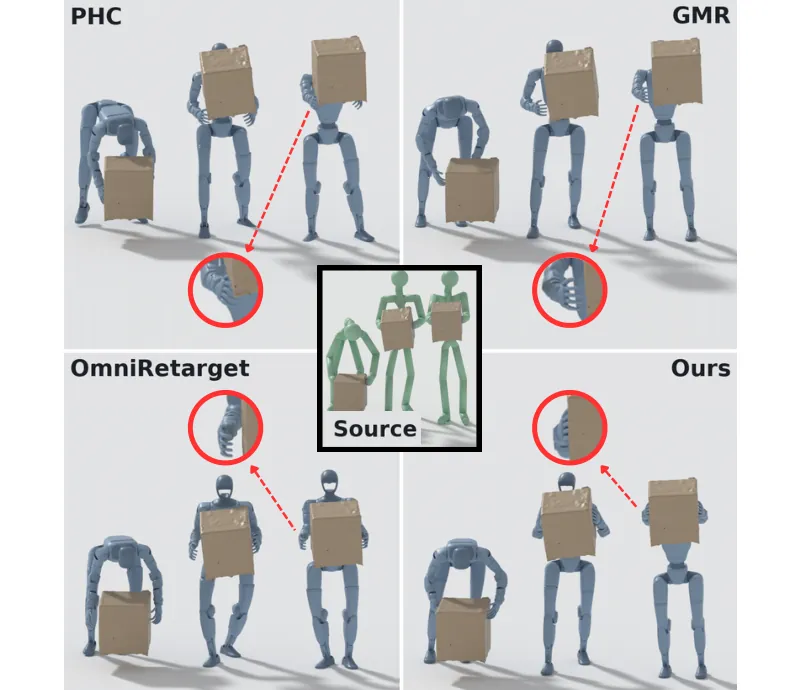
图1(论文 Fig. 3):搬箱序列上 PHC、GMR、OmniRetarget 与 PriMoRetarget 的对比,红圈为手-箱接触特写;基线丢接触或扭曲交互,本文方法保持接触。
与加权和变体对照:权重调不出优先级。Table III 用两个加权和变体隔离优先级机制本身的贡献:WS-uniform 全目标等权,WS-10× 在相邻优先级间设 10 倍权重差。单人场景三者接近(冲突少、只有两级);交互场景差距拉开:OMOMO 接触保持 96.9% 对 67.2% 与 88.5%,且 WS-uniform 的脚悬空高达 9.5 厘米、jitter 86.2;in-house 上 WS-10× 的接触保持跌到 71.7%。Fig. 4 的损失曲线给出机制层面的解释:优先级优化把前两级(脚、接触)损失压到最低,代价是 body 级损失更高;加权和则反过来用高优先级损失换 body 损失下降。这正是层次想要表达的语义:低优先级目标只有在不动摇高优先级目标时才被改善。
消融:热身与自由目标都不是可选项。Table IV 中,去掉热身(No warmup)在 LAFAN1 上把穿透时长从 12.2% 推到 90.1%、穿透深度从 3.9 厘米推到 14.1 厘米,in-house 上从 26.4% 升到 35.1%、接触保持从 92.4% 掉到 78.5%;而在初始解本就接近可行域的 OMOMO 上差异很小(12.1% 对 13.4%),说明热身的作用正是帮优化跨过初始的大距离。把自由目标塞进最后一级(Free-last)后,时间平滑被高优先级投影削弱,jitter 在 LAFAN1 上从 135.6 升到 160.4、in-house 上从 67.5 升到 88.6,接触保持虽在 OMOMO 上略升到 99.3%,但收益边际。
泛化与真机。同一套层次无需修改即可迁移到不同形态与场景:G1 与 Deep Robotics DR02 两种形态差异显著的机器人联合抬箱、H1-2 搬箱下斜坡、同一段 OMOMO 动作分别重定向到 Booster T1 与 G1;把被搬的箱子放大 1.5 倍后,手部接触会跟着新几何调整而不是死跟源动作,证明接触目标确实在支配姿态目标。Fig. 6 展示了真机部署:G1 完成 OMOMO 的踢箱与抱起序列,以及两台机器人协作搬放 in-house 大箱子。
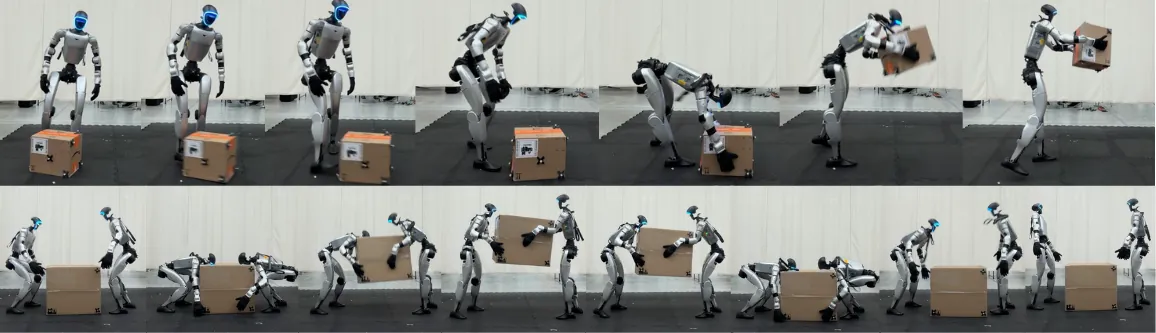
图2(论文 Fig. 6):重定向动作在 Unitree G1 上的真机部署。上:OMOMO 踢箱与抱起序列;下:in-house 双机器人协作搬放箱子。
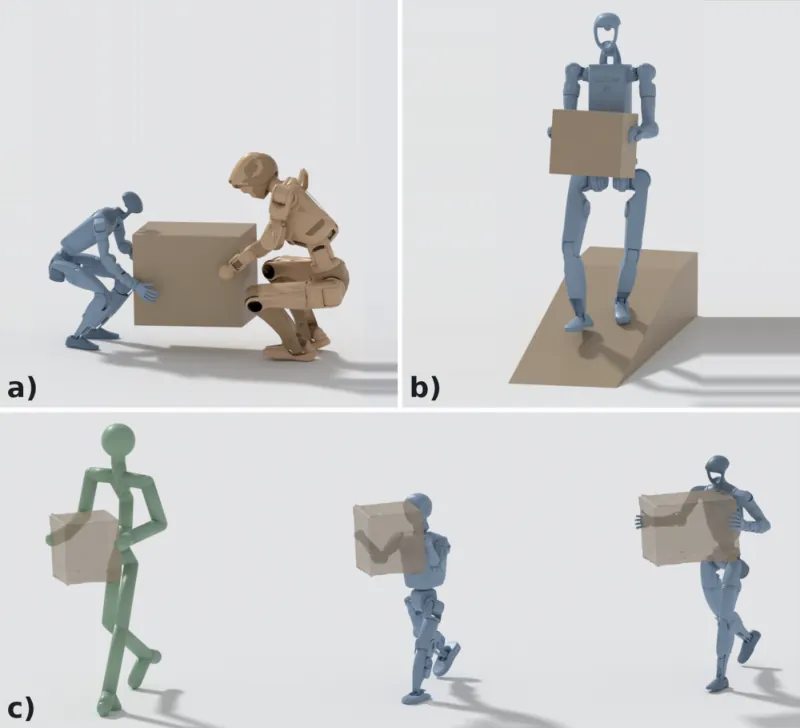
图3(论文 Fig. 7):同一优先级公式的泛化。a) G1 与 DR02 联合抬箱;b) H1-2 搬箱下斜坡;c) 源动作到 Booster T1 与 G1,且 G1 手持放大 1.5 倍的箱子。
| 数据集 / 方法 | 穿透时长 % | 脚滑 cm/s | jitter m/s³ | 接触保持 % | RL 成功率 % | 身体误差 cm |
|---|---|---|---|---|---|---|
| LAFAN1 / GMR | 12.1 | 5.2 | 216.7 | — | 90.0 | 4.0 |
| LAFAN1 / OmniRetarget | 1.5 | 9.4 | 229.4 | — | 90.0 | 5.2 |
| LAFAN1 / PriMoRetarget | 12.2 | 3.5 | 135.6 | — | 100.0 | 1.8 |
| OMOMO / PHC | 94.1 | 12.9 | 76.3 | 63.2 | 86.6 | 7.4 |
| OMOMO / GMR | 65.4 | 1.7 | 94.7 | 48.6 | 79.8 | 7.9 |
| OMOMO / OmniRetarget | 21.6 | 4.9 | 205.2 | 86.4 | 99.1 | 3.5 |
| OMOMO / PriMoRetarget | 13.4 | 3.7 | 108.0 | 96.9 | 100.0 | 2.8 |
| Inter-X / PHC | 79.0 | 8.8 | 84.0 | 35.2 | 72.8 | 8.7 |
| Inter-X / GMR | 67.8 | 3.9 | 147.2 | 26.4 | 57.2 | 15.9 |
| Inter-X / OmniRetarget | 33.6 | 3.4 | 136.7 | 26.9 | 66.1 | 12.1 |
| Inter-X / PriMoRetarget | 55.7 | 2.4 | 103.9 | 78.8 | 93.6 | 4.5 |
| in-house / GMR | 39.3 | 4.4 | 102.3 | 29.3 | 24.1 | 30.9 |
| in-house / OmniRetarget | 10.2 | 2.7 | 129.6 | 26.5 | 4.3 | 36.8 |
| in-house / PriMoRetarget | 26.4 | 1.7 | 67.5 | 92.4 | 62.6 | 12.5 |
表1(整理自论文 Table II):运动学质量与 RL 跟踪表现。PriMoRetarget 在全部交互设置上接触保持与跟踪成功率最高。
| 设置 / 变体 | 穿透时长 % | 脚滑 cm/s | 悬空 cm | jitter m/s³ | 接触保持 % |
|---|---|---|---|---|---|
| OMOMO / PriMoRetarget | 13.4 | 3.7 | 2.4 | 108.0 | 96.9 |
| OMOMO / WS-uniform | 12.4 | 9.4 | 9.5 | 86.2 | 67.2 |
| OMOMO / WS-10× | 14.4 | 3.4 | 2.9 | 98.5 | 88.5 |
| in-house / PriMoRetarget | 26.4 | 1.7 | 3.2 | 67.5 | 92.4 |
| in-house / WS-uniform | 35.0 | 3.4 | 14.0 | 52.9 | 88.8 |
| in-house / WS-10× | 30.5 | 1.9 | 5.1 | 59.1 | 71.7 |
| LAFAN1 / PriMoRetarget | 12.2 | 3.5 | 1.4 | 135.6 | — |
| LAFAN1 / No warmup | 90.1 | 10.2 | 0.0 | 168.1 | — |
| LAFAN1 / Free-last | 17.3 | 2.7 | 0.4 | 160.4 | — |
表2(整理自论文 Table III 与 Table IV):加权和变体对照与消融。权重差调不出硬性优先;热身与自由目标各自承担不可替代的作用。
局限性
源动作的伪影会被原样继承(作者自述)。论文 Section VI 明确指出,PriMoRetarget 的核心是保持源动作的结构,因此源数据中的 jitter、互穿与环境不一致都会传播到重定向结果。Table II 中部分设置下穿透与悬空高于基线(如 Inter-X 穿透时长 55.7% 高于 OmniRetarget 的 33.6%),作者也将一部分归因于源动作自带的伪影。方法没有学习先验去修复源数据,这是设计取舍而非疏漏,但意味着它不能替代动捕数据的清洗。
物体轨迹基本跟随源动作(作者自述)。被操作物体的轨迹在优化中主要由源动作决定(物体交互时 $s_\dagger=1$ 固定物体几何),当物体轨迹本身不适合目标形态时,交互难以自适应。放大箱子的实验证明接触能跟随新几何,但物体路径本身仍不可调。
优先级层次靠人工指定。实验共用一个三层层次,作者承认层次是手动设定的,自动确定或自适应层次被列为未来工作。从 Table III 也可以看出,层次语义正确时方法稳健,但"哪项目标该排第几"仍依赖使用者对任务的理解;对未见过的任务形态,这个选择没有数据支撑。此外 in-house 上 62.6% 的跟踪成功率说明,重定向质量的提升并不能单独解决多机器人协作控制的问题。
总结与展望
PriMoRetarget 的价值不在于发明了零空间投影——这个工具在机器人控制里已有三十年历史——而在于证明了它适合运动重定向这个离线、长序列、多角色的场景,并给出了让这件事变得可行的三个工程部件:逐帧分块把投影复杂度从立方降到线性,自由目标给全局正则项找到不占层次的位置,加权和热身解决投影在坏初始化下的收敛问题。实验给出的信号很清晰:交互越密集,优先级机制相对加权和的优势越大;而在单人动作上两者几乎无差,说明这套机制是为冲突而生的。
对做人形机器人数据管线的人而言,这篇论文提供了一个可直接落地的替换件:把现有重定向流程里的权重表换成一张优先级表,接触与脚部落点从此不再需要与姿态讨价还价。作者列出的未来方向——学习运动先验以修复源伪影、自动适应层次、机器人与物体轨迹联合优化——恰好对应本文三个局限,也大致勾勒出下一代重定向方法的轮廓:从保持源动作走向在保持意图的前提下修正源动作。
金句
加权和告诉优化器哪个目标"更重要",优先级层次告诉它哪个目标"不可谈判"。