PAPER DEEP DIVE
BRACE:面向力觉与地形感知的人形机器人全身参考自适应运动跟踪
全身运动跟踪已经成为操作员驱动人形机器人的标准接口,但它消费的参考轨迹都是在平地上、空手状态下录制的:跟踪器既不知道机器人要与物体交换多大的力,也不知道自己站在什么地面上。已有控制器只解决其中一侧——具备力控能力的策略只给末端执行器一个力指令而不规定全身姿态,地形自适应跟踪器则把负载当成需要抑制的扰动,而不是需要主动施加的力旋量。BRACE 选择改写参考本身:地形贴合把落脚点与根部抬到局部地表,力旋量变换则解算出产生指定手力所需的手部位移,以及它连带引起的质心与压力中心偏移,并受教师专属的手臂力矩预算约束。施加与抵抗两个特权教师分别训练,再由 DAgger 蒸馏进同一个流匹配学生,学生只依赖本体感知,不需要高度图也不需要实测力旋量。在 Unitree G1 的仿真与真机实验中,BRACE 能在斜坡上跟踪平地参考的同时施力或抗力,全局跟踪误差平均降低 40%,成功率平均提升 18.25 个百分点。
标题:BRACE: Adapting Whole-Body References for Force and Terrain Aware Humanoid Motion Tracking
作者:Sudarshan Harithas, Chen Yu, Juan Borbon, Shubhankar Mondal, Winston Zha, Srinath Sridhar, Dingqi Zhang, Jiuguang Wang(Multiply Labs、Brown University、University of New Mexico)
链接:arXiv:2610.07052v1 · 项目页 · 仓库 multiplylabs/brace
代码状态:待发布。multiplylabs/brace 目前只承载项目页与 teaser 媒体,README 标注「Code coming soon」。方法建立在开源训练框架 ProtoMotions(NVLabs,Apache-2.0,2.4k stars)之上,其 protomotions/agents/supervised/ 目录实现了「学生 rollout、专家打标、监督损失」的蒸馏循环;真机部署链路基于 RoboJuDo。
平台:29 自由度 Unitree G1,仿真在 Isaac Lab / Isaac Sim,真机同型号。
一句话总结
BRACE 不去改造控制器,而是改造被跟踪的参考本身:把地形贴合与力旋量变换解析地折进全身参考,再用 DAgger 把「施力」与「抗力」两个特权教师蒸进一个只吃本体感知的流匹配学生,使操作员只给一条平地轨迹,机器人就能在斜坡上自行解算坡度与负载。
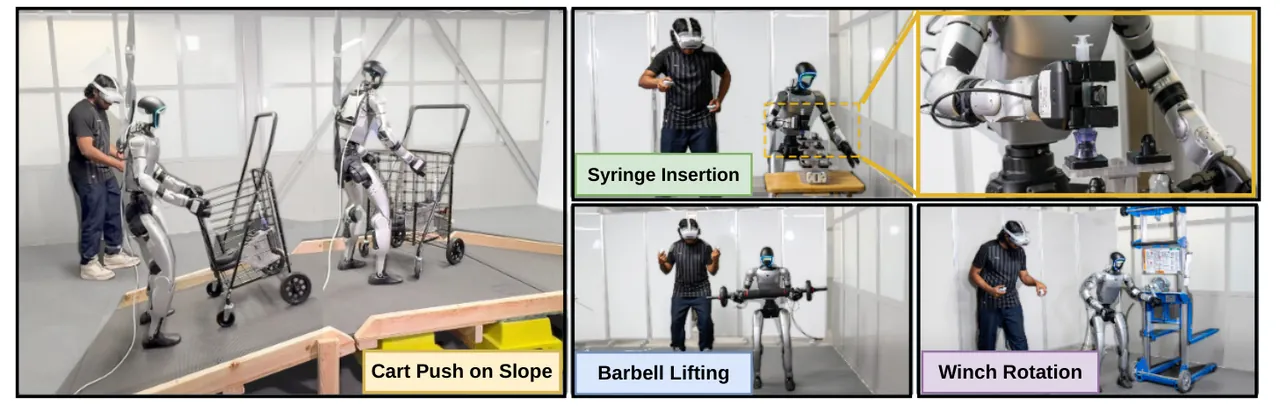
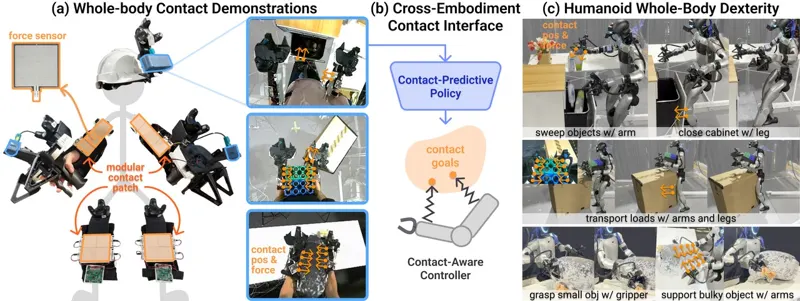
图 1:BRACE 的任务面。左:在斜坡上推购物车;右:注射器插入(线性力)、杠铃提起(重载补偿)、绞盘旋转(角力矩)。
研究背景与动机
全身运动跟踪(whole-body tracking, WBT)已经成为人形机器人从人类动作到机器人动作的标准通路:从演示者重定向得到的轨迹交给控制器,控制器在复现参考的同时保持机器人直立。这条路线之所以能规模化,是因为它的数据规模化了——动捕与野外视频源源不断地供给参考轨迹,最近的系统甚至把跟踪器直接当作遥操作接口,为下游策略采集演示。
但这些语料里没有力。演示者是在平地上、空手状态下被录制的,记录保留了身体走过的路径,却没有保留它承受过的负载与吸收过的反作用。对行走与手势而言损失不大;对人形机器人真正要做的活而言,丢失的恰恰是任务规格本身:搬一个载荷、顶着闭门器拉门、扶住工件同时拧工具,这些任务由机器人与环境交换的力旋量 $w=[F,\tau]$ 定义的程度,不低于由轨迹定义的程度。地形以同样的理由缺失,而在遥操作下两种缺失会互相叠加:操作员站在平地的捕捉体积里空手比划,机器人却抱着箱子走坡道。
已有控制器各执一端。具备力控能力的腿足系统接受一个末端执行器力加一个基座速度指令,或者用阻抗参数替代力;由于它们不规定稠密的全身姿态,「在保持某个姿态的同时产生某个力」这个问题根本不会出现。地形自适应控制器从本体感知推断地面几何,但把负载与推搡当作需要抑制的扰动,而不是需要主动施加的力旋量。
把两者塞进同一条全身参考之所以困难,是因为两个信号都与参考矛盾。惯例上,指令力旋量靠位移末端执行器来实现;若只位移手而不调整身体其余部分,反作用到达的瞬间机器人就会失去平衡,而跟踪器被要求保持的姿态也与能产生该力的姿态分道扬镳。操作员的支撑面同样不是机器人的支撑面,参考的落脚点与根部高度因此系统性错误;更麻烦的是,没有任何数据集把重定向后的人形动作与它执行时所在的地形配对,于是这种修正无法被直接学出来。
BRACE(Body Reference Adaptation for Contact and Elevation)把冲突消解在源头:修正参考,而不是修正控制器。一条平地参考被解析地适配到机器人所站的地形与它被要求施加的力旋量上,于是跟踪适配后的参考本身就给出了任务所需的落脚点、手部位移与支撑姿态。两个特权教师在这些参考上学习——一个施加指令力旋量,一个顶住外部力旋量保持参考——再被蒸进同一个流式学生,学生只凭本体感知与操作员指令运行,在线推断地形与负载。
预备知识
其一是目标空间重定向(goal-space redirection):策略不直接观察适配后的目标 $x^{\star}$,而是观察从平地参考派生的目标 $s_g$,奖励却在 $x^{\star}$ 上评估。这样特权信息(地形、负载)只存在于奖励与教师训练阶段,学生侧无需这些信号。
其二是弹簧-阻尼合规模型。任务空间力的产生被建模为沿力方向的弹簧-阻尼:手朝接触方向位移 $\delta_p$,位移量与方向刚度 $k_F$ 的乘积即产生的力。方向刚度不是凭空设定的常数,而是从关节级 PD 增益经雅可比投影推出来的,因此「到达位移后的目标」与「产生目标力」是同一件事。
其三是流匹配(flow matching)与 DAgger。当同一个本体感知状态在不同交互模式下对应截然不同的动作时,条件动作分布是多模态的;均方回归会把模式平均成一个谁都不像的动作,流匹配则显式建模整个分布。DAgger 让学生在自身 rollout 到达的状态上接受教师打标,缓解行为克隆的协变量偏移。
方法详解
总体框架。BRACE 的输入只有两个操作员信号:从人类动捕重定向得到的平地运动学参考 $x_{\mathrm{ref}}$,以及一组指令手力旋量 $w_{\mathrm{cmd}}=\{w_h\}_h$,其中 $w_h=[F_h;M_h]\in\mathbb{R}^6$ 给出每只手的力与力矩。$x_{\mathrm{ref}}$ 与地形几何 $\mathcal{H}$ 冲突(它假设平地),也与 $w_{\mathrm{cmd}}$ 冲突(施力或抗力需要全身支撑与接触位移,空手的人类录制里没有这些)。若用辅助奖励让强化学习自己去发现这些修正,轨迹跟踪奖励会惩罚恰恰必需的姿态偏差,造成信号冲突。BRACE 在策略学习之前解析地变换 $x_{\mathrm{ref}}$,把学习问题降格为「跟踪几何适配、力矩受限的目标」:
$$x_{\mathrm{ref}}^{T}=\mathcal{T}(x_{\mathrm{ref}},\mathcal{H}),\qquad x_{E}^{\star}=\mathcal{F}(x_{\mathrm{ref}}^{T},w_{\mathrm{cmd}}),\qquad x_{C}^{\star}=x_{\mathrm{ref}}^{T}$$
抗力教师跟踪 $x_C^{\star}=x_{\mathrm{ref}}^{T}$(只做了地形适配),施力教师跟踪进一步做了力旋量适配的 $x_E^{\star}$。
地形调整 $\mathcal{T}$。运动学重定向忽略局部地表高度,在坡面与台阶上产生落脚点误差。对每个脚部接触目标 $(x_f,y_f,z_f^{\mathrm{ref}})$,$\mathcal{T}$ 保持水平位置不变,把高程抬到 $z_f^{T}=\mathcal{H}(x_f,y_f)+z_f^{\mathrm{ref}}$,从而保留相对局部地面的摆动 Clearance;根部高程跟随基座下方的地形;局部表面法向旋转脚部朝向目标,而根部朝向仍与行进方向对齐。最后一步全身逆运动学(IK)把脚与根的调整与上身姿态调和起来,产出地形适配参考 $x_{\mathrm{ref}}^{T}$。
力旋量调整 $\mathcal{F}$ 的三段式。产生外力需要末端执行器压进接触,同时质心(COM)偏移以抵消反作用。$\mathcal{F}$ 先把指令力旋量截断到可行力旋量 $w^{\star}=[F^{\star};M^{\star}]$,再把 $w^{\star}$ 转成协调的手部引导与质心偏移,对应图 2 中的三个标注。
① 可行性上限。两个教师都要判断手臂能支撑哪些力旋量:Teacher-E 用来截断它要求机器人施加的量,Teacher-C 用来截断它作为扰动施加的量,二者共用同一条约束。力与力矩消耗同一批手臂关节力矩,因此必须联合约束而非分开约束。记单手的力与力矩为 $F,M$,平移与旋转手臂雅可比 $J_p,J_r$ 把力旋量映射到关节力矩,教师专属裕度 $0<\gamma<1$ 把它压在关节力矩预算内:
$$\bigl|\bigl(J_{p}^{\top}F+J_{r}^{\top}M\bigr)_{i}\bigr|\leq\gamma\,\tau_{i}^{\mathrm{budget}}$$
预算本身按教师区分:Teacher-E 在地形适配参考处取执行器上限 $\tau_i^{\mathrm{budget}}=\tau_i^{\max}$;Teacher-C 在当前机器人构型处取带地板的剩余力矩代理(见式 6)。对 Teacher-E,这条约束与手部行程上限一起把 $w_{\mathrm{cmd}}$ 变成 $w^{\star}$;接触加权的脚支撑多边形及其侵蚀内边界则限制压力中心行程与质心支撑量,一个共享的支撑比例同时缩放两手的力与力矩指令,并做平滑与下界处理以跨越步态切换。
② 手部引导。任务空间力产生被建模为沿力方向 $\hat{n}=F^{\star}/\|F^{\star}\|$ 的弹簧-阻尼合规。给定对角关节刚度 $K_q$ 与阻尼 $D_q$,方向刚度 $k_F$ 与手部位移 $\delta_p$ 满足:
$$k_{F}^{-1}=\hat{n}^{\top}J_{p}K_{q}^{-1}J_{p}^{\top}\hat{n},\qquad d_{F}\dot{\delta}_{p}+k_{F}\delta_{p}=\|F^{\star}\|$$
方向阻尼 $d_F$ 由 $D_q$ 类比定义。从关节增益推出 $k_F$ 的意义在于:引导量与 PD 控制手臂的真实合规一致,因此到达位移后的目标就产生 $F^{\star}$。旋转引导由旋转刚度 $k_M$ 与力矩方向 $\hat{m}=M^{\star}/\|M^{\star}\|$ 走同一套公式。方向只对非零指令定义:低于 1 N 或 0.3 N·m 的指令被置零,对应引导消失,方向刚度与阻尼回落到默认常数。
③ 质心支撑。持续的手部力旋量会在脚部产生倾覆力矩,必须靠躯干前倾抵消。抵消反作用力旋量 $-w^{\star}$ 所需的水平质心偏移为:
$$\Delta c=\frac{\hat{z}\times\sum_{h}\bigl[(p_{h}-c_{\mathrm{cop}})\times(-F_{h}^{\star})-M_{h}^{\star}\bigr]}{mg}$$
其中 $p_h$ 是接触手的位置,$c_{\mathrm{cop}}$ 是接触加权的脚质心(近似压力中心),$m$ 为机器人质量,$g$ 为重力加速度,$\hat{z}$ 为竖直单位向量。支撑多边形内的压力中心行程吸收 $\Delta c$ 的一部分;有界的剩余部分构成支撑量,其中一半由手部目标继承。最后,全身 IK 把位移后的手部目标、支撑后的质心位置与地形适配后的脚位置调和成运动学可行的适配目标 $x_E^{\star}$。
Teacher-E:施力。Teacher-E 观察地形不变的目标 $s_g^E$:平地参考叠加手部引导与质心支撑、并去掉绝对根部高程。指令力旋量只通过这组位移进入策略。但仅跟踪不会产生任何力——空仿真里手到达位移后的目标并不受力。于是引入锚定在地形适配参考手部的虚拟力旋量场:对手部沿 $\hat{n}$ 的平移 $p$ 与绕 $\hat{m}$ 的扭转 $\theta$(均相对躯干姿态测量),
$$f_{\mathrm{meas}}=k_{F}(\bar{p}+b/2)+d_{F}\dot{p},\qquad m_{\mathrm{meas}}=k_{M}\theta+d_{M}\dot{\theta}$$
其中 $\bar{p}$ 是 $p$ 平滑截断到允许行程后的值,$b$ 是沿 $\hat{n}$ 的计划支撑量。$b/2$ 这一项把未被手部目标继承的那一半支撑记入弹簧力,于是「朝接触倾斜身体」也算作施力。仿真器在手部施加反作用 $-w_{\mathrm{meas}}$。奖励对 $x_E^{\star}$ 评跟踪、对归一化力旋量误差与运动平滑度评分;力旋量误差对可行目标 $w^{\star}$ 而非 $w_{\mathrm{cmd}}$ 计算,因此策略被「地形与关节预算允许做到什么」来评判。总奖励为 $r_{\mathrm{exert}}=r_{\mathrm{tracking}}+r_{\mathrm{wrench}}$。
Teacher-C:抗力。Teacher-C 跟踪 $x_C^{\star}=x_{\mathrm{ref}}^{T}$,同时仿真器在手部施加外部力旋量 $w_{\mathrm{ext}}$。抵抗这类力旋量要求在负载下保持参考姿态、且在负载消失时不过度纠正。沿用 FALCON 的力矩感知课程,负载由在当前构型处评估的式 2 界定,预算取带地板的剩余力矩:
$$\tau_{i}^{\mathrm{budget}}=\max\bigl(\tau_{i}^{\max}-|\tau_{i}|,\ \epsilon\,\tau_{i}^{\max}\bigr)$$
其中 $\tau_i$ 是已经花在重力与跟踪上的力矩,$\epsilon>0$ 保留最小余量。手坐标系内的随机施加点 $r_h$ 附加力矩 $r_h\times F_h$,使力与力矩被联合约束。负载剖面用随机三角脉冲扫过力与力矩,脉冲之间夹无载区间,让策略见到负载释放;自适应课程在持续成功后抬升每个环境的负载比例、跌倒后下调。特权编码器接收施加力旋量的短历史,使教师能在负载到达峰值之前提前支撑。Teacher-C 只拿跟踪与正则奖励——补偿行为是从负载下的跟踪误差最小化中涌现的。
共享教师架构。两个教师用同一套架构:演员观察从平地参考派生的目标($s_g^E$ 或 $s_g^C$)而非适配目标 $x^{\star}$,奖励在后者上评估;其余输入是本体感知(关节位置与速度、基座角速度、重力方向)、短观测历史与一个特权潜变量。特权编码器把地形高度扫描、根部相对地形的高度、以及教师专属通道(Teacher-E 的表面法向、Teacher-C 的施加力旋量历史)压进这个潜变量。策略主干共享两个头:动作头输出 29 个驱动关节的位置目标;辅助重建头预测 $x^{\star}$,强迫主干表征全身姿态修正。两者都用 PPO 与额外观察完整仿真器状态的非对称 critic 训练,训练后只保留动作头。
流式学生蒸馏。教师依赖机器人不具备的特权地形与力旋量信号,因此用 DAgger 把两者蒸进一个可部署学生。模式标志 $\mu\in\{E,C\}$ 在训练 rollout 中选择生效教师;rollout 中包含模式切换过渡(把生效负载斜坡降到零、切换模式标志、斜坡引入新力旋量),使运动中途的模式切换被覆盖。注意学生只消费平地运动目标 $s_g^{E,C}$——这是推理时可得、可由遥操作员提供的量。
学生三块结构。施力与抗外部负载在几乎相同的本体感知状态下要求截然不同的关节动作,因此无目标基网络的条件动作分布是多模态的,流匹配建模该分布而非平均它。其一,流匹配基:把高斯噪声映射为基关节位置动作,条件仅为 25 帧本体感知历史 $s_p$,不含目标与模式标志;其二,任务编码器:把本体感知及其历史、平地目标 $s_g^{E,C}$、模式标志 $\mu$ 与指令力旋量 $w_{\mathrm{cmd}}$ 映射为紧凑任务潜变量;其三,动作解码器:把基动作与任务潜变量合成实际执行的关节指令。训练损失包括对选中教师动作的行为克隆、基网络的流匹配损失、按手部力敏感度加权的施力损失,以及下面的估计回归。
地形与负载估计。学生要直接上真机,而机载传感器既看不到地形几何也测不到外部力旋量,因此学生必须从本体感知动力学推断两者。一个辅助估计头在训练期从任务潜变量回归特权仿真器状态(局部手位置、根部速度、外部力旋量、表面法向、根部相对地形高度);导出时该头被丢弃,部署的学生只观察本体感知、目标、模式标志与指令力旋量。
实现与部署细节。所有策略以 50 Hz 输出 29 自由度 G1 的 PD 位置目标,流基每个动作用 4 步欧拉积分;教师用 8 帧观测历史,学生用 25 帧;高度扫描是基坐标系下覆盖 2.0 m × 2.0 m 的 16 × 16 网格,力旋量历史跨 3 帧;两个教师共用 $\gamma=0.7$;$\mathcal{F}$ 中手部行程预算 0.15 m,支撑多边形侵蚀 0.02 m;方向刚度设下界保数值稳定,支撑多边形比例低通滤波以平滑跨越双支撑到单支撑的切换。抗力教师训练到 20 N,施力教师训练到 9 N,两者力矩上限 4 N·m——这些设定落在 G1 手臂物理极限之内。教师与学生各用 8 张 NVIDIA RTX Pro 6000 训练,每卡 2048 个环境、批大小 8192,框架为 Isaac Lab 上的 ProtoMotions;参考轨迹来自 Bones-Seed,用文本语义挑出移动与物体操作数据,约 65k 条;真机部署链路基于 RoboJuDo。
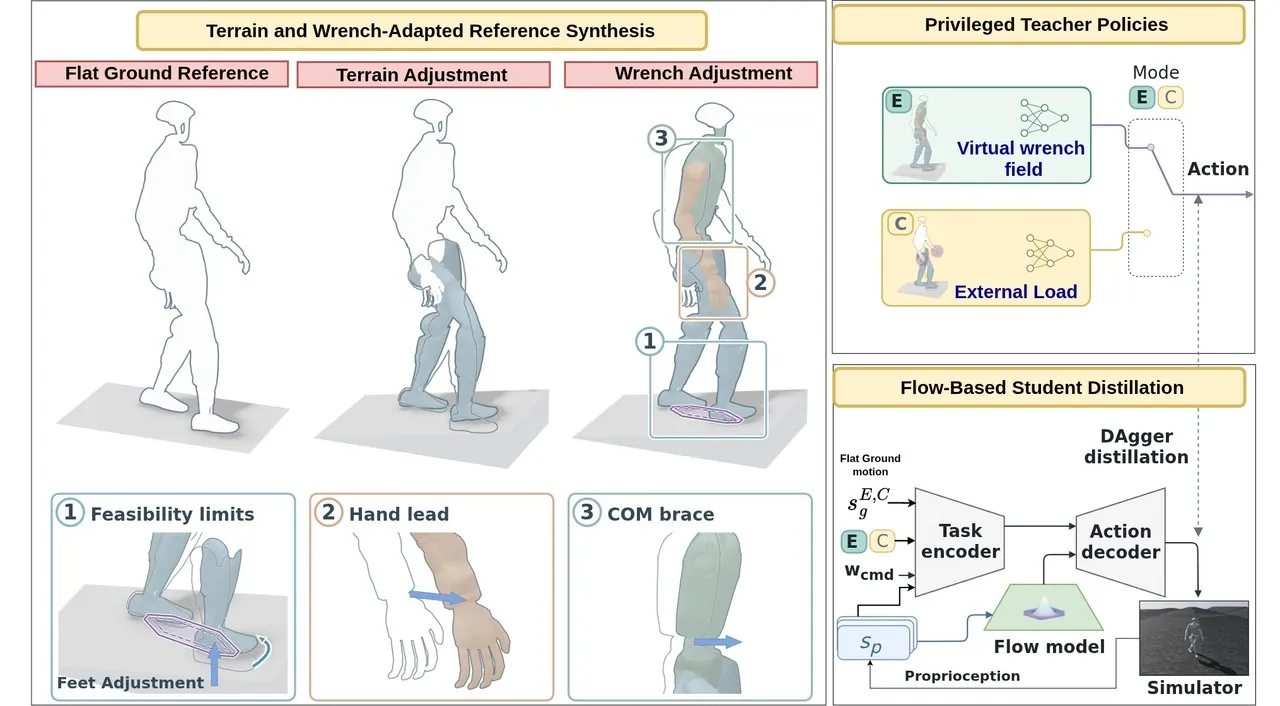
图 2:BRACE 总览。左:地形与力旋量适配的参考合成——平地参考经脚对齐得 $x_{\mathrm{ref}}^{T}$,再经 ① 可行性上限、② 手部引导、③ 质心支撑得 $x_E^{\star}$。右上:特权教师——Teacher-E 在虚拟力旋量场下学施力,Teacher-C 在外部负载下学补偿,模式开关 $\mu$ 切换。右下:DAgger 把两位教师蒸进单一学生——任务编码器吃平地目标、模式与指令力旋量,流匹配基建模本体感知历史上的动作分布,动作解码器融合两者。
flowchart TD
  A["平地参考 x_ref 约65k条 Bones-Seed 轨迹"] --> B["地形调整 T 脚与根抬到局部地表"]
  B --> C["x_ref^T 地形适配参考"]
  C --> D["力旋量调整 F"]
  D --> D1["1 可行性上限 式2 式6"]
  D --> D2["2 手部引导 弹簧阻尼 式3"]
  D --> D3["3 质心支撑 式4"]
  D1 --> E["x_E 星 施力目标"]
  D2 --> E
  D3 --> E
  C --> F2["x_C 星 等于 x_ref^T 抗力目标"]
  E --> G["Teacher-E 虚拟力旋量场 式5"]
  F2 --> H["Teacher-C 外部负载三角脉冲课程"]
  G --> I["DAgger 蒸馏 模式开关 mu 含切换过渡"]
  H --> I
  I --> J["任务编码器 平地目标 模式 指令力旋量"]
  I --> K["流匹配基 25帧本体感知历史"]
  J --> L["动作解码器"]
  K --> L
  L --> M["29关节 PD 目标 50Hz 仅本体感知部署"]
实验结果
协议。基线为最先进的全身运动跟踪器 SONIC、TWIST2、Any2Track,以及面向载荷的 HEFT;力指令型控制器(UNIFP、FACET)不参与对比,因为它们不接受全身参考轨迹,除非重定义其指令接口否则无法进入本协议。评测在 Isaac Lab 的并行 GPU 仿真中进行,平台为 29 自由度 G1,各基线保留自身的观测、动作解码与关节增益;BRACE 的全部结果都来自部署版学生——它既不看仿真器高度图,也不看施加的补偿力旋量。动作来自 PHUMA 数据集与 Bones-seed 的留出测试集(由训练集之外的动作构成),所有方法用同一份合并测试集。抗力协议保持运动参考不变,每只手承受 0–20 N 的恒定负载,方向在球面上均匀采样且整集固定;施力协议给每只手 3–9 N 的力指令(躯干航向坐标系),并跟踪力补偿后的参考;地形为标称坡度 4.6–17.7 度的斜坡(实际坡度沿轨迹变化),两种地形设置下策略都只拿平地参考、必须凭本体感知盲处理坡面。成功判据对全体方法一致:全程躯干、腕、踝高度各自偏离参考不超过 0.25 m 且躯干朝向误差不超过 1 rad;平地再要求躯干水平距离全程均值不超过 0.5 m,地形则要求 MPJPE-G 不超过 0.5 m。
抗力:平地与斜坡。平地上无载时各方法表现相当,SONIC 保持更低的局部姿态误差——这对专精模仿的跟踪器是意料之中。随负载增大,所有基线稳定退化而 BRACE 退化平缓,曲线在 15 N 处交叉;在最高测试负载每只手 20 N 处,BRACE 的成功率领先最优基线 10.7 个百分点。全局误差面板解释了基线输在哪里:它们的 MPJPE-G 在整个扫描区间翻倍以上,BRACE 的涨幅小得多,最终比最优基线(包括专为载荷补偿训练的 HEFT)低 40%;局部误差全程与 SONIC 相差在 10% 以内,说明基线丢的不是姿态保真度,而是被推离了预定位置。斜坡上排序不再依赖负载:BRACE 在零负载时就领先,差距在 20 N 处扩大到 22.9 个百分点,是平地裕度的两倍;全局误差最终比最优基线低 43%,而局部误差与 SONIC 难以区分。所有方法拿到的都是同一条平地参考且无任何地形信息,差别只在于各策略如何把它与自己感觉到的坡面调和:基线字面地跟踪平地参考从而滑离目标,BRACE 的地形贴合训练让它既站在坡上又顶住负载。
施力:平地与斜坡。平地上所有模型都被喂平地力补偿参考 $s_g^E$;仿真中一个虚拟弹簧-质量-阻尼在运动中作用于机器人,提供真实交互所需的反作用。基线能施小力但施不了大力:3 N 指令下 SONIC 与 HEFT 在多数动作上成功,力误差与 BRACE 相差约 1 N 以内;指令增大后 SONIC 的成功率掉 20 个百分点以上、全局误差翻倍以上,HEFT 退化更缓。BRACE 的成功率与全局误差在 3–9 N 全区间几乎水平;9 N 处比 HEFT 的成功率高 5.7 个百分点、全局误差低 35%,并在每个指令上取得最低力误差,9 N 处相对最近基线降低 34%。地形设置把两种需求叠加:在未被观察的坡面上从多样姿态施力。BRACE 的成功率在整个指令区间保持水平、与其无载地形跟踪率持平,而 SONIC 从 3 N 到 9 N 掉近 30 个百分点,HEFT 起点更低且继续下滑;9 N 处的裕度达 33.7 个百分点,是四个设置中最大的,全局误差低 42%、力误差低 47%。四张面板一致地表明:设置越难,BRACE 的优势越大,且优势来自保住全局位置与力精度,而非更紧的姿态模仿。
| 设置 | 最高负载 / 指令(每只手) | 成功率相对最优基线 | 全局误差 MPJPE-G | 力误差 |
|---|---|---|---|---|
| 抗力 · 平地 | 20 N | +10.7 个百分点 | 低 40% | — |
| 抗力 · 斜坡 | 20 N | +22.9 个百分点 | 低 43% | — |
| 施力 · 平地 | 9 N | +5.7 个百分点(对 HEFT) | 低 35% | 低 34% |
| 施力 · 斜坡 | 9 N | +33.7 个百分点 | 低 42% | 低 47% |
力矩分析。真实任务常常需要力矩乃至完整力旋量:如图 1 所示,旋转叉车绞盘需要力矩控制。论文在平地与斜坡上报告 0.5–2.5 N·m 指令力矩的力矩误差:BRACE 在每个指令上都最低,平地比最近基线低 33%、斜坡低 32%,说明它施加的是被指令的完整力旋量而不只是力。
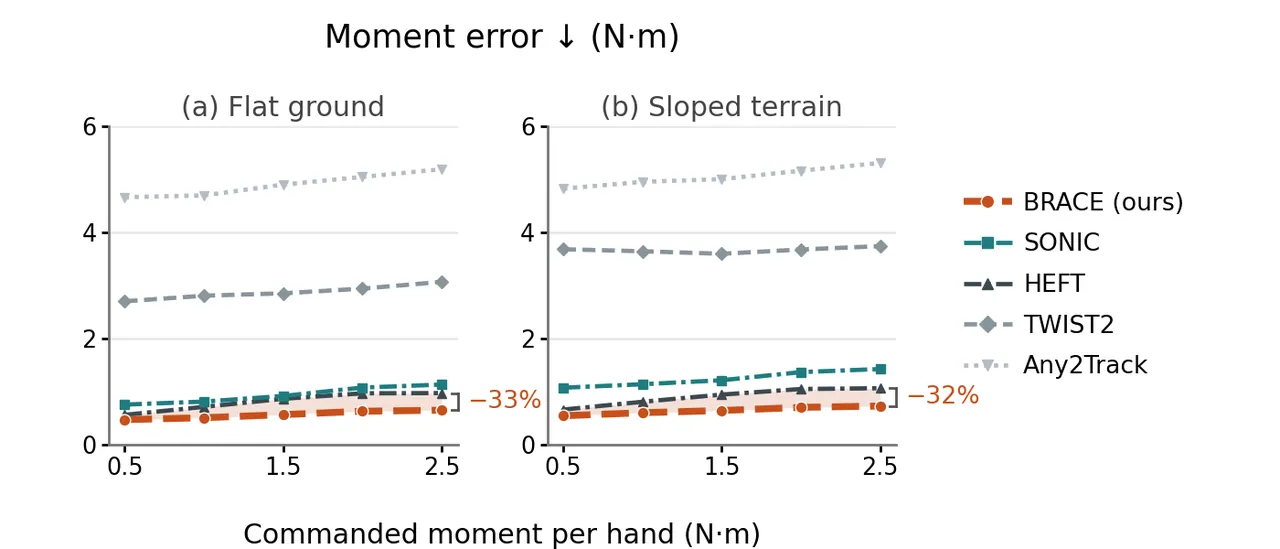
图 3:0.5–2.5 N·m 指令力矩下的力矩误差。左:平地;右:斜坡。BRACE 全程最低,平地低 33%、斜坡低 32%。
| 项目 | 设定 |
|---|---|
| 机器人与控制 | 29 自由度 Unitree G1,PD 位置目标 50 Hz,流基每动作 4 步欧拉积分 |
| 观测历史 | 教师 8 帧;学生 25 帧;力旋量历史 3 帧 |
| 特权地形输入 | 基坐标系 16 × 16 高度扫描,覆盖 2.0 m × 2.0 m |
| 手臂力矩约束 | 两教师共用 γ = 0.7;手部行程预算 0.15 m;支撑多边形侵蚀 0.02 m |
| 力 / 力矩训练上限 | 抗力教师 20 N;施力教师 9 N;力矩 4 N·m(G1 手臂物理极限内) |
| 训练规模 | 教师与学生各 8 × NVIDIA RTX Pro 6000;每卡 2048 环境、批 8192;Isaac Lab + ProtoMotions |
| 参考数据 | Bones-Seed 文本语义筛选(移动 + 物体操作),约 65k 条轨迹 |
| 成功判据 | 躯干/腕/踝高度偏差 ≤ 0.25 m 且躯干朝向误差 ≤ 1 rad;平地躯干水平均值 ≤ 0.5 m;地形 MPJPE-G ≤ 0.5 m |
真机与应用。BRACE 的策略直接部署在 Unitree G1 上。应用面包括四条:其一,VLA 集成——用 362 条「把三根香蕉从桌面移入容器」的遥操作 G1 演示微调 GR00T N1.7 3B,使其从视觉、本体感知与固定指令预测全身与 Dex3 手部指令,并在硬件上自主执行;其二,远程遥操作——在相距约 1000 英里的两站之间遥操作,BRACE 把操作员的参考适配到机器人所在地形;其三,VR 遥操作——PICO 手柄姿态经 XRoboToolkit 流入、用 GMR 重定向到 G1,BRACE 在不同地形与负载下跟踪这些参考;其四,交互模式——游戏手柄的根部速度指令驱动 MotionBricks 生成全身 G1 轨迹,BRACE 在硬件上同时跟踪这两类参考源。
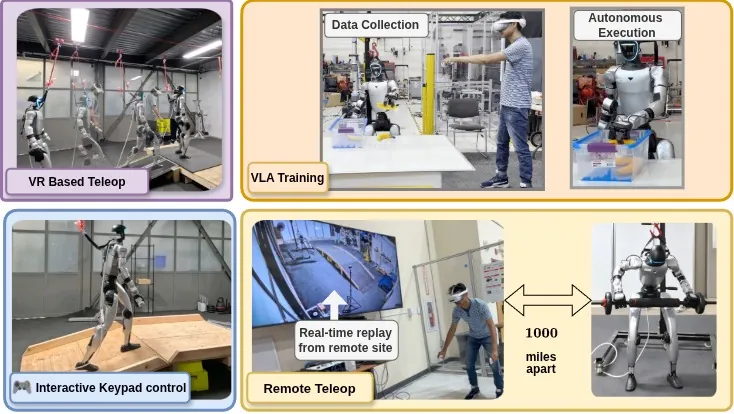
图 4:BRACE 的应用面。VR 遥操作与游戏手柄交互提供参考源;遥操作演示用于 VLA 训练与自主执行;跨约 1000 英里的远程遥操作中,BRACE 在机器人侧适配地形与负载。
局限性
其一,作者自述:与力指令型控制器的相对力精度仍未测试。BRACE 的对比对象是运动跟踪器与载荷跟踪器;UNIFP、FACET 这类直接吃力指令的控制器因为不接受全身参考而被排除在协议之外,因此「BRACE 的力精度相对专业力控器如何」这个问题在论文里是悬置的。
其二,作者自述的范围限定:BRACE 聚焦以本体感知为中心的全身控制,只处理本体感知可解的非平地地形——坡面、粗糙面不一致、小平台。需要视觉前瞻的地形(离散台阶、沟壑、需要落脚规划的障碍)不在覆盖范围内,因为学生侧没有任何外感受输入。
其三,力与力矩的量程受平台物理限制:抗力训练到 20 N、施力到 9 N、力矩到 4 N·m,都是 G1 手臂极限内的保守设定。搬箱、扶重型工件这类真正的大负载任务超出当前量程,论文的成功率与误差曲线也只在这些量程内给出。
其四,适配是解析且准静态的:手部引导用弹簧-阻尼稳态关系、质心支撑用 $mg$ 的静力平衡,未建模动态瞬态、接触摩擦锥与抓握稳定性;定量对比全部在仿真中完成,真机部分为定性演示,且成功判据(0.25 m 高度容差、1 rad 朝向容差)相对宽松,姿态层面的细粒度保真度需要结合 MPJPE-L 一起读。
总结与展望
BRACE 把「力」与「地形」这两件全身跟踪语料里缺失的事,从控制器侧搬回了参考侧:地形贴合抬脚与根,力旋量变换解手与质心,两个特权教师各学一种交互范式,再被 DAgger 蒸进一个只吃本体感知的流匹配学生。结果是操作员可以继续给最简单的输入——一条平地轨迹加一个力指令——而坡度与负载由机器人 onboard 解算。在四个设置的最重负载或最高指令处,BRACE 平均把全局跟踪误差降低 40%、成功率提升 18.25 个百分点,并在真机上完成注射器插入、绞盘旋转、杠铃提起与斜坡推车。把参考当作可适配的接口而非神圣的 Ground Truth,这条思路对遥操作、VLA 数据采集与跨站作业都有直接价值:下一步自然是把量程推到平台极限之外、把视觉前瞻接进学生、以及与专业力控器在同一力精度标尺下正面比较。
金句
记录保留了身体走过的路径,却没有保留它承受过的负载与吸收过的反作用——而对人形机器人真正要做的活而言,丢失的恰恰是任务规格本身。