SeeQ:通用语言条件价值函数,把长程操作成功率接近翻倍
视频加载中
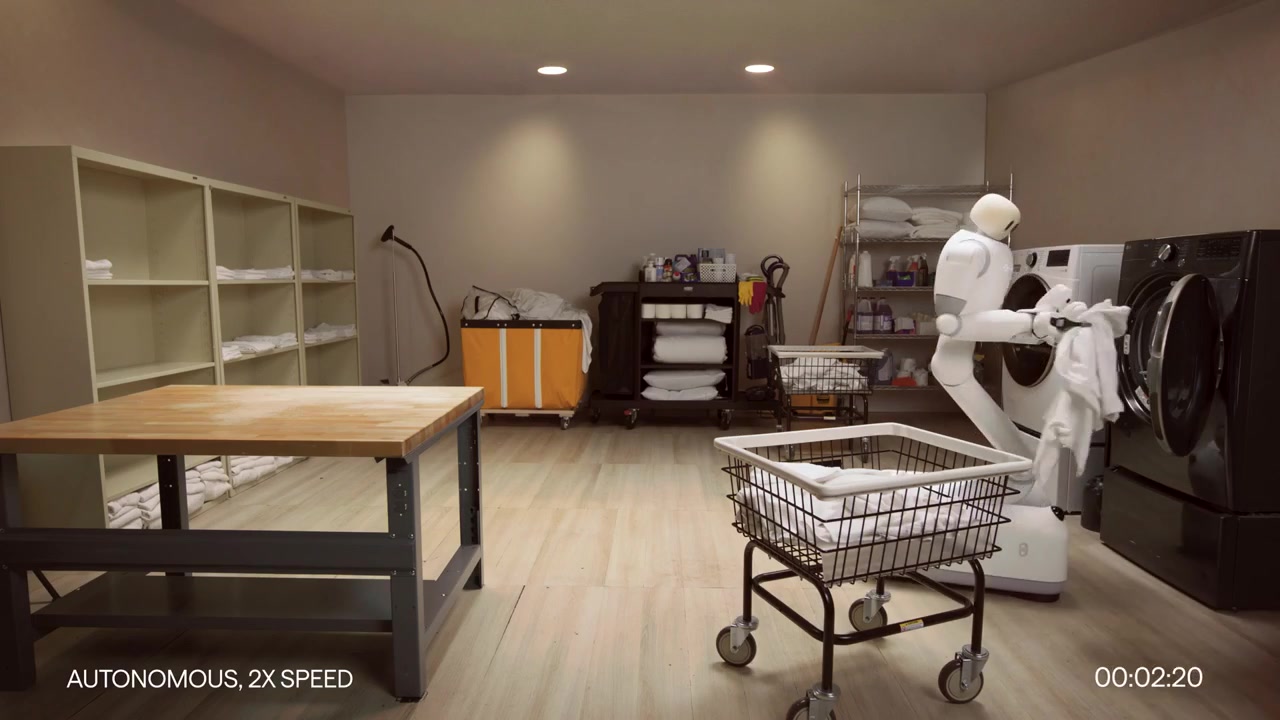
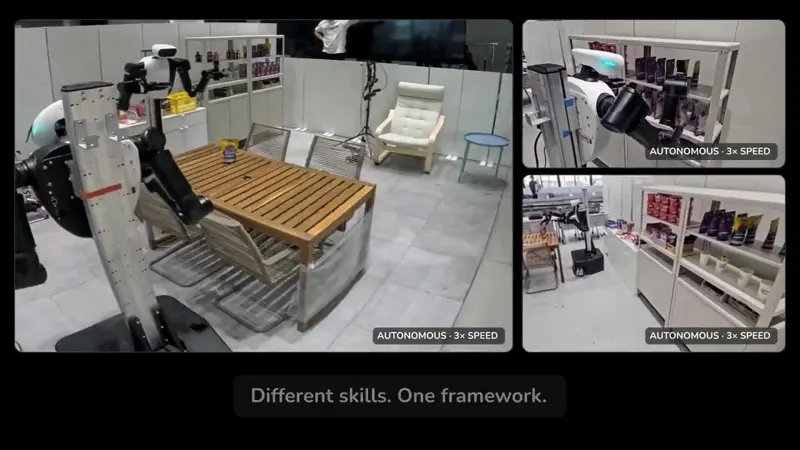
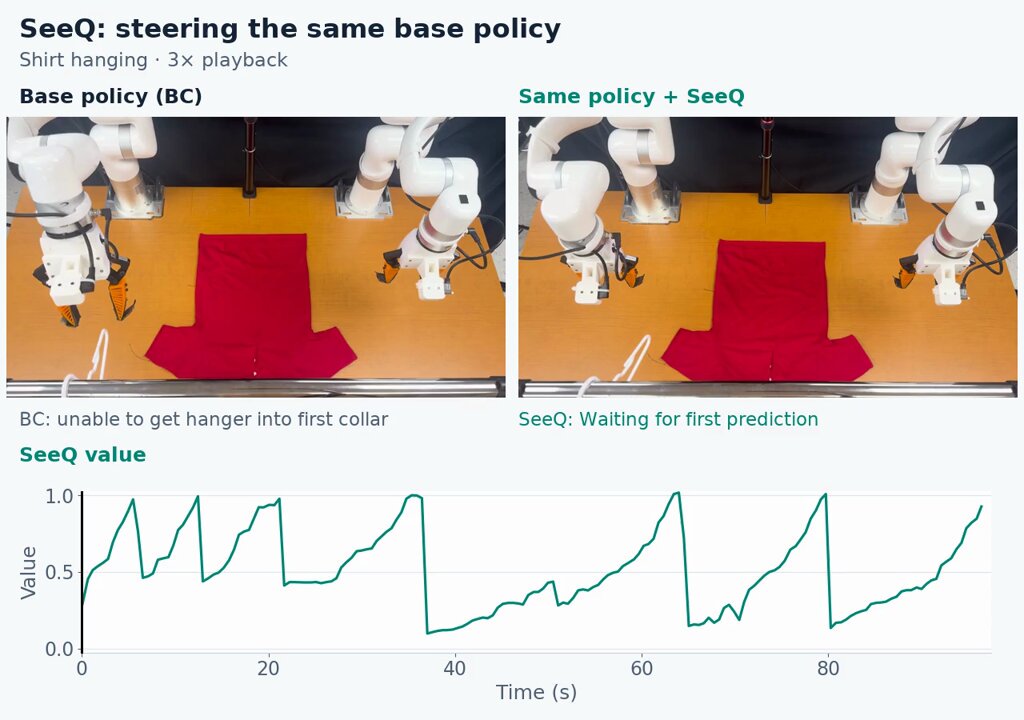
视频加载中CMU 团队(Saksham Singh 等,arXiv:2609.22085)提出 SeeQ(Subtask-elicited Q-functions):通用机器人策略虽强但在多阶段、需反复尝试的长程任务上很脆弱,而用稀疏任务级奖励学 Q 函数会带来漫长的信用分配horizon、困难的 Bellman 回传与巨大的数据覆盖要求。SeeQ 改为学习「当前活跃子任务」的 Q 值,从而缩短价值预测视界、让时序差分(TD)学习变得可行;训练时利用离线机器人数据中已有的子任务标注获得分解;测试时不需要人工标注或模块化子任务预测器——Q 函数架构会先自回归地用自然语言预测当前子任务,再估计其价值。基于视觉语言骨干、在多种开源操作数据上预训练、再在下游任务微调。在两个双臂真机平台的四个真实任务上,SeeQ 显著改善了 best-of-N 策略引导(任务级 TD 基线维持在 9/24,SeeQ 升到 17/24),子任务形式化与 best-of-N 回退缺一不可。
SeeQ价值函数Value FunctionQ-function长程操作Long-HorizonBest-of-N子任务分解Temporal Difference通用机器人策略CMU视觉语言模型策略引导
Category: manipulation
Author: @saksham_singh02
Date: 2026-09-29T00:00:00
Duration: 55.7s
Reference: https://saksham002.github.io/seeq/