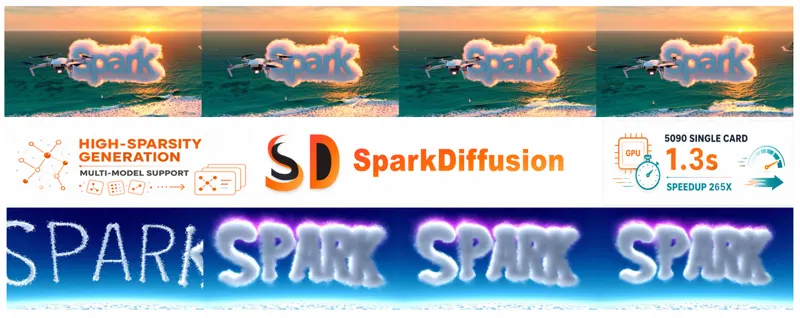
SparkDiffusion:破解高稀疏陷阱,阿里北大清华把视频生成在单卡上加速 265 倍北大、清华与阿里(Melon Group/Alibaba Research)提出 SparkDiffusion(arXiv:2609.23153):先诊断出「高稀疏陷阱」——注意力稀疏到 97% 时逐步训练损失照降而终端生成质量停滞倒退,根因是流匹配类逐步监督无法约束终端误差(Oracle 干预实验证明高噪声 5 步修正即可消除大部分终端误差)。三段配方:短促稀疏预热(补偿式稀疏注意力,RoLA)→ 少步轨迹混合蒸馏(CrossDistill:高噪声 PCM 一致性 + 低噪声 DMD 分布匹配,3 步 CFG-free 学生)→ FP8 W8A8 量化与融合核。720P 长序列维持 97% 稀疏度,Wan2.1-T2V-14B-720P 单张 RTX 5090 端到端加速 265×(H100 220×),1.3B-480P 视频仅 1.3s;多样性最接近稠密参照,VBench 83.15 对稠密 83.69。代码开源。Yuxi Liu, Haoyu Li, Zekun Zhang · 671次阅读 · 2026年9月19日视频生成扩散模型2026年9月19日
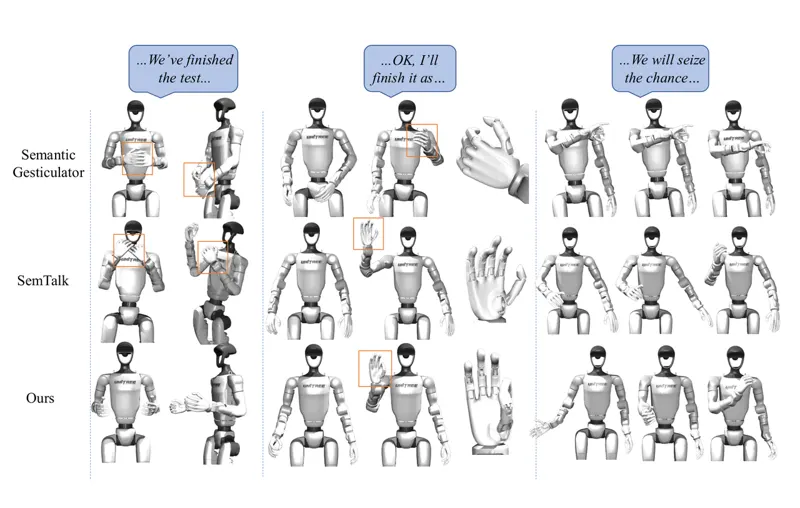
RoboGesture:人形机器人实时语义手势RoboGesture 让人形机器人听懂语音并实时做手势:300 余类手势数据集,分层语义-声学对齐提取韵律与语义线索,流式扩散生成器驱动 Unitree G1,MPC 安全滤波保真机无碰撞执行。Wang, Zifan, Ren, Ziang, Shi, Pengyang · 1332次阅读 · 2026年8月27日模型预测控制仿真到现实2026年8月27日
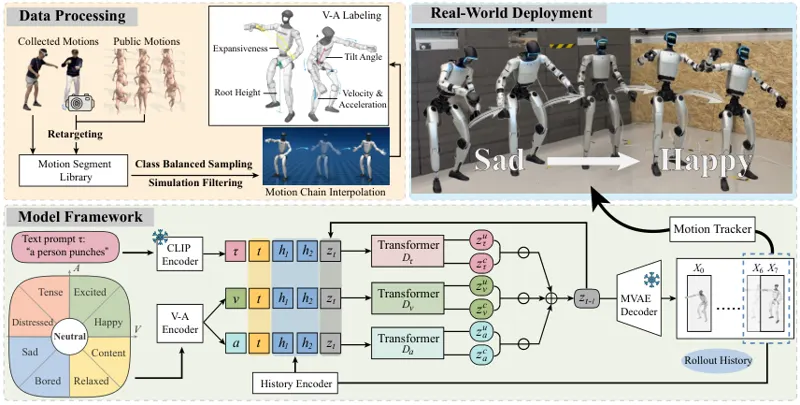
PAMoR:人形机器人实时参数化情感动作生成PAMoR 把情感变成可测量的控制参数:在人形机器人自身运动学上以闭式解计算效价-唤醒度(V-A)坐标,由姿态扩展度与运动能量直接得出,无需人类标注。动作先验与两个情感先验在共享潜空间中逐去噪步复合——动作先验决定做什么,情感先验调节怎么做。全身动作在 29 自由度 Unitree G1 上自回归实时展开,动作与情感均可在线编辑;感知实验中评分者对目标情绪的识别率达 0.38,超过基线并接近真人表演动作的 0.44。Yan Pan, Lingfan Bao, Tianhu Peng · 742次阅读 · 2026年8月28日宇树 G1人形机器人2026年8月28日
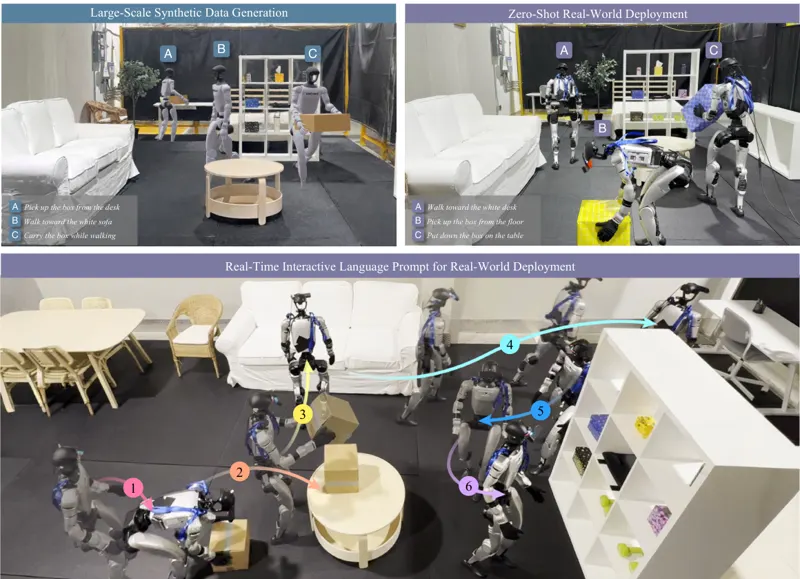
VLK:在重建场景中合成人类交互,学习人形机器人移动操作本文提出视觉-语言-运动学(VLK)框架:在 3D 高斯泼溅重建的真实室内场景中合成导航与物体交互轨迹,并事后渲染第一人称观测,自动生成 4.8 万条视觉-语言-运动学配对数据,训练出预测 Unitree G1 全身运动轨迹的策略,经接触感知全身跟踪器执行,实现 sim-to-real 的感知驱动人形移动操作。Yen-Jen Wang, Jiaman Li, Sirui Chen · 671次阅读 · 2026年6月29日人形机器人Loco-manipulation2026年6月29日
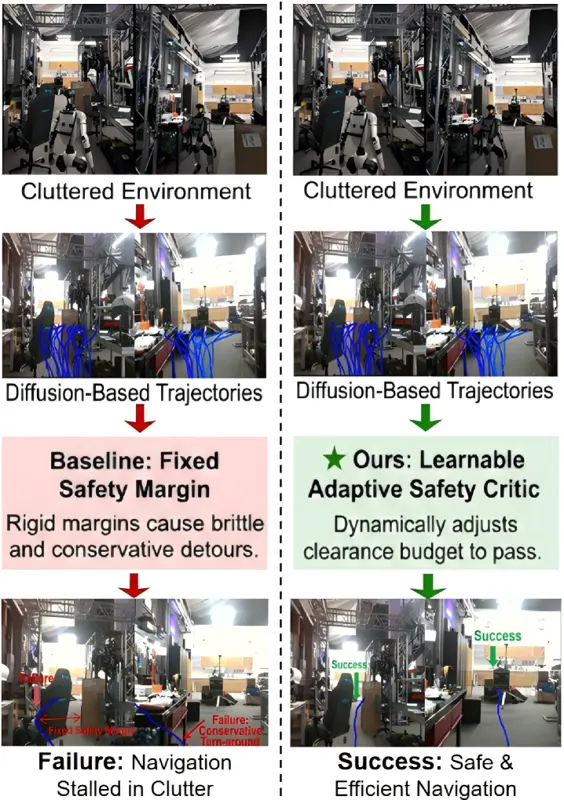
视觉导航的自适应安全裕度学习杂乱室内空间中的机器人往往不是因为无法生成无碰撞路径而失败,而是因为固定安全裕度校准不当。本文提出基于扩散规划的自适应安全裕度学习方法。Junyi Hu, Shuaihang Yuan, Geeta Chandra Raju Bethala · 391次阅读 · 2026年7月20日视觉导航安全边际2026年7月20日
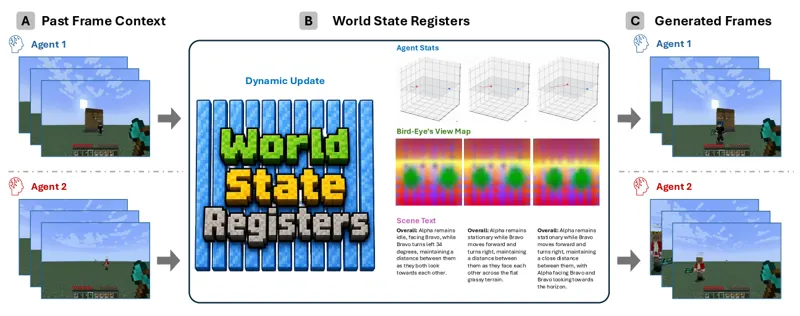
流式多智能体自回归扩散模型:带世界状态寄存器多智能体交互世界模型不仅需要生成一致的观测,还需维护跨智能体持久、跨视角演化的世界状态。现有自回归视频扩散管线将观测历史作为条件上下文,导致共享状态信息分散且低效。本文提出流式多智能体自回归扩散模型,引入世界状态寄存器机制。Sicheng Mo, Yuheng Li, Ziyang Leng · 368次阅读 · 2026年7月23日世界模型多智能体2026年7月23日
 0:10