Skip to content
← 标签

#Habitat (6)

SimpleVLN:不改架构释放原生多模态大模型的视觉语言导航能力

SimpleVLN:不改架构释放原生多模态大模型的视觉语言导航能力

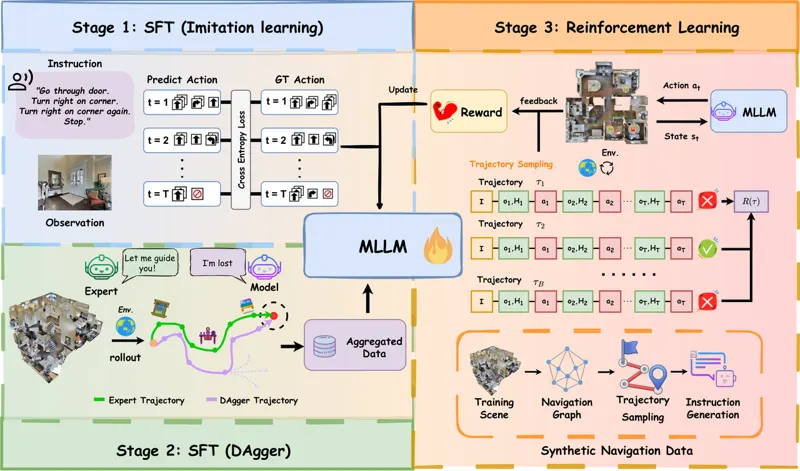
视觉语言导航(VLN)要求具身智能体把自然语言指令落到第一视角观测上并完成长程决策。现有方法大多靠任务专用结构补能力——全景拼接、3D 几何编码器、双系统分层决策——因此很难判断成绩里有多少来自 MLLM 本身。SimpleVLN 把问题反过来问:在引入任何任务专用模块之前,原生 MLLM 的导航潜力是否已经被榨干? 它的回答分三层。表述层:每次决策都重新构造一轮独立输入,即指令 + 当前观测 + 固定预算的全局-局部历史(默认全局 8 帧均匀采样、局部 1 帧),不再累积成越来越长的多轮对话;输出侧用动作块,一次推理给出多个基元动作(前进 0.25 m、左右转 15 度、停止)依次执行。数据层:R2R、RxR、ScaleVLN 的专家演示转成决策级监督样本,基于偏离度的 DAgger 在策略自己走到的状态上收集纠偏轨迹,RL 任务则在训练场景里自动合成新的起点-终点与指令。优化层:IL 到 DAgger 再到 RL 三段递进,RL 只用二值成功奖励(停在目标 3 m 内记 1 分),主结果用 DAPO 训 40 步。 只用单目 RGB、不改一行网络结构,Qwen3.5-9B 版在 R2R-CE 与 RxR-CE 的 val-unseen 上分别拿到 76.7% 与 80.1% 成功率,超过依赖全景、深度或里程计的现有方法;单次动作块决策耗时 293 ms。消融显示单轮输入把成功率从 35.7% 抬到 53.6%,DAgger 再贡献 7.5 与 8.1 个点。评测代码与八个权重已开源,并在 Daystar 四足机器人(Jetson Thor 机载)上完成真实环境验证。

Lingyi Hong, Weiren Cai, Jiayu Chen · 170次阅读 · 2026年10月16日
视觉语言导航具身智能
2026年10月16日
BSC-Nav:从反应式到认知式,为具身智能体装上类脑的三维空间记忆

BSC-Nav:从反应式到认知式,为具身智能体装上类脑的三维空间记忆

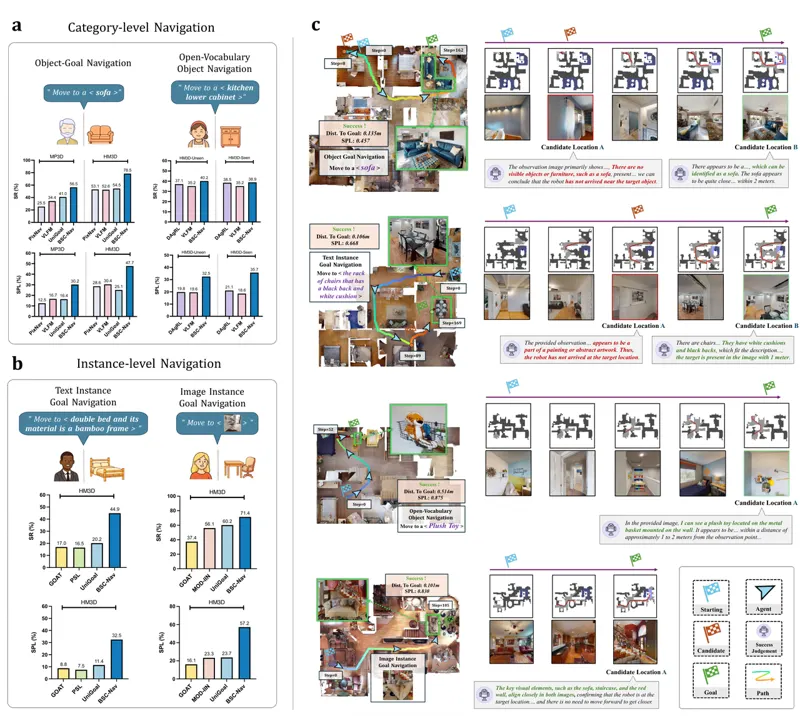
清华大学(计算机系、心理与认知科学系)与北京航空航天大学提出 BSC-Nav(Brain-inspired Spatial Cognition for Navigation)。论文指出,现有具身智能体无论走端到端强化学习还是「MLLM + 模块化流水线」,本质上都是反应式、无状态的——处理完观测就丢弃,缺乏持久的空间内部模型,导致知识碎片化、规划短视、泛化差。作者从神经科学借来答案:生物把空间知识巩固为地标、路线知识、概览知识三种互相连接的形式。BSC-Nav 用三个模块在计算上实例化了这套结构——地标记忆以四元组(世界坐标、开放词汇类别、检测置信度、GPT-4o 生成的上下文描述)编码显著线索与位置的持久关联,并用「空间重叠集 + 置信度加权融合」去重;认知地图用 DINO-v2 提取 patch 特征,经逆透视投影与级联坐标变换投射到体素网格,并采用受自由能原理启发的 surprise 驱动更新——按新特征与邻域内既有特征的平均距离决定是否写入,缓冲区满则替换 surprise 最低者,从而既保留跨视点多样性又控制存储;工作记忆按指令复杂度分层检索,简单目标用纯文本 GPT-4 推理地标记忆(甚至能由共现地标推断未记录目标的位置),复杂目标先由 GPT-4o 精炼描述、再用 Stable Diffusion 3.5 「想象」目标外观,经 DINO-v2 编码与中心距离加权池化后查询认知地图(imagine-then-localize),最后用相似度加权 DBSCAN 聚类得到候选坐标。多候选时不贪心选最高置信度,而是用 H_i = λ·p_i + (1-λ)(1-d_i/d_max) 复合打分排序探索序列。实验覆盖 MP3D/HM3D 共 62 个场景、8,195 个 episode:OGN 在 HM3D 达 78.5% SR(超 SOTA 的 UniGoal 24.0 个百分点),OVON 以零样本超越有监督的 DAgRL,IIN 达 71.4%;SPL 提升比 SR 更一致(IIN 达 57.2% vs 23.7%)。主动具身问答 A-EQA 上 LLM-Match 54.6 为最高,但仍落后人类 27.5。真机用 AgileX Ranger-mini-3.0 底盘 + Franka Research 3 机械臂 + RealSense D435i 平台,在约 200 m² 两层空间跑 75 个 episode,IIN 有 4/5 目标达 100% SR,失败时也稳定定位到语义合理区域;并展示了导航与操作原语协同的长程任务(如「做早餐」依次操作三个开放词汇物体)。论文提出「空间认知的具身图灵测试」应考察三个维度:实时构建可复用空间表征、从稀疏部分观测中抽象推理、把高层目标转译为可执行空间计划。

Ruan, Shouwei, Wang, Liyuan, Kang, Caixin · 963次阅读 · 2025年8月24日
BSC-Nav视觉语言导航
2025年8月24日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。