1990–2026 · 五条技术脉络 · 33 个里程碑
61 篇站内收录论文 · 四条谱系 · 分类依据 arXiv:2605.12090
Physical Intelligence的π0是VLA模型,摄像头输入和自然语言指令直接输出运动控制,解决60年机器人专一化难题。
Generalist AI发布GEN-1具身基础模型,简单操作成功率99%,速度提升3倍,每任务仅需1小时数据。
将第一人称人类操作视频通过动作重定向、机械臂视觉合成、多级质量筛选转化为机器人训练数据,产出 18,561 小时跨 15 种机器人形态的数据,提升 VLA 模型 OOD 泛化,并在真机验证。
Ye Wang, Pei Lin, Xiong-Hui Chen
阿里达摩院发布RynnBrain 1.1及RynnBrain-VLA,在Unitree G1等平台实现长时序烹饪任务。
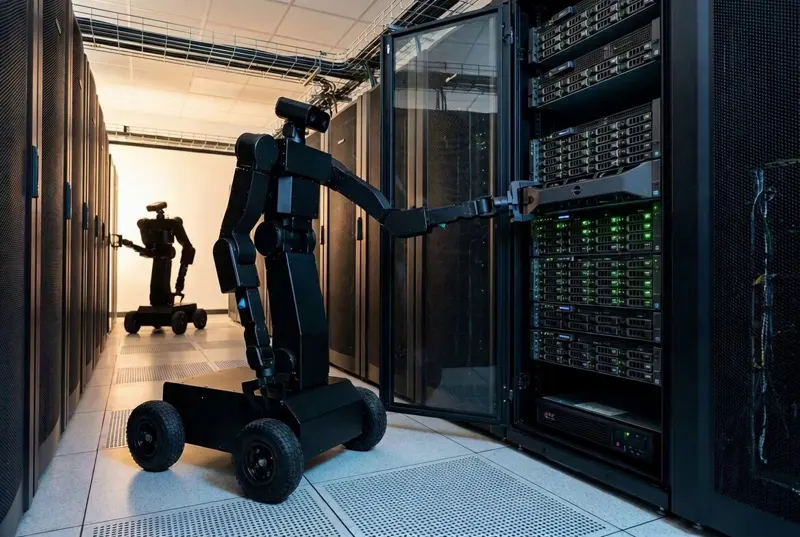
Wayve发布GAIA-4世界模型,十年研究后实现生产级机器人仿真,2018年构建首个世界模型。
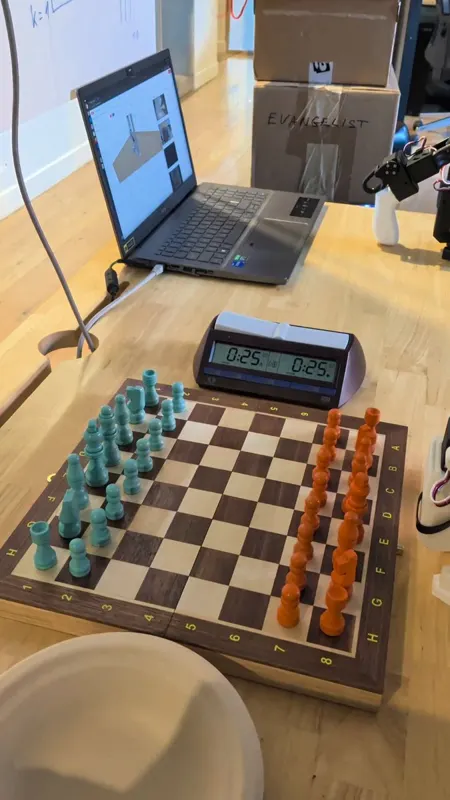
用微调π0.5控制棋子拾放,逆运动学+Stockfish计算走法,CNN检测对手每格落子
图灵奖得主指出纯奖励驱动的强化学习必须不断试错真实世界,缺乏世界模型导致样本效率存在下限
提出物理语言——世界状态转移的紧凑离散表示。PhiZero 采用先推理后渲染范式:先从真实视频自监督学习物理语言,推理出未来世界演化的语言序列,再渲染为视频;在生成与理解基准上验证了物理一致性,并展示交互式建模、细粒度动作条件仿真与零样本运动迁移的潜力。
Shuyao Shang, Yuqi Wang, Ruopeng Gao
接触前需保留多模态轨迹、接触后需快速响应力反馈——FA-RDP 用共享多频率视觉-力 Transformer 同时预测高低频动作块,并学习多模态指示器在接触前多步低频采样、歧义降低后切换单步高频采样;配合流形一致性蒸馏,在三个接触密集任务上取得最高成功率。
Lifeng Zhuo, Wendi Chen, Han Xue
提出GQRM强化学习后训练框架,通过自举探索与群组Q值归一化机制对导航扩散策略进行跨本体微调,仿真成功率从61%提升至84%,真实世界从10%提升至65%。
Tianyu Yang, Yiming Zeng, Wenzhe Cai
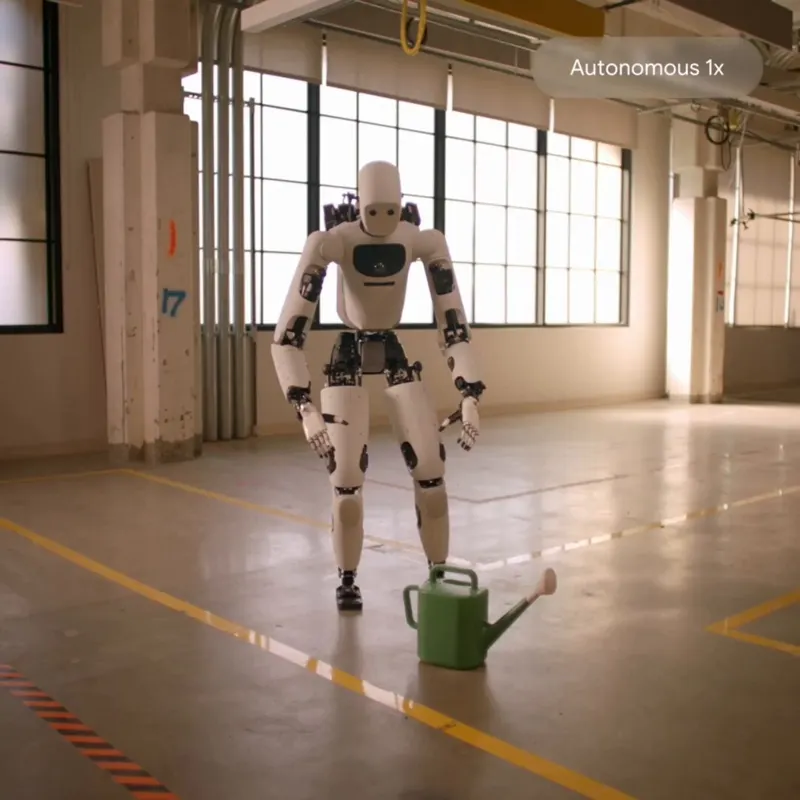
Gemini Robotics 2将物理AI超越桌面任务,实现人形机器人智能全身控制。Apptronik Apollo 2处理单条指令即可完成弯腰、取浇水壶等动作。
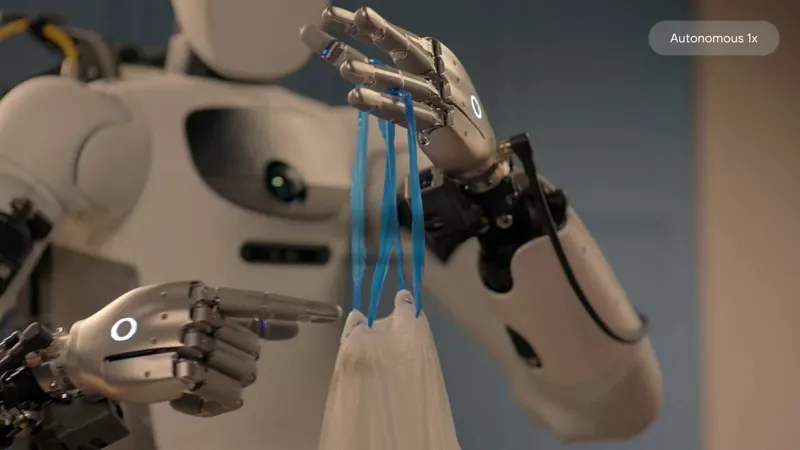
Gemini Robotics 2是单一VLA模型,一个检查点即可适配不同末端执行器(灵巧手或夹爪)。Apptronik Apollo 2人形搭配22自由度SharpaWave手可打结、密封密封袋。