PAPER DEEP DIVE
BeyondRetarget:从单目视频直接学习可执行人形运动
南京大学团队提出 BeyondRetarget,绕过 SMPL 人体中间表征,端到端将单目 RGB 视频直接映射为人形机器人可执行全身运动:18 个语义关键点 + 逐链接非均匀缩放构建统一监督,共享运动表征可解码至 8 种人形本体,配合接触感知修正,G1 上关键点误差压至 26.4mm、零崩塌,延迟 193ms 支持实时视觉遥操作。
一句话总结
BeyondRetarget 把「视频 → 人运动重建(SMPL)→ 重定向到机器人」这条两阶段流水线整个砍掉,直接从单目 RGB 视频端到端地生成可执行的人形机器人全身关节轨迹:用 18 个语义关键点 + 有向语义链接把 SMPL 人类数据"按机器人比例缩放"成统一监督信号,让一个共享隐式运动表征可以解码到 8 种人形机器人,再配上接触感知的运动学修正,在 G1 上把关键点误差从两阶段方法的 39–46 mm 压到 26.4 mm,真机执行更稳、延迟从约 1.3 s 降到 193 ms。
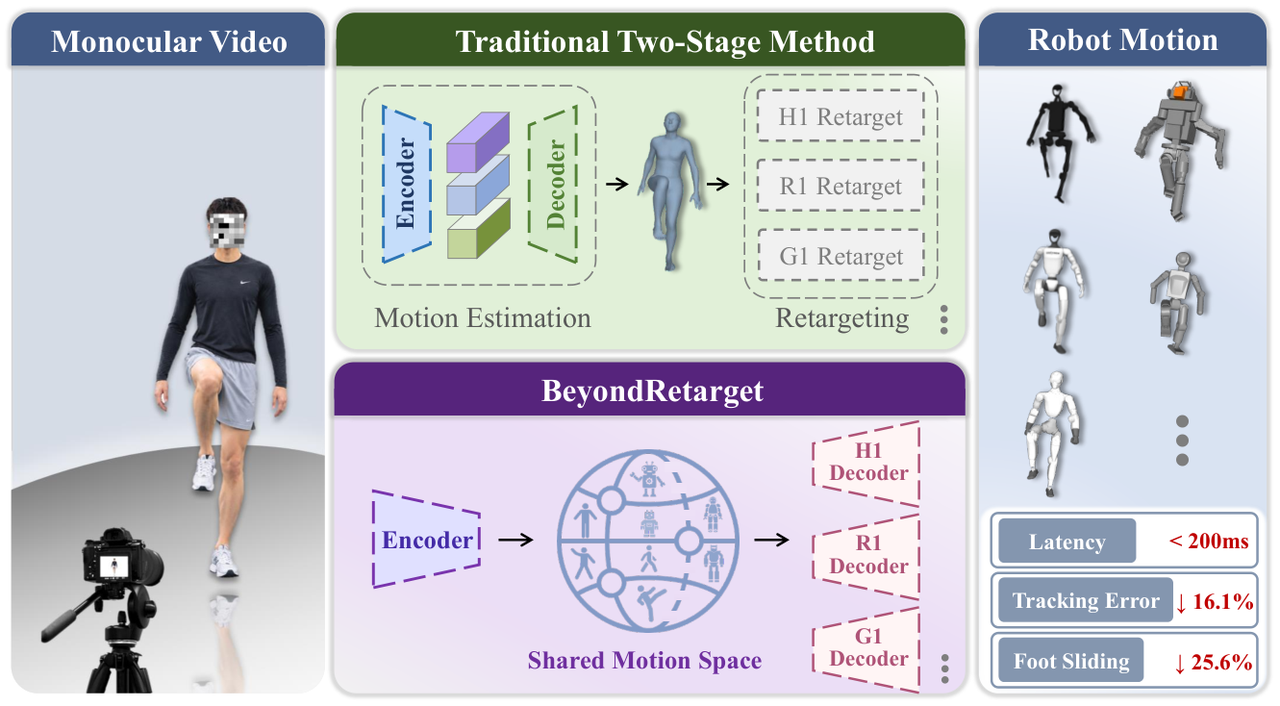
图 1:BeyondRetarget 把视频编码进共享运动空间,直接解码出目标机器人的专属轨迹——不再经过显式的人体中间表征。
研究背景:两阶段流水线的结构性缺陷
可执行的全身运动数据是人形机器人技能学习和全身控制的基石。传统获取方式依赖光学动捕(Vicon)或可穿戴惯性传感器,设备昂贵、场地受限,难以规模化。相比之下,单目 RGB 视频几乎无穷无尽、采集成本近乎为零——如果能直接"看视频学动作",就为人形机器人打开了一条大规模低成本的数据通道。
现有工作几乎都走同一条两阶段路线:先用人类运动重建方法(WHAM、GVHMR 等)把视频转成 SMPL 参数化的显式人体运动,再用重定向方法(GMR、NMR 等)把人体运动映射到机器人关节空间。这条路线有效,但有三个绕不开的问题:
其一,中间表征是"以人为本"的。SMPL 描述的是人体,而人形机器人与人在身体比例、关节自由度配置、运动动力学上差异显著:机器人可能没有灵活的脊柱、脚趾,踝关节自由度也不同。用人体中心的空间去描述机器人运动,天生就别扭,重定向阶段不得不"硬掰"。
其二,误差单向累积。第一阶段人体运动估计的误差会原封不动传给第二阶段,与重定向误差叠加;即使做联合优化,也无法消除已经固化的上游误差。论文的 Oracle 实验直接证明了这一点:即使喂给重定向模块完美的 SMPL 真值,重定向本身仍引入了不可忽略的误差。
其三,机器人特异性绑定。学习式的重定向方法(如 NMR)通常绑定特定机器人,换一个形态就要重新收集机器人数据训练。
BeyondRetarget 的回答干脆利落:既然中间环节是问题之源,就整个去掉——不再重建"人怎么动",直接预测"机器人怎么动"。
方法
问题形式化
给定长度为 \(n\) 的单目 RGB 视频序列 \(\mathcal{I}=\{\mathbf{i}_t\}_{t=1}^{n}\) 和目标机器人配置 \(r\),直接估计目标机器人的完整运动:
$$\hat{\mathcal{M}}^{(r)}=\{\hat{\mathbf{p}}_{t},\ \hat{\mathbf{o}}^{(r)}_{t},\ \hat{\mathbf{q}}^{(r)}_{t}\}_{t=1}^{n}$$
其中 \(\hat{\mathbf{p}}_t\in\mathbb{R}^3\) 是根节点平移,\(\hat{\mathbf{o}}^{(r)}_t\in\mathbb{R}^6\) 是根节点朝向(用六维旋转表示),\(\hat{\mathbf{q}}^{(r)}_t\in\mathbb{R}^{d_r}\) 是该机器人 \(d_r\) 维的全身关节向量。注意输出空间的维度 \(d_r\) 因机器人而异——这正是"面向机器人"的含义:表征本身就是为特定机器人的关节空间服务的。
模型架构:共享表征 + 机器人专属解码器
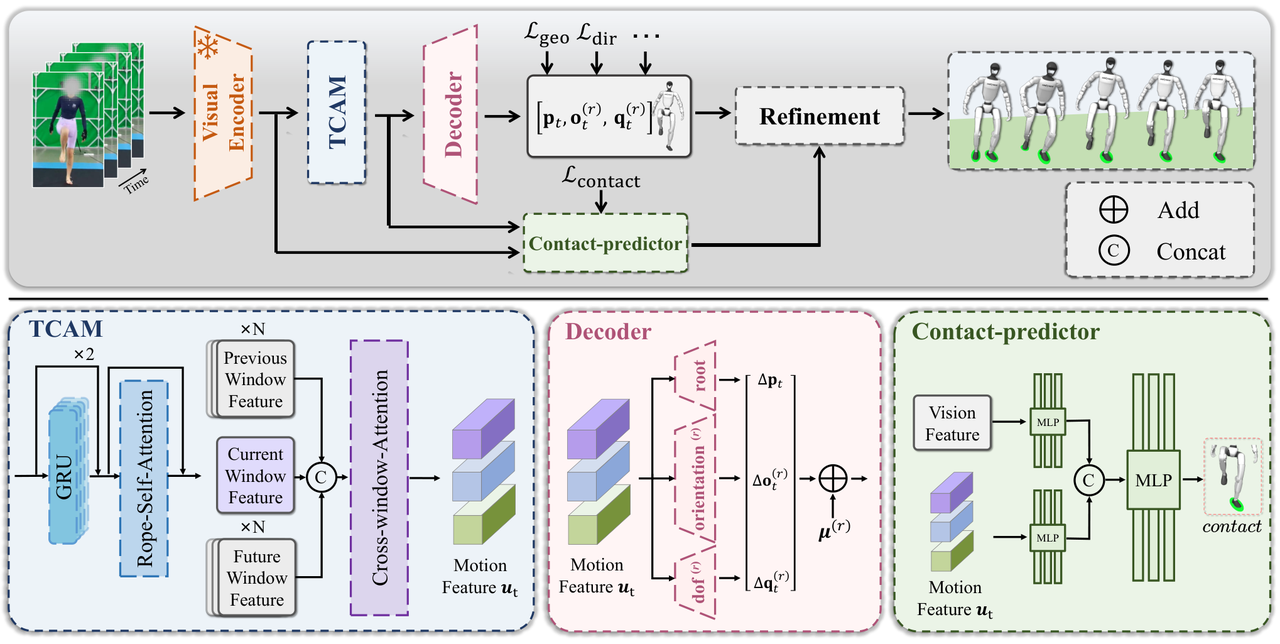
图 2:模型架构。冻结的视觉编码器 + 时序聚合模块(TCAM)产生共享运动表征,机器人专属解码器直接输出关节轨迹,接触感知修正模块再做后处理。
架构分三块:
(1)视觉与时序编码。用一个冻结的视觉编码器(4DHumans 系)把每帧编码为视觉特征,再由时序上下文聚合模块(TCAM)跨帧建模,输出共享运动表征 \(\mathbf{u}_t\)。这个表征是"人-机器人共享"的中间桥梁:它不描述任何一方,却蕴含跨形态的运动结构。
(2)机器人运动解码器。对目标机器人 \(r\),解码器 \(\Psi_r\) 把 \(\mathbf{u}_t\) 直接映射为机器人运动。关键设计是把运动参数化为围绕机器人名义状态的残差:
$$[\hat{\mathbf{p}}_{t},\ \hat{\mathbf{o}}^{(r)}_{t},\ \hat{\mathbf{q}}^{(r)}_{t}]=\bm{\mu}^{(r)}+[\Delta\mathbf{p}_{t},\ \Delta\mathbf{o}^{(r)}_{t},\ \Delta\mathbf{q}^{(r)}_{t}]$$
其中 \([\Delta\mathbf{p}_t,\Delta\mathbf{o}^{(r)}_t,\Delta\mathbf{q}^{(r)}_t]=\Psi_r(\mathbf{u}_t)\) 是网络预测的残差,\(\bm{\mu}^{(r)}\in\mathbb{R}^{3+6+d_r}\) 是可学习的机器人名义状态。残差参数化让网络只需学"偏离静止姿态多少",天然适配不同自由度数量和默认站姿差异巨大的机器人。
解码器由一个 MLP 主干和三个分支构成:根平移分支、根朝向分支、机器人专属 DoF 分支。扩展新机器人时,预训练的视觉时序表征、MLP 主干和根平移分支全部复用,只需为该机器人重训 DoF 分支和根朝向分支——在单张 RTX 4090 上约一小时即可适配一个新人形(论文适配了 Unitree G1/R1/H1、Fourier GR1-T1/GR2-V3、Booster T1、天工、Atlas 共 8 种)。
统一运动监督:非均匀形态缩放
最棘手的问题:训练数据里没有人形机器人的真值轨迹,只有 SMPL 人类标注。两者关节维度和运动学含义完全不同,怎么直接监督?论文的方案是非均匀形态缩放(non-uniform morphology alignment),把人类关键点"捏"成机器人的比例。
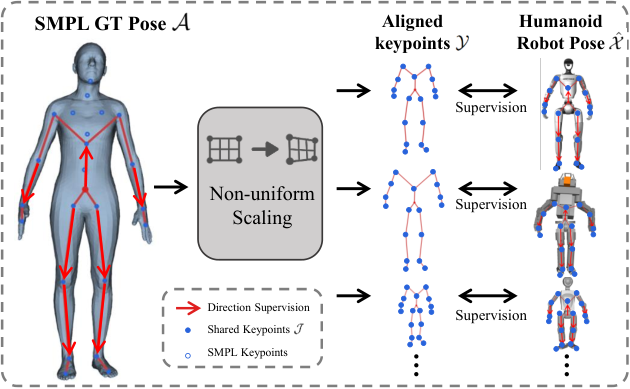
图 3:统一的人机监督机制。人类关键点被逐链接比例缩放成机器人形态,关键点位置与有向肢体段共同监督机器人姿态。
具体地,定义覆盖骨盆、躯干、肩、肘、腕、手、髋、膝、踝、脚的 18 个共享语义关键点集合 \(\mathcal{J}\)。人侧关键点 \(\mathbf{a}_{t,j}\) 从 SMPL 关节提取;机器人侧对应关节为 \(\hat{\mathbf{x}}_{t,j}\)。以骨盆为根,按每条链接独立缩放,构造机器人比例的监督目标:
$$\mathbf{y}_{t,0}=\mathbf{a}_{t,0},\qquad \mathbf{y}_{t,j}=\mathbf{y}_{t,\pi(j)}+\frac{\ell^{(\mathrm{r})}_{j}}{\ell^{(\mathrm{h})}_{j}}\left(\mathbf{a}_{t,j}-\mathbf{a}_{t,\pi(j)}\right)$$
其中 \(\pi(j)\) 是关键点 \(j\) 的父节点,\(\ell^{(\mathrm{h})}_j\)、\(\ell^{(\mathrm{r})}_j\) 分别是人和机器人该链接的长度。注意缩放是逐链接非均匀的:机器人腿长臂短,就各自按各自的比例拉——而不是整体统一缩放。消融实验显示这一项贡献最大:去掉它 MAMPJPE 从 26.36 恶化到 36.08 mm。
监督信号分两层。其一是关键点几何损失:把预测的机器人关键点经 Procrustes 对齐到缩放后的人类关键点,逐点施 Smooth L1 惩罚:
$$\mathcal{L}_{\mathrm{geo}}=\frac{1}{n|\mathcal{J}|}\sum_{t=1}^{n}\sum_{j\in\mathcal{J}}\rho\left(\tilde{\mathbf{x}}_{t,j}-\mathbf{y}_{t,j}\right)$$
其二是有向链接方向损失。关键点位置不足以约束肢体的局部朝向,因此再定义上臂、前臂、大腿、小腿、躯干的有向语义链接集合 \(\mathcal{D}\),惩罚预测链接向量与目标链接向量的余弦差异:
$$\mathcal{L}_{\mathrm{dir}}=\frac{1}{n|\mathcal{D}|}\sum_{t=1}^{n}\sum_{d\in\mathcal{D}}\left(1-\hat{\mathbf{v}}^{\top}_{t,d}\mathbf{v}_{t,d}\right)$$
完整训练目标再叠加根平移/朝向损失、跨帧时序一致性损失 \(\mathcal{L}_{\mathrm{temp}}\) 与机器人关节限位惩罚 \(\mathcal{L}_{\mathrm{lim}}\):
$$\mathcal{L}_{\mathrm{motion}}=\lambda_{\mathrm{geo}}\mathcal{L}_{\mathrm{geo}}+\lambda_{\mathrm{dir}}\mathcal{L}_{\mathrm{dir}}+\lambda_{\mathrm{trans}}\mathcal{L}_{\mathrm{trans}}+\lambda_{\mathrm{ori}}\mathcal{L}_{\mathrm{ori}}+\lambda_{\mathrm{temp}}\mathcal{L}_{\mathrm{temp}}+\lambda_{\mathrm{lim}}\mathcal{L}_{\mathrm{lim}}$$
整套机制的含义是:人类标注不经过任何中间转换就被直接用作机器人运动的监督——监督发生在统一的几何空间,而非各自的参数空间。
接触感知的运动修正
视觉推断出的姿态即使准确,也未必物理可执行——机器人运动的可执行性高度依赖时序一致性和接触稳定性。论文设计了两级状态决策的修正模块:
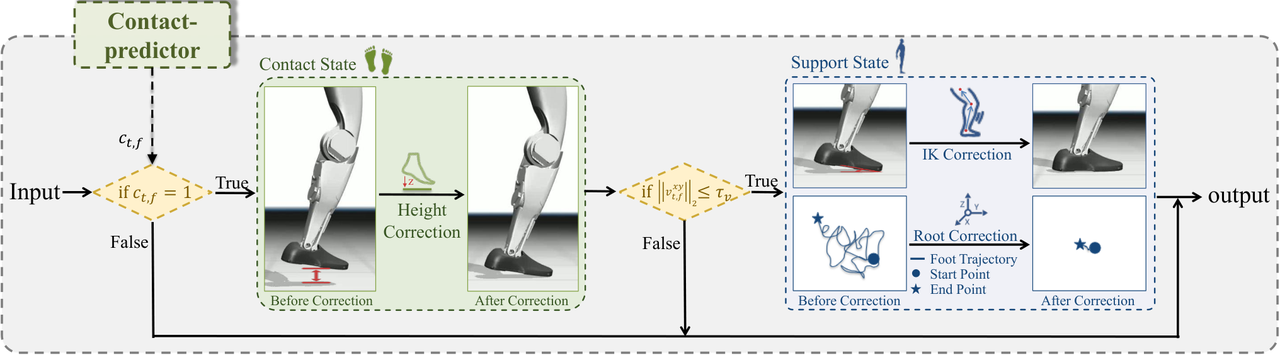
图 4:接触感知运动学修正。下肢按"接触/支撑"两级状态划分,分别触发不同强度的后处理修正。
首先,冻结运动估计器,训练一个接触预测器(以压力数据监督,源自 MotionPRO),融合运动特征与视觉特征预测每只脚的接触概率 \(\hat{c}_{t,f}\in[0,1]\)。然后做两级判定:概率二值化为接触状态 \(c_{t,f}\in\{0,1\}\);再经前向运动学求出脚部轨迹的水平速度 \(v^{xy}_{t,f}\),只有接触且几乎不动的脚才算支撑:
$$s_{t,f}=c_{t,f}\wedge\left(\left\|v^{xy}_{t,f}\right\|_{2}\leq\tau_{v}\right)$$
这个区分很讲究:脚踩在地上但还在蹭,与脚稳稳踩住提供支撑,是两种物理状态。接触状态触发根高度修正(消除脚陷入地面或悬空的高度偏差);支撑状态进一步触发根水平修正 + 下肢逆运动学求解,保证支撑脚零滑动。为避免状态切换引起的突变,IK 修正残差经时序平滑滤波后再叠加回原始预测:
$$\Delta\mathbf{q}^{\mathrm{IK}}_{t}=\mathbf{q}^{\mathrm{IK}}_{t}-\hat{\mathbf{q}}_{t},\qquad \hat{\mathbf{q}}_{t}\leftarrow\hat{\mathbf{q}}_{t}+\operatorname{Filt}\left(\Delta\mathbf{q}^{\mathrm{IK}}_{t}\right)$$
消融显示,去掉这个修正模块,违反率(脚悬空/陷入地面的比例)从 6.17% 恶化到 22.18%,脚滑从 1.71 恶化到 4.51 mm/frame——运动看起来还行,但物理上站不稳。
实验结果
与两阶段方法对比(Unitree G1)
| 方法 | MAMPJPE ↓ | RTE ↓ | Jitter ↓ | Fail65 ↓ | FS ↓ | Exec. SR ↑ | Exec. MAMPJPE ↓ |
|---|---|---|---|---|---|---|---|
| GT→NMR(Oracle) | 33.26 | 837.62 | 1.71 | 3.99 | 1.30 | 346/362 | 40.32 |
| GT→GMR(Oracle) | 32.02 | 36.01 | 10.65 | 0.00 | 0.82 | 347/362 | 35.93 |
| GVHMR→NMR | 39.19 | 701.13 | 1.63 | 6.21 | 2.28 | 340/362 | 43.32 |
| GVHMR→GMR | 39.46 | 637.33 | 7.94 | 3.43 | 3.30 | 313/362 | 41.77 |
| WHAM→NMR | 43.15 | 849.36 | 4.87 | 9.36 | 6.64 | 342/362 | 46.56 |
| WHAM→GMR | 45.88 | 217.76 | 63.26 | 10.47 | 13.30 | 295/362 | 42.89 |
| BeyondRetarget | 26.36 | 80.74 | 1.41 | 0.00 | 1.71 | 347/362 | 35.04 |
几个关键读数:
端到端全面领先。MAMPJPE(形态对齐关键点误差)26.36 mm,比最好的两阶段组合(39.19)低约 33%;根轨迹误差 RTE 从数百毫米级降到 80.74 mm。最亮眼的是鲁棒性:所有两阶段方法都存在严重姿态崩塌(MAMPJPE 超过 65/100 mm 的窗口),而 BeyondRetarget 的 Fail65 和 Fail100 均为 0——没有出现过一次崩塌。
重定向本身就有误差。Oracle 行用完美 SMPL 真值喂给重定向模块,GVHMR→NMR 等实测输入的方法仍然全面落后;而且 BeyondRetarget 连 GT→NMR 都比不过自己——说明即使上游完美,两阶段的天花板也被重定向环节压低了。
物理仿真执行。用通用运动跟踪器 SONIC 在 MuJoCo 里执行生成的动作,BeyondRetarget 成功率 347/362(95.86%),执行后误差 35.04 mm,均为最优。
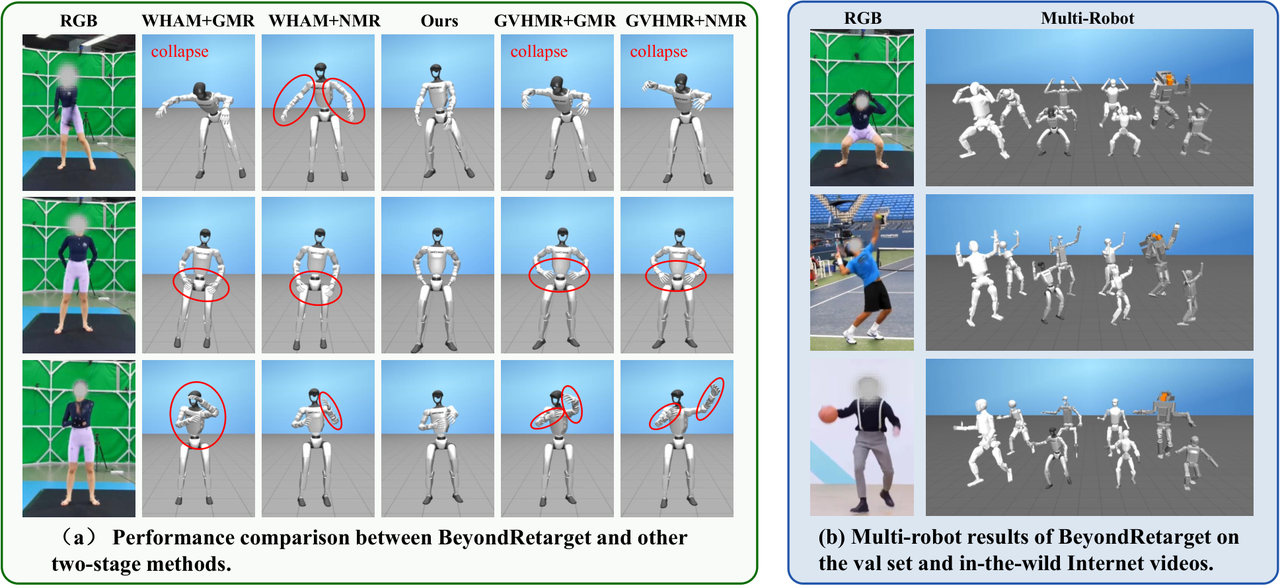
定性上(图 5),大幅度的手臂挥摆动作两阶段方法经常出现肢体错位甚至姿态崩塌;精细动作如"双手背后",所有两阶段方法都把手放到了身体前面——中间表征的模糊性在这一刻暴露无遗,而 BeyondRetarget 正确还原了背后动作。
多机器人适配
| 方法 | H1 | T1 | 天工 | G1 | R1 | GR1-T1 | GR2-V3 | Atlas |
|---|---|---|---|---|---|---|---|---|
| GVHMR→GMR | 77.79 | 70.09 | 103.23 | 39.46 | – | – | – | – |
| WHAM→GMR | 99.66 | 77.26 | 115.86 | 45.88 | – | – | – | – |
| BeyondRetarget | 51.32 | 51.25 | 67.99 | 26.36 | 27.81 | 43.78 | 49.06 | 72.05 |
8 种形态各异的人形机器人,同一套共享表征,误差全部落在 26.36–72.05 mm 的合理区间,且在两种方法都支持的 4 台机器人上全部优于 GVHMR→GMR。定性结果还显示该方法可以泛化到互联网上的野外视频——统一的监督机制真正把共享视觉运动表征迁移到了不同机器人本体上。
实时性能与真机
| 方法 | 延迟 (ms) | 吞吐 (FPS) | 显存 (GiB) |
|---|---|---|---|
| GVHMR→GMR | 1369.4 | 44.31 | 9.18 |
| GVHMR→NMR | 1305.7 | 44.36 | 9.73 |
| BeyondRetarget | 192.8 | 50.02 | 7.03 |
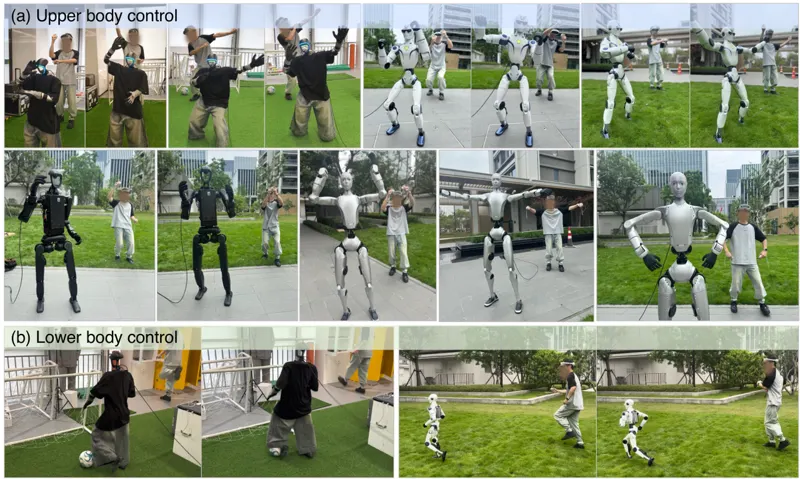
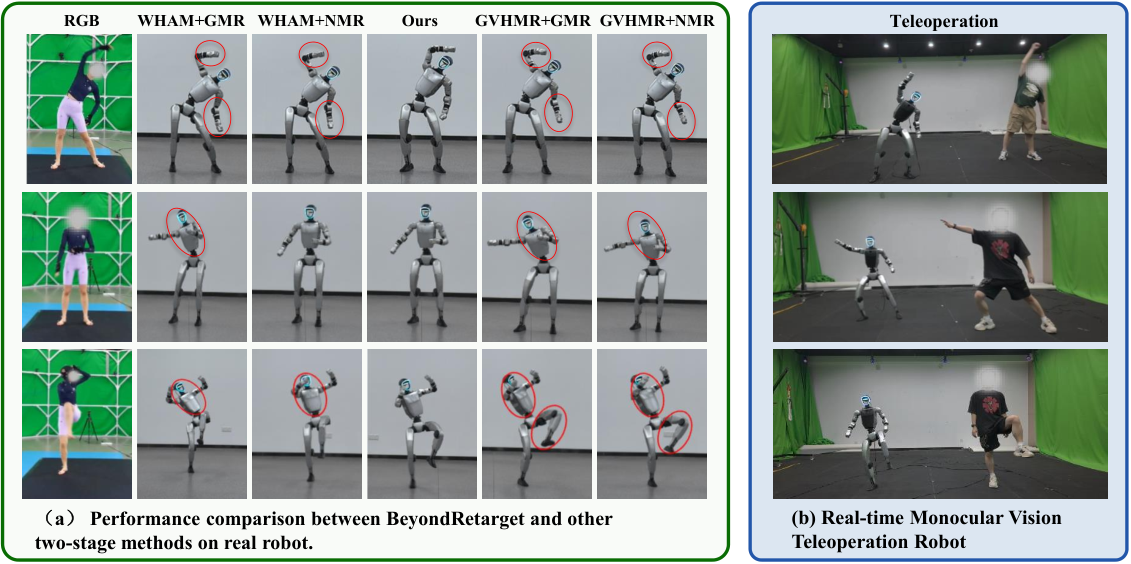
端到端架构加精简模型,延迟比两阶段低约 7 倍(192.8 ms vs ~1.3 s),吞吐更高、显存更省——这直接使实时视觉遥操作成为可能:人在镜头前做动作,机器人实时跟随(图 6b)。真机实验中,伸展动作 BeyondRetarget 能把左臂举过头顶同时保持手贴近大腿,四种两阶段基线都出现明显的手臂轨迹偏差;单臂画圈和双手抱头动作中,BeyondRetarget 全程保持稳定支撑,两阶段基线全部出现明显不稳。
消融实验
| 变体 | MAMPJPE ↓ | RTE ↓ | TDE ↓ | EDE ↓ | FS ↓ | Viol. ↓ |
|---|---|---|---|---|---|---|
| w/o 非均匀对齐 | 36.08 | 89.84 | 5.17 | 15.77 | 1.89 | 4.39 |
| w/o \(\mathcal{L}_{\mathrm{dir}}\) | 29.62 | 94.77 | 6.95 | 21.78 | 2.08 | 7.00 |
| w/o \(\mathcal{L}_{\mathrm{temp}}\) | 26.44 | 77.12 | 2.95 | 15.41 | 1.99 | 5.66 |
| w/o 接触修正 | 25.73 | 91.33 | 2.95 | 14.31 | 4.51 | 22.18 |
| 完整模型 | 26.36 | 80.74 | 2.95 | 15.29 | 1.71 | 6.17 |
四个组件各司其职:非均匀形态对齐是姿态精度最大的功臣(去掉后误差 +9.7 mm);方向损失撑起肢体局部朝向(EDE 从 15.29 恶化到 21.78);时序损失压住抖动与脚滑;接触修正是物理合理性的唯一保障(去掉后违反率翻近 4 倍)——值得注意的是它甚至让 MAMPJPE 略升(25.73→26.36),因为修正牺牲了少量几何精度换取执行稳定性,这正是"可执行"优先的设计取舍。
意义与局限
共享运动表征 u_t"] C --> D["机器人解码器 Ψ_r
MLP 主干 + 根平移/朝向/DoF 分支
(名义状态 + 残差)"] D --> E["接触预测器
接触状态 c_t,f"] E --> F["两级判定
接触 + 低速 → 支撑 s_t,f"] F --> G["根高/根水平修正
+ 下肢 IK + 平滑滤波"] G --> H["可执行机器人运动
仿真 Exec.SR 95.9% / 真机稳定执行"] D --> I["8 种人形适配
G1/R1/H1/GR1-T1/GR2-V3/T1/天工/Atlas
新机器人 ~1h@RTX4090"]
这项工作对行业的意义在于数据杠杆:互联网上取之不尽的人类视频,经由一个端到端模型就能变成 8 种人形机器人的可执行运动数据,且新机器人适配成本降到"单卡 1 小时"。这为人形机器人的模仿学习和全身控制提供了一条真正可规模化的数据通道。
作者也坦承局限:模型容量与训练数据分布所限,大范围人体运动或相机明显移动时全局轨迹估计仍有误差;当前方法未覆盖复杂地形和接触丰富的人-环境交互。未来方向是引入更多样的数据、建模场景几何与物理接触,让机器人直接从视频学习更复杂、场景条件化的运动技能。