PAPER DEEP DIVE
WholeBodyWAM:以全身控制器接地协调,把预训练世界-动作先验泛化到人形移动操作
WholeBodyWAM 保留 14B 预训练视频世界-动作模型的世界-动作先验,只通过统一全身控制器(UWBC)56 维命令接口接地异构 WBC 语义,再用协调感知自注意力(CASA)让操作流按任务方向与可操作度门控去驱动全身控制流,并以结构化动作因子化(SAF)把两条流分开寻址。1.5 万条 SIMPLE 演示 + LoRA(r=4)微调 5 万步后,仿真整体任务成功率 91.9%;跨 SONIC/AMO/GEAR 三个 WBC 均值 89.2%、方差 10.5 pp²(Cosmos-3 为 80.2%/35.0),真机分布内 81.3% 对最强基线 57.5%、分布外任务进度提升 0.23。
论文元信息
| 项目 | 内容 |
|---|---|
| 标题 | WholeBodyWAM: Generalizing Pre-trained World-Action Priors to Humanoid Loco-Manipulation via WBC-Grounded Coordination |
| 作者 | Zhuo Li, Yiming Yao, Jim Tan, Mengjie Jing, Zhipeng Dong, Fei Chen |
| 机构 | 香港中文大学、香港大学、北京大学、Φ-Institute |
| 提交 | 2026-09-15,arXiv:2609.16644(cs.RO),8 页 8 图 3 表 |
| 链接 | arXiv 摘要页 · arXiv 全文 · 项目页 |
| 代码状态 | 未开源。项目页标注 "Preprint coming soon",GitHub 上仅有项目页仓库,无方法实现仓库 |
| 硬件平台 | Unitree G1 人形 + 两只 BrainCo Revo 2 灵巧手;1 个头部 + 2 个腕部 Intel RealSense D435i |
一句话总结
WholeBodyWAM 不重学全身行为,而是把 14B 预训练世界-动作模型(WAM)的操作先验保留下来,用统一全身控制器接口 UWBC 给异构控制器命令赋予一致物理语义,再用协调感知自注意力 CASA 在"手臂可操作性不足"的时刻放大操作流到全身控制流的信息通路,从而以 1.5 万条全身演示把桌面级 WAM 泛化为人形移动操作策略。
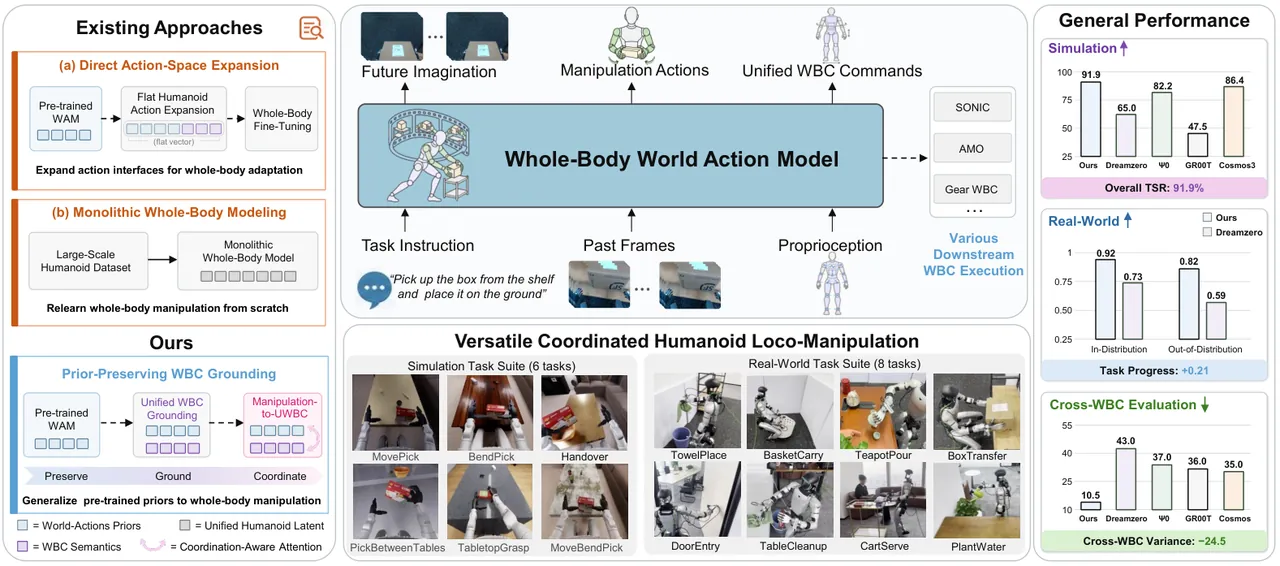
图 0:总览(论文 Fig. 1)。与"扩展动作接口"或"从零学习人形世界-动作映射"两条路线不同,WholeBodyWAM 通过 WBC 接地的协调保留并泛化预训练先验。
研究背景与动机
世界-动作模型(World Action Models, WAM)把机器人动作与未来视觉动态放在同一个生成模型里联合建模,为通用操作提供可复用的先验。DreamZero、Cosmos Policy、Fast-WAM 等工作验证了这条路线在桌面双臂场景的有效性:模型既想象未来画面,也输出动作,二者互为条件。然而这些研究的动作接口几乎都围绕机械臂与夹爪定义,动作空间是"手-物"局部交互的函数。
把人形机器人放进这个框架会遇到三个相互耦合的困难。其一是全身协调的复杂性:一次成功的移动操作不仅要求手-物交互合理,还要求模型知道何时、以何种方式让底座迈步、躯干俯仰、腰部旋转去配合手臂;其二是异构控制器语义:SONIC、AMO、GEAR、HugWBC 等全身控制器(WBC)暴露的命令本体物理含义各不相同,同样的身体运动在不同控制器下需要完全不同的任务空间命令与关节目标组合,动作语义无法直接复用;其三是人形数据稀缺:大规模机器人数据足以预训练 WAM,但成对的人形移动操作演示仍然稀少,直接监督"操作意图与全身调整如何配合"的信号严重不足。
已有工作沿两条路线试探。第一条是直接扩展动作接口:把预训练桌面 WAM 的动作头维度调整到人形自由度,再用全身演示微调,DiT4DiT 对人形双臂操作做过类似尝试。这条路保留了可迁移的世界-动作先验,但把异构 WBC 语义与复杂协调完全交给有限的微调监督去隐式学习,结果往往是高层操作意图还在、底层 WBC 命令却接地不良、全身行为在时间上不一致。第二条是整体式全身建模:MotionWAM、ω-0 等学习人形原生的全身 WAM,在控制器兼容的潜空间里统一移动与操作。这类模型能产生连贯的全身运动,但策略预测与控制器特定约定(例如 SONIC 的运动潜变量)纠缠在一起,并且依赖昂贵的大规模全身监督。
两条路线的共同盲点在于:它们都没有回答"预训练先验里已经有什么、人形场景真正缺什么"。论文给出的中心问题是——如何在不从零学习全身行为的前提下,把预训练的世界-动作先验泛化到人形移动操作?
作者的关键洞察是:预训练 WAM 已经捕获了丰富的操作先验,人形移动操作真正缺失的是对异构 WBC 的结构化接地,即一套规定"何时、如何"让全身行为与操作协调的机制。基于这一洞察,WholeBodyWAM 用三个互补设计完成泛化:结构化动作表示保留预训练的操作通路并新增独立的全身控制流;UWBC 为共享命令赋予一致物理语义、同时容纳控制器私有扩展;CASA 用任务方向的手臂可操作性调制注意力偏置,在需要更多全身协调的时刻加强操作流到全身控制流的信息流动。
预备知识
WAM 的生成骨架是视频扩散 Transformer(DiT):观测经视频 VAE 压成潜变量 token,未来画面与动作被组织成 token 序列,由 DiT 在流匹配(flow matching)目标下联合去噪。流匹配把生成建模为从噪声块到数据块的速度场回归,推理时用少步采样器沿流时间积分。WholeBodyWAM 继承的正是 DreamZero 的 14B 预训练视频 DiT 骨干与这套联合流匹配形式。
全身控制器一侧,SONIC 以关节空间参考与运动潜变量见长,AMO 接受平面速度、航向、绝对高度与躯干朝向并带转向标志,GEAR WBC 使用速度、高度、朝向外加派生偏航率,HugWBC 等提供通用跟踪接口。这些接口的维度、单位与语义都不一致:同一个"向前走并弯腰"的意图,在 SONIC 里是一串下肢关节位置,在 AMO 里却是几个任务空间标量。这种异构性正是跨控制器复用策略的主要障碍。
可操作性(manipulability)描述某个关节构型沿某方向产生末端速度的能力。带关节速度限的阻尼可操作性矩阵 $C^{v,\lambda}$ 把这一能力量化为方向相关的椭球;论文沿用既有做法离线构建体素化可操作性图,运行时即可查询"当前末端位姿体素内、沿任务方向的最大可达能力"作为参考值,为协调门提供状态依据。
方法详解
问题形式化。WholeBodyWAM 把人形移动操作写成任务上下文下的联合预测:给定上下文 $\mathbf{c}_{t}$(视觉历史 $\mathbf{o}_{0:t}$、当前机器人状态 $\mathbf{s}_{t}$、语言指令 $\ell$),同时预测未来视觉动态 $\mathbf{v}_{t:t+H}$、操作流 $\mathbf{m}_{t:t+H}$(臂关节目标与手指关节角)与全身控制流 $\mathbf{u}_{t:t+H}$(UWBC 命令):
$$ p_{\theta}(\mathbf{v}_{t:t+H},\mathbf{m}_{t:t+H},\mathbf{u}_{t:t+H}\mid\mathbf{c}_{t}). $$
沿用联合世界-动作建模的惯例,该条件分布可分解为世界因子与动作因子之积:
$$ p_{\theta}(\mathbf{v},\mathbf{m},\mathbf{u}\mid\mathbf{c}_{t}) = p_{\theta}^{v}(\mathbf{v}\mid\mathbf{c}_{t})\,p_{\theta}^{a}(\mathbf{m},\mathbf{u}\mid\mathbf{v},\mathbf{c}_{t}). $$
作者特别强调,这一分解描述的是联合分布的依赖结构,而不是"先推理视频、再推理动作"的串行流程:三条流在同一个生成骨干内实例化、联合优化、联合采样。
共享骨干与类型化 token 流。模型建立在预训练 14B 视频 DiT 之上。预训练 T5 文本编码器经 cross-attention 注入指令特征;预训练 Wan 视频 VAE 把观测压缩为潜视频 token;一个轻量状态编码器把当前机器人状态映射为本体感知条件 token。未来视觉 token、操作 token 与 UWBC token 构成三条类型化流,在每个未来时间步共享同一个预测块,再整体交给 DiT 处理。操作流完整保留预训练 WAM 的"视觉-操作"通路,UWBC token 则让面向控制器的全身行为第一次成为可显式寻址的对象。
训练目标。遵循联合流匹配形式,WholeBodyWAM 最小化按模态加权的速度场回归损失:
$$ \mathcal{L}(\theta)=\mathbb{E}\!\left[\sum_{k}\lambda_{k}w_{k}(\tau)\left\|f_{\theta}^{k}(\mathbf{x}_{\tau},\tau,\mathbf{c}_{t})-\dot{\mathbf{x}}^{k,*}\right\|_{k}^{2}\right], $$
其中 $\mathbf{x}_{\tau}$ 是流时间 $\tau\in[0,1]$ 处的联合噪声块,$\dot{\mathbf{x}}^{k,*}$ 是流 $k\in\{v,m,u\}$ 的目标速度,$\lambda_{k}$ 平衡三条流的损失,$w_{k}(\tau)$ 是随流时间变化的权重。这个目标本身并不新,新的是被它联合优化的 token 结构。
统一全身控制器接口 UWBC。把异构命令直接拼成扁平动作向量会抹掉控制语义,并把策略焊死在某一个控制器接口上。UWBC 按共享物理语义组织命令:任务空间全身命令、下肢与腰部关节位置和速度共同构成 46 维共享块;索引 $[46,56)$ 的 10 个残差槽容纳控制器私有命令(含离散控制模式):
$$ \mathbf{u}_{t}=[\mathbf{u}_{t}^{\mathrm{sh}},\mathbf{u}_{t}^{r}]\in\mathbb{R}^{56},\quad \mathbf{u}_{t}^{\mathrm{sh}}=[\mathbf{u}_{t}^{\mathrm{task}},\mathbf{q}_{t}^{\mathrm{lower}},\dot{\mathbf{q}}_{t}^{\mathrm{lower}}]\in\mathbb{R}^{46}. $$
其中 $\mathbf{u}_{t}^{\mathrm{task}}\in\mathbb{R}^{16}$ 为任务空间命令,$\mathbf{q}_{t}^{\mathrm{lower}},\dot{\mathbf{q}}_{t}^{\mathrm{lower}}\in\mathbb{R}^{15}$ 为下肢与腰部的期望关节位置与速度。共享槽位有明确登记:$[0,3)$ 底座线速度、$[3,6)$ 底座角速度、$[6,8)$ 航向 $(\sin\psi,\cos\psi)$、$[8,10)$ 骨盆平面位置、$[10,11)$ 骨盆高度、$[11,13)$ 骨盆俯仰/侧倾、$[13,16)$ 躯干相对骨盆姿态、$[16,31)$ 与 $[31,46)$ 下肢/腰部关节位置与速度。对接下游控制器时,按其注册语义与能力档案激活对应字段,未支持的字段一律掩码——SONIC 使用关节空间槽 $[16,46)$,AMO 把平面速度、航向、绝对高度、躯干朝向映射到 $[0,2)$、$[6,8)$、$10$、$[13,16)$ 并把转向标志放进残差槽,GEAR WBC 复用速度/高度/朝向槽并以槽 $5$ 承载派生偏航率。
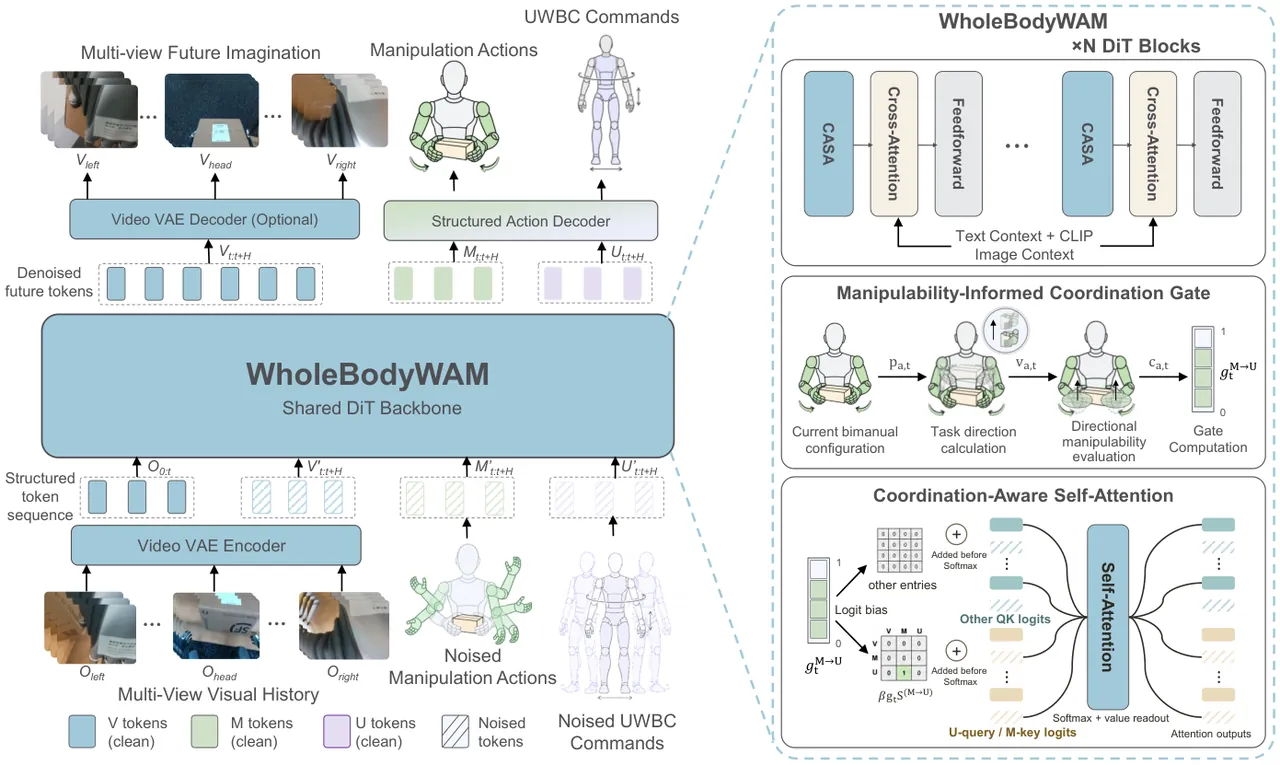
图 1:模型架构(论文 Fig. 2)。共享 DiT 从结构化 token 序列联合生成未来视觉动态、操作动作与 UWBC 命令;右侧 CASA 依据任务方向可操作性的下降自适应加强操作流到 UWBC 流的注意力。
协调感知自注意力 CASA。人形移动操作中的协调天然是方向性且状态依赖的:当手臂沿任务方向的可操作性不足时,身体必须补偿性移动。CASA 用门控注意力偏置把这一物理直觉写进注意力 logits:
$$ \mathbf{L}^{\prime}_{t}=\frac{\mathbf{Q}\mathbf{K}^{\top}}{\sqrt{d}}+\mathbf{M}^{\mathrm{nat}}+\beta g_{t}\mathbf{S}^{M\rightarrow U}, $$
其中 $\mathbf{M}^{\mathrm{nat}}$ 是原生自注意力掩码,$\beta>0$ 是固定偏置强度,门 $g_{t}\in[0,1]$ 决定何时打开;选择子 $S_{ij}^{M\rightarrow U}=1$ 仅当 $i$ 是同一预测块内的 UWBC 查询、$j$ 是操作键。原生可见性在三条流之间完全保留,偏置只单向加强"操作→全身控制"。
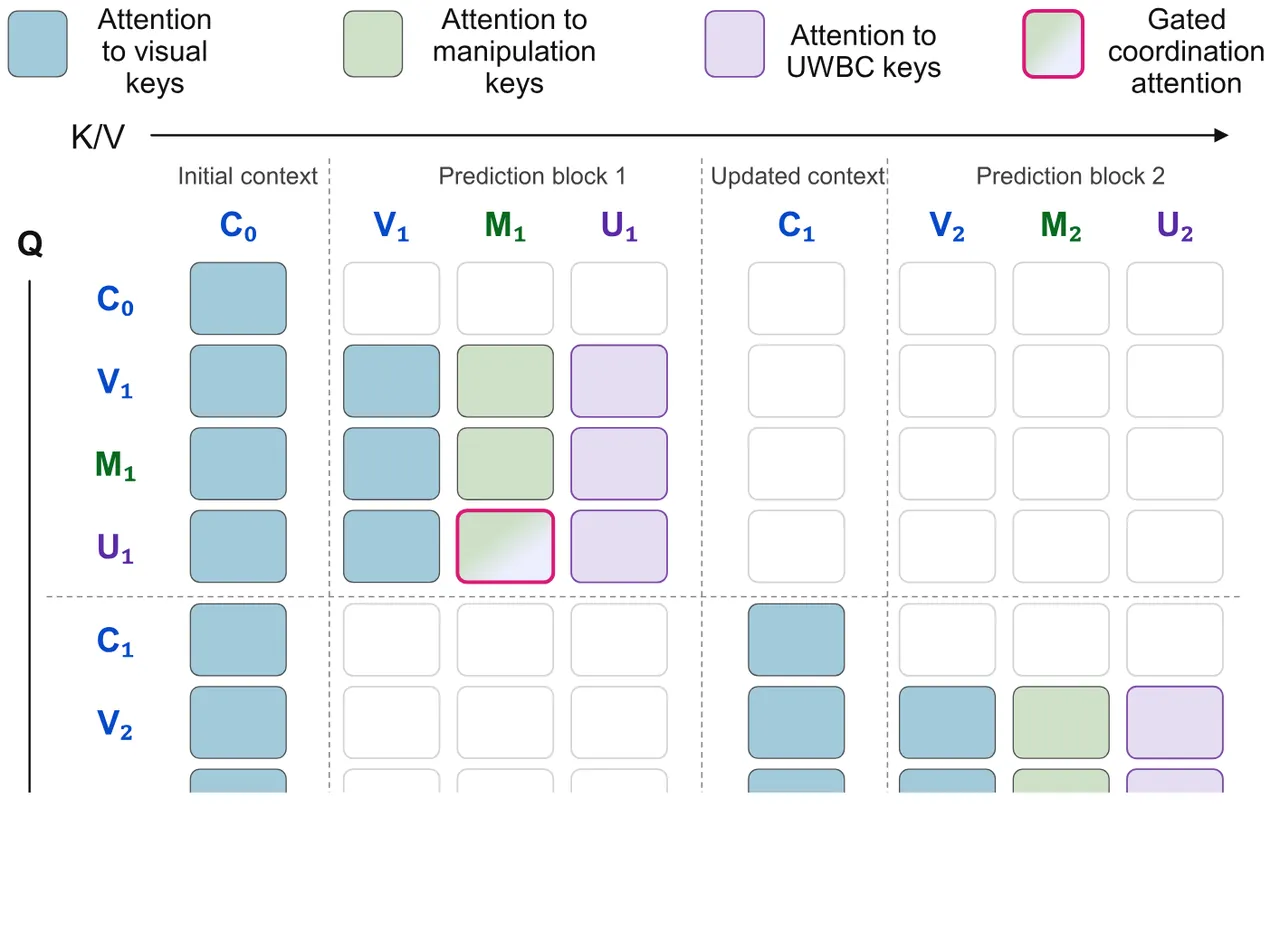
图 2:分块因果注意力与门控协调(论文 Fig. 3)。预测块内 UWBC 查询对操作键的注意力被门控偏置选择性增强,其余可见性保持原生。
门的信号来自任务方向可操作性的相对下降。对每只手臂 $a\in\{L,R\}$,先用相邻观测末端位置差分估计任务方向:
$$ \mathbf{v}_{a,t}=\frac{\mathbf{p}_{a,t}-\mathbf{p}_{a,t-1}}{\Delta t},\qquad \hat{\mathbf{d}}_{a,t}=\frac{\mathbf{v}_{a,t}}{\|\mathbf{v}_{a,t}\|_{2}}. $$
再沿该方向计算带关节速度限的阻尼可操作性:
$$ c_{a,t}=\left[\hat{\mathbf{d}}_{a,t}^{\top}\bigl(C_{a}^{v,\lambda}(\mathbf{q}^{\mathrm{obs}}_{a,t})\bigr)^{-1}\hat{\mathbf{d}}_{a,t}\right]^{-1/2}. $$
运行时参考值 $c^{\mathrm{ref}}_{a,t}$ 取自离线体素化可操作性图:在当前末端位姿体素内、沿估计任务方向采样到的最大径向能力。单臂门由相对下降给出,全局门取两臂较大者:
$$ g_{a,t}=1-\operatorname{clip}\!\left(\frac{c_{a,t}}{c^{\mathrm{ref}}_{a,t}+\epsilon_{m}},0,1\right),\qquad g_{t}^{M\rightarrow U}=\max(g_{L,t},g_{R,t}). $$
于是"任一只活跃手臂沿任务方向接近能力边界"就足以触发操作意图对全身命令的强条件化:手臂够不着的时刻,正是底座与躯干该动的时刻。
训练配方。模型从预训练 14B WAM 初始化并保留其世界-动作骨干。作者在 SIMPLE 基准中用 PICO 4 Ultra 头显与腕部追踪器采集 1.5 万条全身移动操作演示,每条演示转成 SMPL 人体运动序列,再经 GMR 重定向到 G1 机体得到机器人运动参考;随后按每个 UWBC 共享槽位预定义的物理语义、坐标约定与单位,从运动参考中算出监督目标,时间对齐后并入后训练数据集。后训练使用 LoRA(秩 $r=4$、缩放 $\alpha=4$),优化 50,000 步、学习率 $10^{-5}$、每 GPU batch size 1;推理用 16 步去噪、二阶 UniPC 流匹配采样器与固定噪声调度偏移 5。整套配方刻意轻量:可训练增量只是 LoRA 与新增 token 通路,预训练先验几乎不被扰动。
flowchart TD
  L["Language instruction"] --> T5["T5 text encoder"]
  O["Visual history o_0:t"] --> VAE["Wan video VAE"]
  S["Robot state s_t"] --> SE["Lightweight state encoder"]
  T5 --> DIT["Shared 14B pre-trained video DiT"]
  VAE --> DIT
  SE --> DIT
  DIT --> VS["Future visual stream v"]
  DIT --> MS["Manipulation stream m
arm + finger joint targets"]
  DIT --> US["UWBC stream u
46 shared + 10 residual slots"]
  P["Observed EE positions"] --> DIR["Task direction Eq.6"]
  DIR --> MAN["Directional manipulability Eq.7"]
  MAN --> GATE["Gate g_t = max of both arms Eq.8 Eq.9"]
  GATE --> CASA["CASA bias on M-to-U attention Eq.5"]
  MS --> CASA
  CASA --> DIT
  US --> SONIC["SONIC: joint slots 16-46"]
  US --> AMO["AMO: vel heading height torso + turn flag"]
  US --> GEAR["GEAR WBC: vel height orientation + yaw slot 5"]
图 3:按论文方法绘制的信息流。CASA 的门由观测末端运动与离线可操作性图在线算出,只调制注意力偏置,不改变三条流的联合生成。
实验结果
设置与指标。真机平台为 Unitree G1 配两只 BrainCo Revo 2 灵巧手,视觉来自 1 个头部与 2 个腕部 RealSense D435i;仿真在 SIMPLE 基准上进行。指标有三:任务成功率 TSR(在评估时域内完成全部目标的比例)、任务进度 TP(首次失败或不可逆偏离前沿有序阶段的归一化进度)、跨 WBC 方差(各控制器平均 TSR 的总体方差,单位 pp²,越小越稳健)。所有方法-任务组合均跑 20 次独立试验。基线覆盖 WAM 与 VLA 两族:DreamZero、同数据后训练的 DreamZero-PT、Cosmos-3、原生全身 VLA Ψ₀、人形 VLA GR00T N1.6。
仿真主结果。在 SONIC 控制器、六个任务、三级扰动(L0/L1/L2)下,WholeBodyWAM 总体 TSR 达 91.9%,比 DreamZero、DreamZero-PT、Cosmos-3 分别高 26.9、18.3、5.6 个百分点,比最强 VLA 基线 Ψ₀(82.2%)高 9.7 个百分点。与使用相同后训练数据的 DreamZero-PT 相比仍有 18.3 个百分点优势,说明增益并非来自"更多人形监督";与 Cosmos-3 的差距集中在协调密集任务 PickBetweenTables 与 MoveBendPick(+10.0 与 +11.7 点),而在 Handover、TabletopGrasp 这类操作主导任务上两者基本持平——先验保留与协调接地的分工在数据里清晰可见。
| 方法 | MovePick | BendPick | Handover | PickBetweenTables | TabletopGrasp | MoveBendPick | 总体 |
|---|---|---|---|---|---|---|---|
| DreamZero | 70/65/55 | 75/70/60 | 85/80/70 | 50/45/35 | 90/85/75 | 60/55/45 | 65.0 |
| DreamZero-PT | 80/75/65 | 85/80/70 | 90/85/80 | 60/55/45 | 95/90/80 | 70/65/55 | 73.6 |
| Cosmos-3 | 90/85/80 | 95/90/80 | 100/95/90 | 85/80/70 | 100/95/85 | 85/80/70 | 86.4 |
| GR00T N1.6 | 55/50/40 | 65/60/50 | 60/55/45 | 30/25/15 | 75/70/60 | 40/35/25 | 47.5 |
| Ψ₀ | 90/85/75 | 90/85/80 | 95/90/80 | 75/70/60 | 100/95/90 | 80/75/65 | 82.2 |
| WholeBodyWAM | 95/90/85 | 100/95/90 | 100/95/90 | 95/90/80 | 100/95/85 | 95/90/85 | 91.9 |
| 去掉 CASA | 90/85/80 | 95/90/85 | 100/95/85 | 85/80/75 | 95/90/85 | 90/85/75 | 86.9 |
| 去掉 UWBC | 90/85/75 | 95/90/80 | 95/90/85 | 85/80/70 | 95/90/85 | 85/80/70 | 84.7 |
| 去掉 SAF | 85/80/70 | 90/85/75 | 95/90/80 | 80/75/65 | 95/90/80 | 80/75/65 | 80.8 |
表 1:SIMPLE 仿真任务成功率(%,SONIC 控制器),每格为 L0/L1/L2 三级扰动结果(论文 Table II)。
跨控制器鲁棒性。对 SONIC、AMO、GEAR WBC 三个控制器分别做任务微调后横向比较,WholeBodyWAM 取得三控制器平均 TSR 89.2% 与最小方差 10.5 pp²;Cosmos-3 为 80.2% 与 35.0 pp²,Ψ₀ 75.2%/37.0,DreamZero-PT 65.7%/39.0,DreamZero 56.7%/43.0,GR00T N1.6 39.8%/36.0。方差降低约 70% 的意义在于:只在一个 WBC 上训练过的模型换控制器时需要重学命令约定,而 UWBC 把"内部全身意图"与"控制器命令约定"分离,使同一份接地先验可以按语义映射到不同接口。
| 方法 | 三控制器平均 TSR(%) | 跨控制器方差(pp²) |
|---|---|---|
| WholeBodyWAM | 89.2 | 10.5 |
| Cosmos-3 | 80.2 | 35.0 |
| Ψ₀ | 75.2 | 37.0 |
| DreamZero-PT | 65.7 | 39.0 |
| DreamZero | 56.7 | 43.0 |
| GR00T N1.6 | 39.8 | 36.0 |
表 2:跨 WBC 评估(论文 Fig. 4 数据)。均值越高、方差越低代表对控制器选择越不敏感。
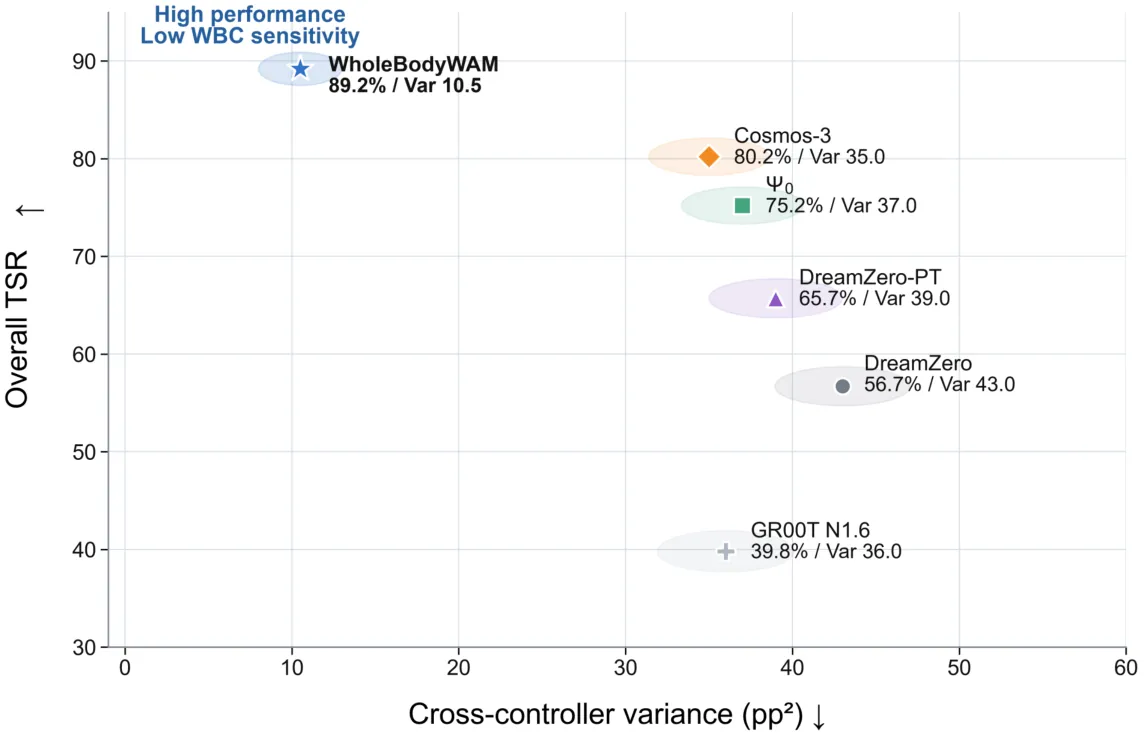
图 4:跨 WBC 评估(论文 Fig. 4)。WholeBodyWAM 位于"高均值、低方差"角,其余方法沿方差轴明显右移。
下游微调效率。在每任务 50/100/200/300 条演示的四档预算下(主实验用 100 条),WholeBodyWAM 的优势在少样本端最大:50 条演示时各基线的 TSR 普遍塌缩到 20%-60% 区间,而本文方法仍维持 60%-90% 以上的任务平均成功率。这与"预训练先验经结构化接地被复用"的叙事一致——微调只需要教会模型把已有意图翻译成 UWBC 命令,而不是重新教会它操作。
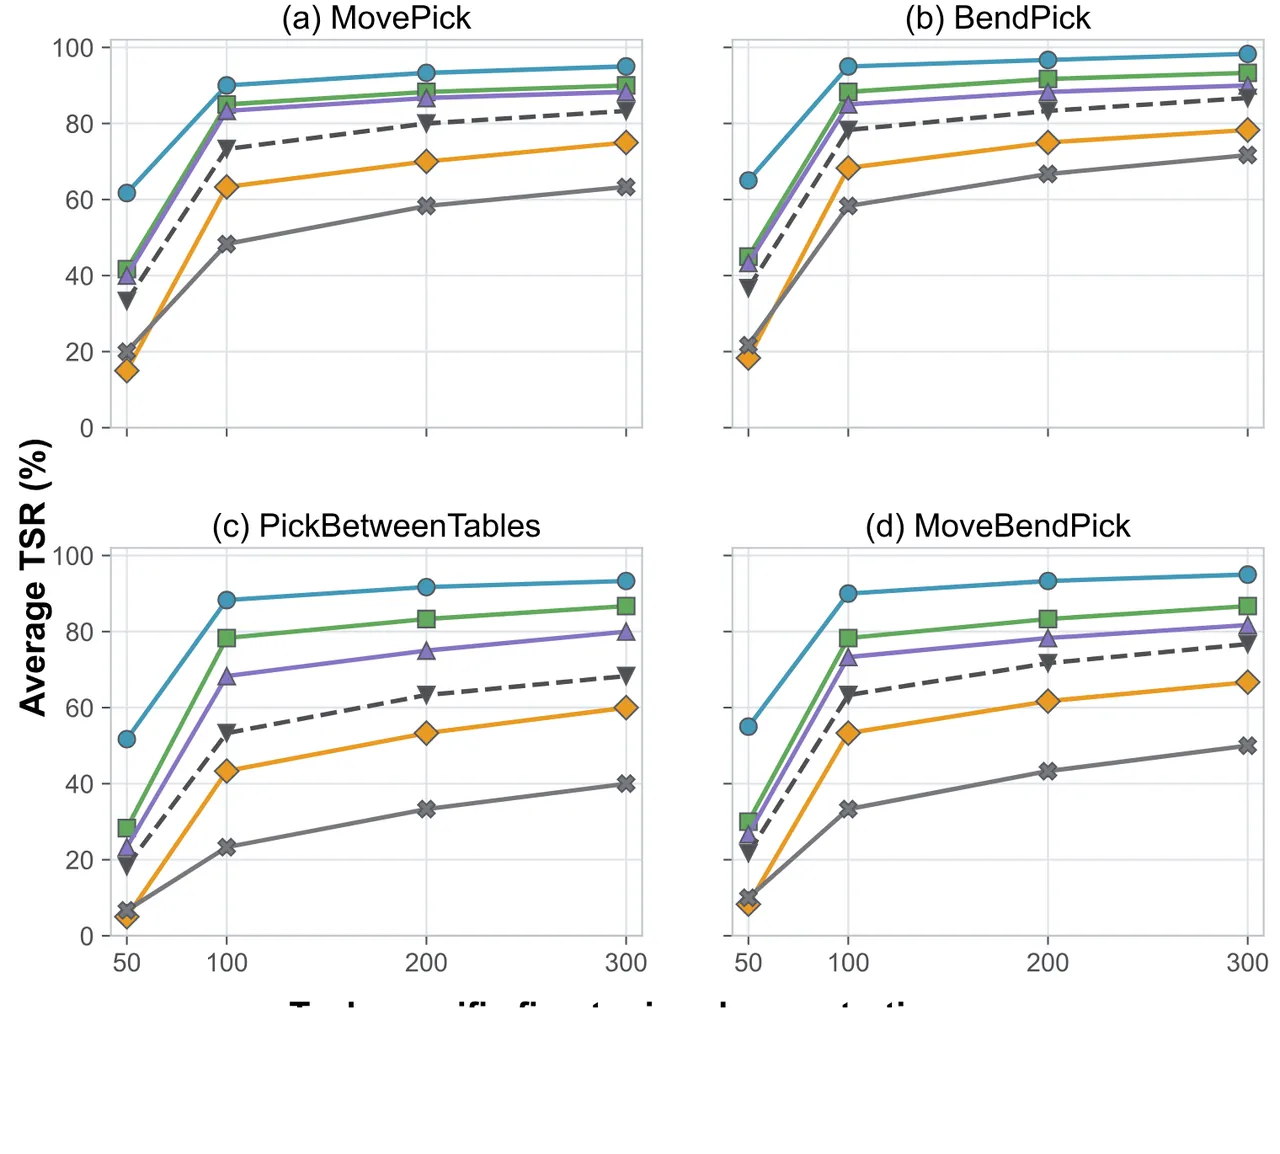
图 5:下游微调效率(论文 Fig. 5)。演示数越少,结构化接地带来的差距越大。
真机结果。八个真机任务上,ID 条件 WholeBodyWAM 平均 TSR 81.3%,DreamZero 57.5%;OOD 条件(改变物体配置与语言指令)为 68.8% 对 40.0%,且 ID 到 OOD 的降幅更小(12.5 对 17.5 个百分点)。任务级差异同样服从"协调强度"这一主轴:操作主导的 TableCleanup 上两者只差 5 个点(90 对 85),而需要大幅身体重构的 BasketCarry、DoorEntry 上差距达 35 个点,BoxTransfer 达 40 个点,OOD 的 DoorEntry 差距扩大到 45 个点。任务进度指标给出同一结论:ID/OOD 平均 TP 为 0.92/0.82,DreamZero 为 0.73/0.59,OOD 上 0.23 的进度提升正是摘要中那个数字的来源。
| 条件 / 方法 | TowelPlace | BasketCarry | TeapotPour | BoxTransfer | CartServe | DoorEntry | TableCleanup | PlantWater | 总体 |
|---|---|---|---|---|---|---|---|---|---|
| ID · WholeBodyWAM | 85 | 75 | 85 | 75 | 80 | 80 | 90 | 80 | 81.3 |
| ID · DreamZero | 65 | 40 | 75 | 35 | 50 | 45 | 85 | 65 | 57.5 |
| OOD · WholeBodyWAM | 75 | 55 | 80 | 60 | 65 | 70 | 80 | 65 | 68.8 |
| OOD · DreamZero | 50 | 15 | 65 | 20 | 30 | 25 | 70 | 45 | 40.0 |
表 3:真机八任务成功率(%,论文 Table III)。ID 为训练分布内,OOD 改变物体配置与指令。
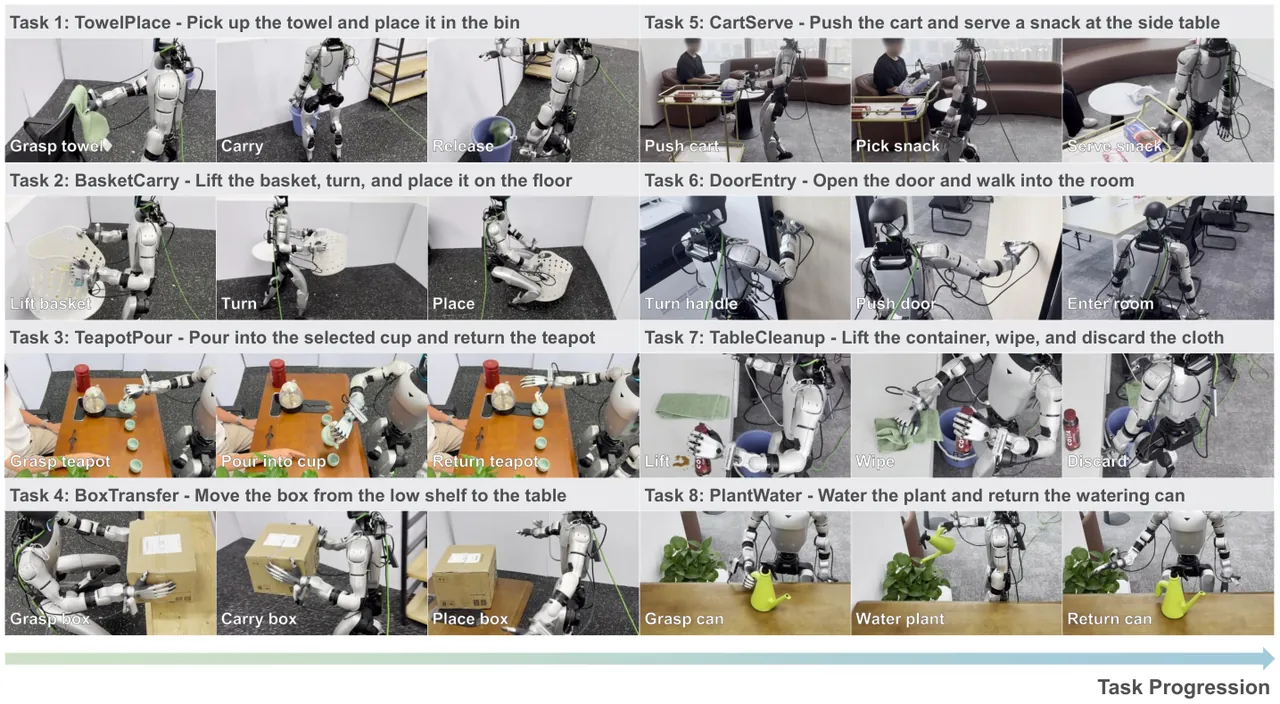
图 6:真机八任务定性结果(论文 Fig. 6),覆盖操作主导与协调密集两类行为。
涌现的全身协调。最耐人寻味的是 TowelPlace 的 OOD 案例:把毛巾支撑向外移 10 厘米后,毛巾超出初始手臂工作空间;模型第一次局部伸手失败后,主动向前迈了一小步并调整躯干朝向扩展可达范围,第二次抓取成功。作者明确指出这一恢复序列不存在于演示数据中,将其解释为预训练 WAM 操作先验与增强的全身协调耦合后涌现的行为。单个定性案例不足以称为能力证明,但它至少说明协调门没有在分布外把身体"锁死"。
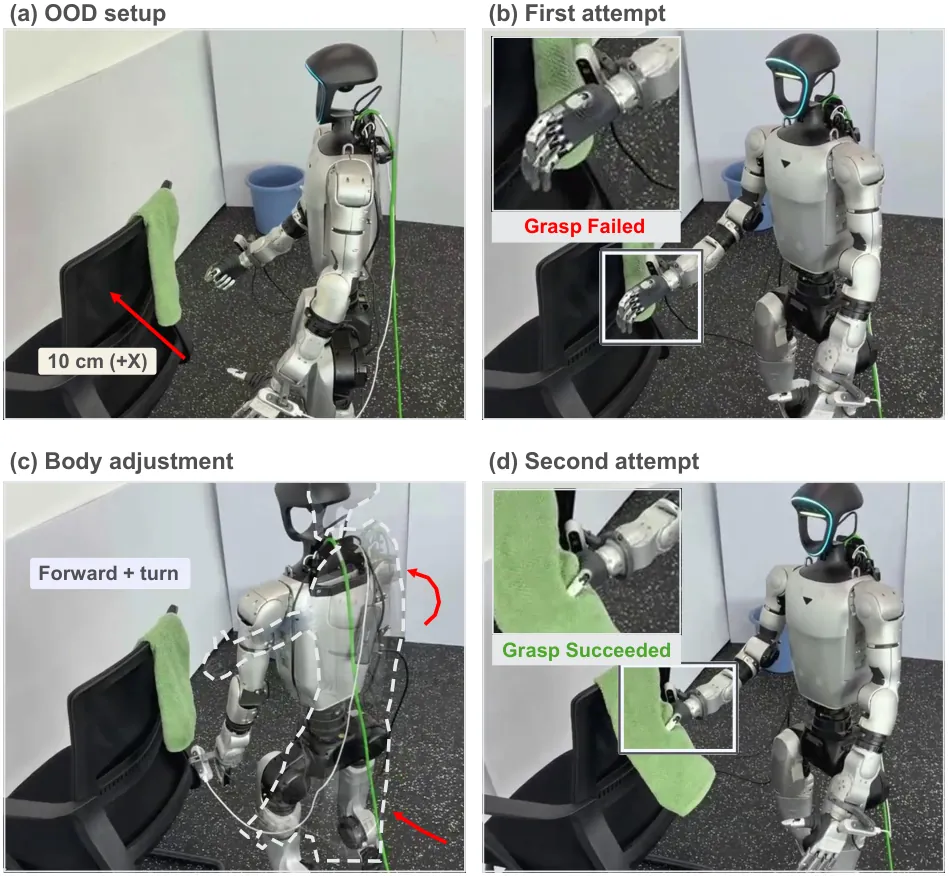
图 7:10 厘米位移下的抓取失败与身体调整恢复(论文 Fig. 8)。
消融。三个组件的贡献在六个仿真任务上分离:去掉 CASA(保留双流、恢复原生自注意力)总体 TSR 从 91.9% 降到 86.9%,且降幅集中在 PickBetweenTables(-8.3)与 MoveBendPick(-6.7),Handover 仅 -1.7,与"状态依赖的方向性协调只在需要大幅身体调整的任务上起作用"的预期一致;把 UWBC 换回原生 SONIC 命令(保留独立 WBC 通路与监督)降到 84.7%,说明显式物理语义本身就改善控制器接地;去掉结构化动作分解 SAF(用容量匹配的单流替代双流)降幅最大,到 80.8%,支持"保留预训练操作通路、让 WBC 命令单独可寻址"的设计选择。
局限性
其一,作者自己承认增益的分布并不均匀:在操作主导任务上,本文方法与 DreamZero 的差距很小(TableCleanup 90% 对 85%),因为预训练操作先验在目标位于手臂工作空间内、几乎不需要底座或躯干调整时已经足够。换言之,UWBC 与 CASA 解决的是协调问题,对纯操作精度没有额外贡献。
其二,跨控制器的"可移植"仍是有条件的:Fig. 4 的协议是对每个目标 WBC 分别做任务级微调,UWBC 提供的是共享语义接口与可复用的接地先验,而不是零样本换控制器的适配器;换控制器仍需在新接口上重新微调一遍。
其三,从实验设计看,真机只与 DreamZero 单一基线对比,且每个方法-任务组合 20 次试验;Ψ₀、GR00T N1.6、Cosmos-3 等更强基线只在仿真中出现,真机结论的外推范围有限。
其四,论文未报告端到端推理延迟与控制频率:14B 骨干加 16 步去噪采样在真机闭环里以何种频率运行、视觉历史窗口多长,正文均未给出,实时性只能从项目页演示视频间接推断。此外 CASA 的门依赖观测末端位置差分与离线体素化可操作性图,对观测噪声、标定误差与体素粒度敏感;涌现恢复也只有一个定性案例支撑。
总结与展望
WholeBodyWAM 的贡献不在某个单点模块,而在一次清晰的问题重构:人形移动操作的瓶颈不是操作先验不足,而是先验缺少通往异构全身控制器的结构化接地。UWBC 用共享物理语义把"意图"与"命令约定"解耦,CASA 用可操作性门把"何时协调"从数据里显式化,结构化动作分解则保证预训练通路不被新流污染。三者叠加,使 1.5 万条演示与 LoRA 级微调就足以把 14B 桌面 WAM 推向六仿真任务 91.9%、真机八任务 ID 81.3% / OOD 68.8% 的水平。
这条路线的延伸方向也清楚:UWBC 的残差槽能否容纳更多控制器族(含力控与步态模式)、CASA 的门能否从可操作性扩展到接触与平衡约束、以及在更大规模人形数据上验证"先验复用优于从头学习"是否依然成立。若代码与数据随正式版本放出,UWBC 作为跨控制器语义层的价值将比模型本身更经得起检验。
金句
"These results suggest a path toward scalable humanoid whole-body intelligence by extending pre-trained world-action priors through structured WBC grounding and coordination, rather than relearning whole-body behavior from scratch."
(译:这些结果指向一条通往可扩展人形全身智能的路径——通过结构化的 WBC 接地与协调来扩展预训练的世界-动作先验,而不是从零重学全身行为。——论文摘要)