QF3:流策略的 off-policy 强化学习
视频加载中
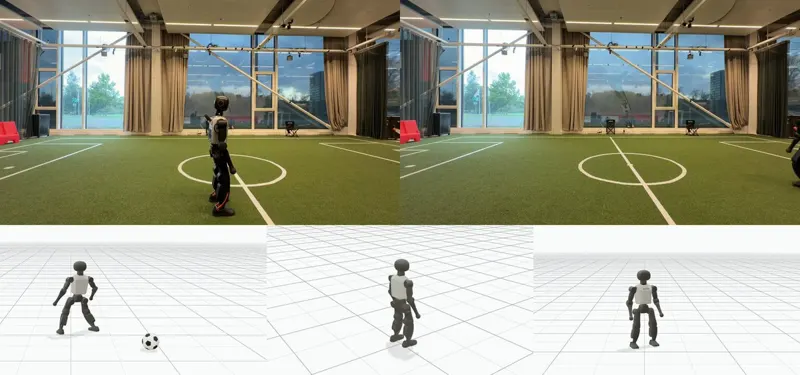
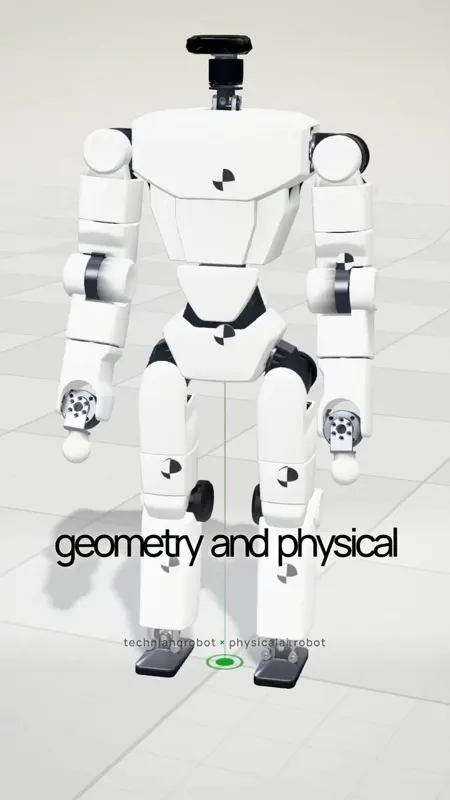
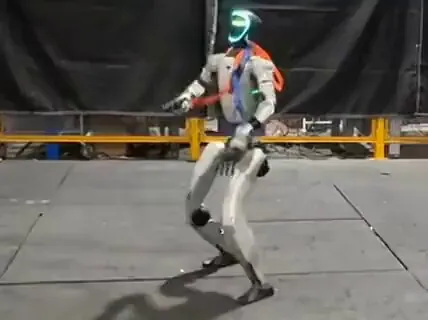
视频加载中QF3 是在线 off-policy 算法:用流匹配加评论家动作梯度训练流策略,梯度经一步输出预测反传,且只作用在靠近回放动作的那些维度上,保证评论家与预测都可信。作者称这是首个从零训练人形行走策略并零样本迁移到硬件的 off-policy 流策略方法。
Category: reinforcement-learning
Author: @robotsdigest
Date: 2026-10-11T00:00:00
Duration: 6.033s
Reference: https://arxiv.org/abs/2610.08789