1990–2026 · 五条技术脉络 · 33 个里程碑
61 篇站内收录论文 · 四条谱系 · 分类依据 arXiv:2605.12090
用文本提示或参考图即可检测分割未知物体无需任务训练速度够实时
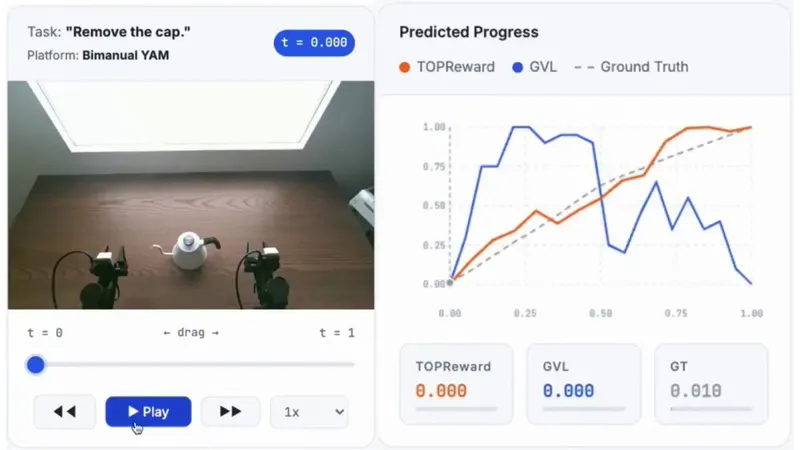
直接从预训练 VLM 的 token 概率读取内部信念作为奖励信号,无需训练或微调,适配开源模型。
提出双脑最小充分表示方法,用于视觉-语言导航,在效率与性能间取得平衡,提升具身导航的泛化。
Yihao Wu, Chenyi Xu, Liqi Yan
研究agent系统中世界模型的安全性问题,分析世界模型可能成为假先知的风险,提出安全评估与防护方法。
Erik Imgrund, Anna Wimbauer, Klim Kireev
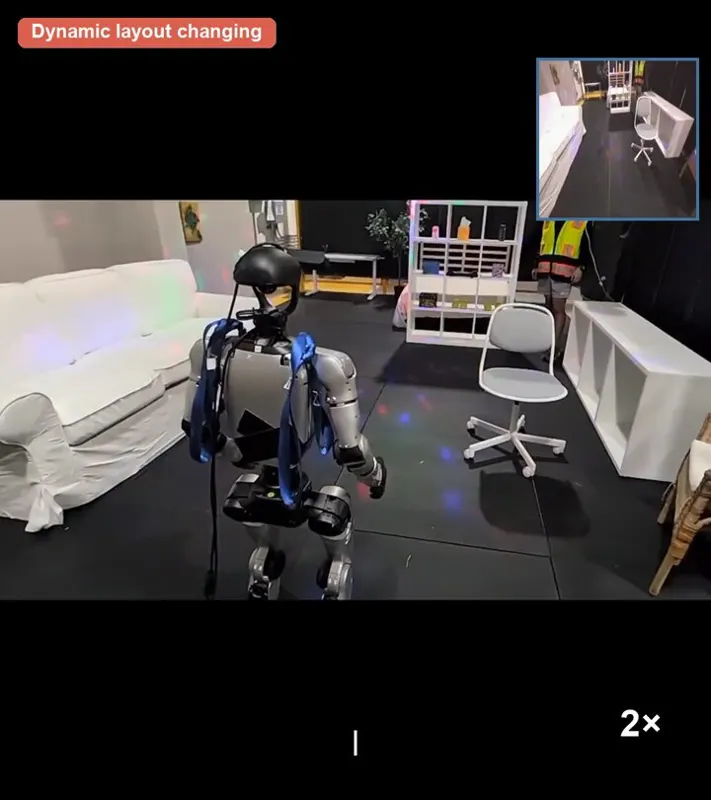
VLK模型展示从合成场景中学习人形机器人运动操作,结合视觉、语言和运动学信息。
动作条件视频世界模型预测未来观测,本文提出通过机器人渲染构建机器人分解的世界模型。
Byungjun Kim, Taeksoo Kim, Hyunsoo Cha
接触密集型机器人操作需要物理交互,ViTacWorld 扩展视触觉世界模型以支持此类操作。
Yunao Huang, Shiyu Sang, Haotao Lu
研究从人类交互中推断环境动力学的世界模型的可辨识性问题。
Xiangteng Zhang, Yang Guan, Bo Zhang
多模态大模型正成为航空任务的核心,本工作提出零样本任务级评估框架。
Suman Navaratnarajah, Taehyoung Kim, Jona Ruthardt
联合嵌入预测架构(JEPA)近期兴起,本文将其扩展为从动作学习声音的世界模型。
Ziyu Wang, Kun Fang, Yann LeCun
TRACE-RealWorld 解决世界模型作为物化视图的数据管理一致性问题,提供可审计契约。
Edward Y. Chang
Black Forest Labs发布FLUX 3,定位为真实世界模型而非文生视频或文生图。将图像、视频、音频放入同一套多模态流匹配架构,学习世界如何运作,同一底座同时支持内容生成和具身动作预测。