Skip to content
←返回能力前沿雷达

SOTA · 频道

音视频

视频生成与语音音频一条频道:文生/图生视频的物理与时序一致性,TTS 自然度与语音克隆,音乐生成,以及 ASR

音视频并成一条频道,是因为生成侧早已不是两条独立管线,而读者要的东西也从来不是一条无声视频加一段配音。前沿的主战场是联合生成:同一次前向里把画面、环境音、语音一起出出来,口型与音素对得上才算成立 —— 这条能力同时属于视频和音频,把它拆到两个入口,读者就得自己在两页之间拼一个结论。顶栏一个入口对应读者一个任务(「我要一条能用的片子」),这是频道存在的理由。 但两把尺子不合并,频道页因此画成员分段而不是混排一张大梯子。视频量的是时序一致性(物体跨帧保持同一性)、物理合理性(重力、碰撞、遮挡)、可控性(运镜、时长、首尾帧约束),读数是 VBench、EvalCrafter 与竞技场 Elo;音频量的是 TTS 自然度、语音克隆相似度、ASR WER 与音乐生成偏好。合成一把尺子等于把「视频现在做到什么程度」和「语音现在做到什么程度」两个问题混成一个答案,谁也没回答。 当前读数分三段看。视频侧梯顶是 Gemini Omni(create anything from any input,靠逐步对话编辑视频,把交付单位从「一次抽卡」提到「一段可改素材」),本站同步的竞技场文生视频榜(2026-09-22)榜首 gemini-omni-1.1-flash 是 Elo 1516、仅 1,784 票、CI ±15,第 2 名同门 1513、26,576 票、±9,3 分差远小于各自 CI,统计不可区分,正确表述是 Omni 系列并列榜首;图生视频榜第 1 是 minimax-h3(1495、57,112 票)。同域另有 Seedance 2.5(单次叙事 30s)、Kling 3.0 系列与开放权重的 Wan。音频侧再分语音与音乐两类:语音是 Eleven v4 Turbo(模型侧中位推理延迟约 100ms)、Gemini 3.8 Flash TTS(130 语言、语音设计与克隆、单请求最多 2 个说话人)、Eleven v3(70+ 语言、单次 5,000 字符)与开源本地的 VoiceStudio(42,831 star,可离线跑完整条 TTS/ASR/音乐管线);音乐是 Suno v5 与开放权重的 YuE2,两者都有 WildSongBench 的 SongBench 第三方均分可读。 Kling(video+image+audio)与 Seedance(video+audio)靠联合生成同时挂两个成员域,它们在两个分段里都出现是刻意的,不是重复收录:读者从视频那把尺子进来要看见它,从音频那把尺子进来也要看见它。

尺子视频:VBench、EvalCrafter、物理与时序一致性。音频:TTS 自然度、语音克隆相似度、音乐生成、ASR WER

SOTA 阶梯

11

文生视频、图生视频、物理与时序一致性

尺子VBench、EvalCrafter、物理与时序一致性
视频生成影音创作梯顶A

Gemini Omni:视频交付单位从「一次抽卡」变成「一段可对话的编辑过程」

Google DeepMind 的视频与多模态生成模型,官方定位 create anything from any input, starting with video:逐步对话编辑视频,每次编辑建立在上一次之上并维持连贯场景,交付单位从一个镜头提到可改素材;另两条:真实世界知识、任意参考合成单一输出。水位连票数读:Artificial Analysis 竞技场(2026-09-22,本站同步)文生视频榜 gemini-omni-1.1-flash 以 Elo 1516 第 1,但只有 1,784 票、CI ±15;第 2 同门 1513、26,576 票、±9,3 分差远小于各自 CI,统计不可区分,即 Omni 系列并列榜首。图生视频榜第 1 是 minimax-h3(1495、57,112 票),Omni 以 1488、3,734 票第 2。定价:输入 $1.50/1M tokens,输出文本 $9.00/1M、视频 $17.50/1M,720p 约 $0.10/秒、30 秒约 $3。付费层 GA、免费层无。闭源不可自托管、不能微调。置信度 A(已确认),本站视频域首条 A 档;A 指读数可信可核,不等于无争议第一。

1516Arena T2V Elo(1784 票)已确认 · 2026-09
产品Google DeepMind官网
Gemini Omni:视频交付单位从「一次抽卡」变成「一段可对话的编辑过程」
视频生成影音创作梯顶C

可灵 3.0 系列:音频原生进模型、画面到 4K,参数化镜头语言仍是它的护城河
快手可灵是国内最早把视频生成推到「能接商业单」水位的一条主线,长期强项不在纯文生视频,而在图生视频与运镜控制:先由图像环节锁定构图与角色,再让视频模型在确定的关键帧上补间,配合首尾帧约束与推/拉/摇/移/环绕/跟随的镜头参数,做出可预测的短片段。3.0 系列(官方 release-note 横幅:全面开放 API)带来三处实质跃迁——音频原生进模型(5/10/12 秒音频档)、图像与视频原生 2K/4K、智能分镜与元素参考把多镜头连贯从剪辑问题变成模型可控问题;型号分工为 3.0 / 3.0 Omni / 3.0 Turbo、Kling Image 3.0 与 -omni、Native 4K Video、Motion Control。竞技场水位说实话:图生视频 kling-v3-pro 第 19(Elo 1354),前面是 MiniMax h3、gemini-omni、wan3.0、seedance-2.5。3.0 系列的官方发布精确日期我们未拿到权威源,指标日期只按可核验月份记 2026-09。闭源、只走厂商接口;我们未做基准复现,置信度记 C。

3.0 / Omni / Turbo当前旗舰系列厂商宣称 · 2026-09
产品快手 Kuaishou官网
可灵 3.0 系列:音频原生进模型、画面到 4K,参数化镜头语言仍是它的护城河
视频生成影音创作梯顶C

Seedance 2.5:把视频交付单位从「一个镜头」提到「30 秒叙事」

字节 Seed 的视频生成主线。1.x 是文生/图生的静音短镜头,2.0 起换成统一多模态音视频联合生成架构(文本/图像/音频/视频四类输入),2.5 把交付单位直接提到 30 秒一段叙事,并支持再续写两次、白模控制、绿幕编辑、专业运镜与表演调度。第三方水位是它最硬的地方:本站同步的 Artificial Analysis 竞技场(2026-09-22)图生视频 dreamina-seedance-2.5-720p 第 4(Elo 1477),文生视频 2.0 第 5(1479)、2.5 第 7(1474)。闭源,只走 Dreamina / 火山引擎 / BytePlus,不能自托管与微调;SeedVideoBench-2.0 是内部评测,无法独立复现。我们未做基准复现,置信度记 C(厂商宣称)。

30s单次生成叙事时长厂商宣称 · 2026-09
产品ByteDance Seed官网
Seedance 2.5:把视频交付单位从「一个镜头」提到「30 秒叙事」
视频生成影音创作梯顶C

Wan 万相:视频生成侧的开放权重基线,让整个生态能在自己机器上迭代

阿里通义万相把视频生成模型以 Apache-2.0 放出权重,是视频域里最重要的公共基线。它的价值与闭源服务不同:不在于「今天出片最好看」,而在于可微调、可复现、可在自己的推理栈上跑——LoRA、ControlNet 式条件控制、量化加速、蒸馏少步数这一整套生态工作都围绕它展开。对情报站来说,一个开放权重基线意味着「视频生成现在能做到什么」这个问题第一次有了可以自己验证的参照系,而不必相信厂商精选样本。许可与仓库公开这两条我们已核验,画质与物理表现仍是 C 级厂商口径。

Apache-2.0开放权重许可厂商宣称 · 2025-07
产品阿里巴巴通义 Alibaba Tongyi官网Repo
Wan 万相:视频生成侧的开放权重基线,让整个生态能在自己机器上迭代
图像生成设计与前端梯顶C

FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线

Black Forest Labs 的 FLUX 家族用整流流(rectified flow)Transformer 做图像生成,并放出 Apache-2.0 的 dev 档权重,是开源侧最重要的图像基线;Kontext 一档把「按指令改这张图的局部而不动其余」做成了可用能力。我们的采集库里另有 FLUX 3 的发布记录,厂商把它定位成统一图像/视频/音频的世界模型,这一主张我们记为待核验。

Apache-2.0开放权重档位(dev)厂商宣称 · 2024-08
产品Black Forest Labs官网Repo
FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线

TTS 自然度、语音克隆、音乐生成、ASR

尺子TTS 自然度、语音克隆、音乐生成、ASR WER
语音与音频影音创作梯顶C

Eleven v4:把克隆保真度推到会反噬训练数据的一代

ElevenLabs 新一代语音合成模型,分 Eleven v4(最高质量档)与 Eleven v4 Turbo(实时档,中位推理延迟约 100ms,官方脚注明确不含应用与网络延迟)两个型号,官方口径是在输出质量、音色准确度、一致性、情感、演绎、audio tags 与语言覆盖上全面优于 v3 并建议迁移。本站把它列为音频域闭源语音方向的梯顶,依据是这一代把优化目标从「更好听」换成了「更像」:参考音色的音色、节奏、演绎与其他习惯一并复刻,官方自己承认准确度与个人偏好不总是同一件事、你可能仍更喜欢它在 v3 里的声音。配套的工程含义很硬——数据清洗的责任被推回使用方,官方把展示样例明确标注为未做任何后期(无 EQ、压缩、归一化、去齿音、去喷麦),并直说听到削波与喷麦大概率是训练数据里的、模型只是准确捕捉了下来。可交付面是三个数:Turbo 约 100ms、单次 10,000 字符约 10 分钟音频(v3 为 5,000,长文本分段接缝多一倍)、官方称 90+ 语言而 FAQ 逐条列出 87 种,这个差我们照原样并列不替它抹平。四条边界必须认清:跨语言口音是默认行为变更而非开关(生成语言与参考语言不一致时出目标语言的地道发音,做成 toggle 官方称仍是研究项目、无时间表),依赖「带母语口音说外语」的人设要先实测;控制面收窄,只剩 Stability 与 Similarity,Style 与 Speed 滑块取消、SSML 不支持,细粒度演绎改用 audio tags 且官方坦承还不完美;模型持续演化是官方明写的,发布后仍会继续训练、行为可能随时间变化,把音色当品牌资产的团队要周期性重测;Voice Design 生成的音色在 v4 上可能不那么有表现力。闭源不可自托管,数据必须过 ElevenLabs,克隆合规责任在使用方;可自托管对照是 CosyVoice 3、VibeVoice、Kokoro(语音)与 YuE2(音乐,非商业许可)。与本站已收的 Eleven v3 是同一商用栈上的两代,不是替代关系。置信度 C(厂商宣称):无第三方可核验基准,本站未做盲听。

~100msv4 Turbo 中位推理延迟(模型侧,不含应用与网络)厂商宣称 · 2026-09
生产ElevenLabs官网
Eleven v4:把克隆保真度推到会反噬训练数据的一代
语音与音频影音创作梯顶C

Suno:把音乐生产后半段工序全部收进一个产品

文生歌这条路做得最完整的商业平台:一句风格描述、自己的歌词、一段哼唱或一段 riff 都能起步,几秒出带人声与配器的完整歌曲,然后在同一产品里延伸、改段、换风格、抽分轨、做母带。本站把它列为音频域音乐方向的闭源梯顶,依据是工序完整度而不是单点音质——绝大多数生成式音乐产品只覆盖出草稿与选一版两步,Suno 用 Stem 分离(最多 12 轨)、MIDI 导出与 Suno Studio 把改段、重编、母带接上了,Studio 给的是传统 DAW 语义(多轨时间线、take lanes、comping、手动 BPM 治速度漂移、逐 clip 变速变调),不是又一个 prompt 框;Custom Models 用 6 首以上自有作品训练最多 3 个私有风格变体,Voices(前身 Personas)用自己的演唱样本出歌并带本人验证步骤。档位切分很关键:免费档能做完创作(生成、歌词、Cover、裁剪淡入淡出、音频上传),Stem、Add Vocals、Voices、Custom Models 都在 Pro 或 Premier,Studio 仅 Premier 且仅桌面网页,所以实际选型要按 Premier 算成本。第三方基准里版本号并不等于质量:WildSongBench 上 v5 得 6.8721,高于 v6 的 6.5562 与 v6 Wild 的 6.4195,v4.5 6.6995、v5.5 6.7150,官方也明确要求按能力而非版本号描述。边界:闭源不可自托管,未发布的旋律与歌词必须上传;无稳定版本语义,同一首歌重生成会随模型更新而变;商用权利随订阅档位;控制粒度落在段落与风格上,没有可编辑的和弦轨,需要乐理级修改要么靠 Studio 多轨重编,要么选 YuE2 那种暴露 ABC 乐谱的开放模型。置信度 C(厂商宣称),基准由 m-a-p 提交,本站未复算。

6.8721WildSongBench SongBench 均分(v5,第三方测)厂商宣称 · 2026-09
生产Suno官网
Suno:把音乐生产后半段工序全部收进一个产品
语音与音频影音创作梯顶A

VoiceStudio:把商用语音栈的整套工序搬到本地,并默认开给 agent

开源、完全本地的语音工作台(debpalash/VoiceStudio,AGPL-3.0,Python + Electron),自我定位为 ElevenLabs 的本地替代品:声音克隆、声音设计、视频配音、听写、转写与有声书制作,官方称覆盖 646 种语言。仓库 2026-04-09 建仓,到 2026-09-29 有 42,831 star / 5,005 fork。本站把它列为音频域本地自托管方向的梯顶,依据不是某个模型更强,而是抽象层有用:开源语音能力散落在十几个仓库里,各有自己的权重格式、设备要求、克隆接口与许可,拼一条「克隆音色→转写→对齐→配音→有声书」的产线,工程量主要花在粘合上;VoiceStudio 把 17 个 TTS 与 11 个 ASR 引擎收进统一注册表,逐引擎上报设备(CUDA/MPS/CPU)、是否可克隆、max_ref_seconds 与 ref_strategy,并给出可跑的工作流。对 agent 尤其关键:本地 API 与 MCP server 是产品自带的一等能力,README 直接给了可粘进 Claude Code / Codex / Cursor 的安装指令,还支持 npx skills add 装 skill,意味着编码 agent 可以把配音与转写当工具调用而不需要人点界面。参考音频口径也严谨:上限 75 秒,但真正进模型多少由引擎决定并逐引擎上报,超限时自动与已保存的转写会被忽略,给默认 OmniVoice 传超过 20 秒并附文本会以 [clone_ref_too_long] 直接报错。指标口径要说清:官方 docs/benchmarks.md 有一套真实 harness(逐阶段 profiling、内存不足拒绝启动、只收具名硬件与版本上的 RTF 热态与峰值显存、明确没有数字是估的),但结果一栏写着 No verified rows yet,所以本站不给它任何性能数字,卡片上只用本站自核的 GitHub star 数并据此记 A 档(可核验);这个 A 只针对数字为真,不针对它比 ElevenLabs 好。四条边界:AGPL-3.0 是强 copyleft 且带网络条款,嵌进对外 SaaS 需开放自己的服务端源码,闭源商用要么进程隔离只调本地 API(自行法律评估)要么改用 Apache-2.0 的 CosyVoice 3 / Kokoro 自行组装;模型各自有许可(Breeze-TTS-2 权重研究非商用、Supertonic-3 与 PocketTTS 需额外许可、GPT-SoVITS 要跑自己的 server),商用前逐模型核对;646 种语言是仓库自述,真实覆盖取决于所选引擎(Parakeet 25 种欧洲语言、FunASR 50+、Whisper 系更广),本站未逐语言核验;桌面端只剩 Electron,0.5.3 是最后一个 Tauri 版本,老用户必须迁移。它与 Eleven v4 在梯度上并存而不互相替代:一个代表闭源商用栈的质量上限与省心,一个代表本地自托管的数据主权与引擎可替换性。

42,831GitHub Stars(2026-09-29,本站经 GitHub API 核)已确认 · 2026-09
产品debpalash (open source)官网Repo
VoiceStudio:把商用语音栈的整套工序搬到本地,并默认开给 agent
语音与音频影音创作梯顶C

Eleven v3:一条把「说、听、唱」做齐的商用音频栈

ElevenLabs 的旗舰语音合成模型,官方称情感最丰富、最具表现力:戏剧化演绎、70+ 种语言、单次 5,000 字符、自然的多说话人对话,并随 v3 提供独立的 Text to Dialogue API,把多角色对白做成接口而不是 prompt 技巧。本站把它列为音频域梯顶,依据是背后唯一一条把说、听、唱都做齐的商用音频栈:TTS 四档、ASR 三档(含 Medical)、音乐两档。TTS 四档三轴互斥:v3 表现力最强但非实时、单次 5,000 字符;Flash v2.5 延迟约 75ms、每字符便宜 50%;Multilingual v2 长文本最稳却只有 29 语言;没有全能档,按场景分型号。ASR 侧 Scribe v2 覆盖 90+ 语言、32 人分离。延迟都是模型侧口径,不含网络与上游 LLM 时间,不能当 SLA 读。边界:长文本要自己分段,接缝处的韵律与音色一致性由你负责;闭源不可自托管,数据主权敏感场景是硬门槛。本站第三方榜里没有语音榜,与 Gemini 3.8 Flash TTS 并列不排名。置信度 C(厂商宣称):未复算 WER、未做盲听对比。

70+语言覆盖厂商宣称 · 2026-09
产品ElevenLabs官网
Eleven v3:一条把「说、听、唱」做齐的商用音频栈
语音与音频影音创作梯顶C

Gemini 3.8 Flash TTS:把导演级语音指导做成 API 参数

Google 的语音生成模型(gemini-3.8-flash-tts),官方定位 studio-grade voice fidelity、expressive acting 与 long-form stability,有声书翻车不是单句难听,是念到第三小时音色漂了。设计把作用域切开:文本字段严格当逐字稿,表演指令走另一条通道不会被念出来,修掉「(叹气)」被念出来的老问题;整轮风格走 speech_metadata.style,词级情感用竖线标签只影响那一个词。音色四类:预置、扩展库、语音设计 ID(自然语言造音色后复用)、克隆 ID,设计与克隆是 3.8 才补齐。规格:130 语言、自动检测输入语言,默认 WAV 24 kHz,单请求最多 2 个说话人且只能用预置音色。计费按音频 token、25 tokens 一秒,付费层每百万 tokens $0.50 输入 / $9.00 输出(至 2026-12-31,之后 $1.00/$18.00)。边界:24 kHz 非母带级;克隆合规责任在使用方。本站 12 个榜无语音榜,与 ElevenLabs v3 并列不排名。置信度 C(厂商宣称):未做可懂度测量与盲听对比。

全支持语音设计+克隆+多说话人厂商宣称 · 2026-09
产品Google官网
Gemini 3.8 Flash TTS:把导演级语音指导做成 API 参数
视频生成影音创作梯顶C

可灵 3.0 系列:音频原生进模型、画面到 4K,参数化镜头语言仍是它的护城河
快手可灵是国内最早把视频生成推到「能接商业单」水位的一条主线,长期强项不在纯文生视频,而在图生视频与运镜控制:先由图像环节锁定构图与角色,再让视频模型在确定的关键帧上补间,配合首尾帧约束与推/拉/摇/移/环绕/跟随的镜头参数,做出可预测的短片段。3.0 系列(官方 release-note 横幅:全面开放 API)带来三处实质跃迁——音频原生进模型(5/10/12 秒音频档)、图像与视频原生 2K/4K、智能分镜与元素参考把多镜头连贯从剪辑问题变成模型可控问题;型号分工为 3.0 / 3.0 Omni / 3.0 Turbo、Kling Image 3.0 与 -omni、Native 4K Video、Motion Control。竞技场水位说实话:图生视频 kling-v3-pro 第 19(Elo 1354),前面是 MiniMax h3、gemini-omni、wan3.0、seedance-2.5。3.0 系列的官方发布精确日期我们未拿到权威源,指标日期只按可核验月份记 2026-09。闭源、只走厂商接口;我们未做基准复现,置信度记 C。

3.0 / Omni / Turbo当前旗舰系列厂商宣称 · 2026-09
产品快手 Kuaishou官网
可灵 3.0 系列:音频原生进模型、画面到 4K,参数化镜头语言仍是它的护城河
证据流

12
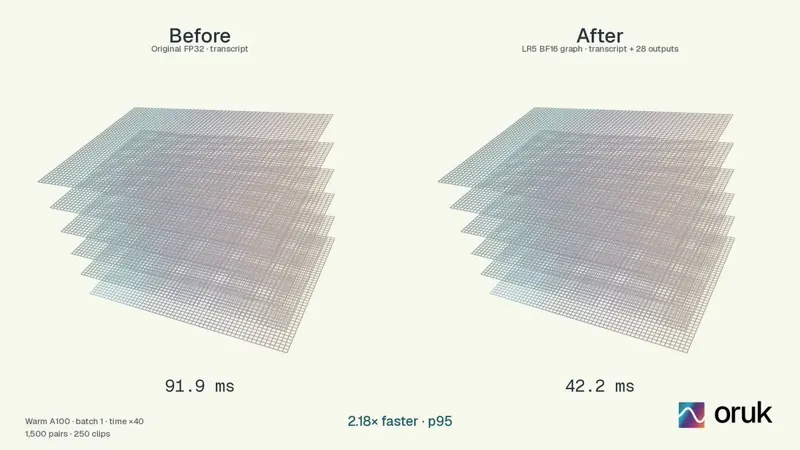
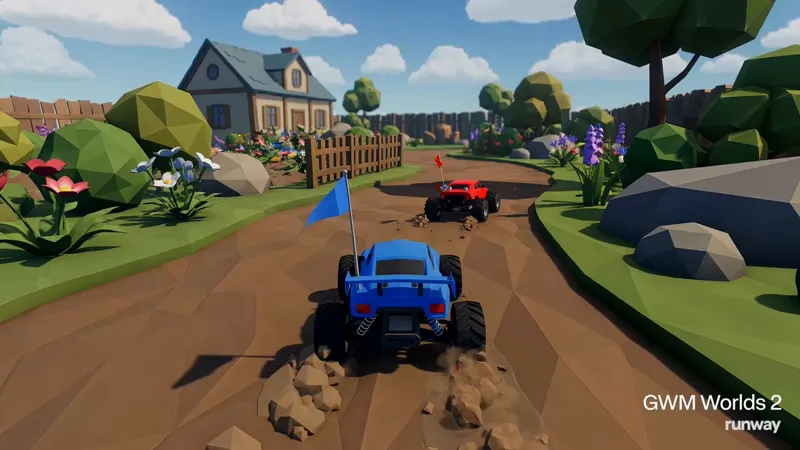
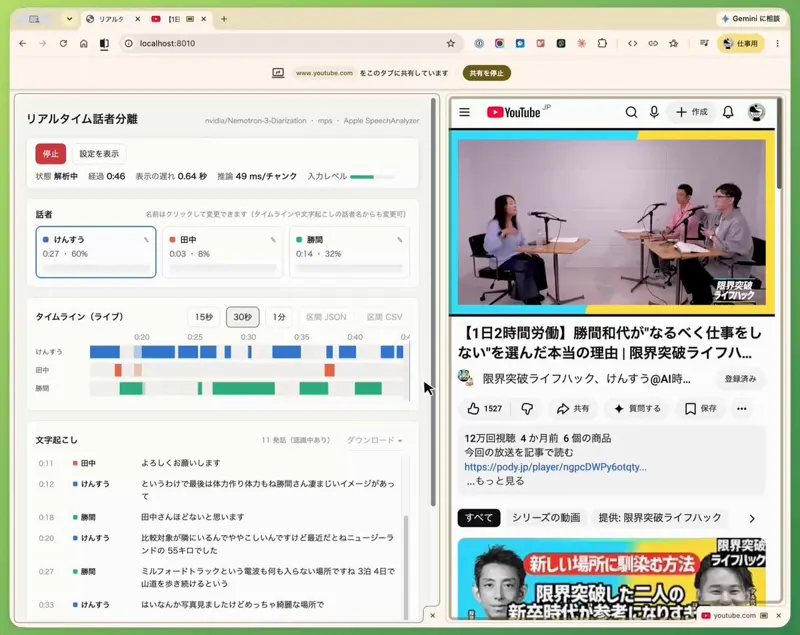
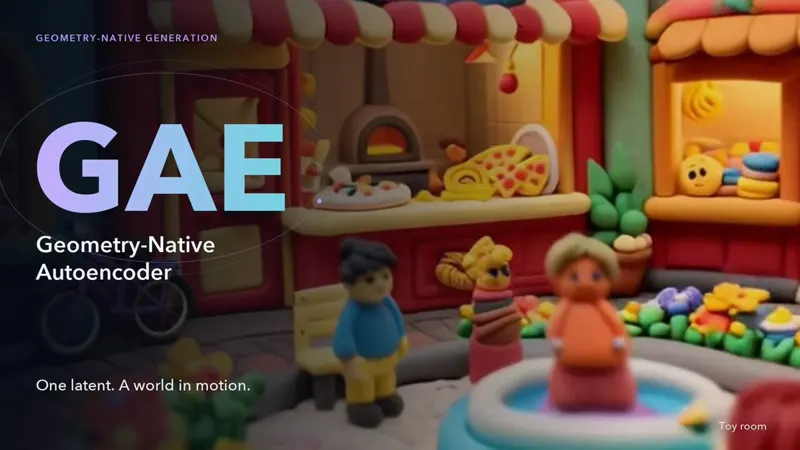
2026-09-27Nemotron 3 Diarization 实测:1 亿参数实时说话人分离,本地跑效果超预期日本开发者 @ouchi 测试 NVIDIA 9 月 23 日开源的 Nemotron 3 Diarization 说话人分离模型:实时流式下精度相当不错。该模型约 1 亿参数,基于 Streaming Sortformer 架构(31 层 Transformer + Arrival-Order Speaker Cache),单次前向即完成分离,支持最多 8 个说话人、10 毫秒分辨率、最低约 320 毫秒流式延迟,OpenMDW 1.1 许可,4GB 显存即可跑。作者观察:模型会边听边积累各说话人声纹特征,长音频离线分析精度略高于实时;HF 在线 demo 只支持 2 分钟音源所以效果一般,本地跑效果超出预期。VoiceArena Diarization-Bench 榜一(DER 14.72%)、AISHELL-4 9.8%(前代 27.2%)。语音 Agent 感知「谁在说话」的关键拼图,机器人语音交互直接相关。2026-09-26VoiceStudio:跑在本机的开源语音工作站开发者实测开源本地语音工作台 VoiceStudio:可在 14 个 TTS 引擎间切换,支持短样本语音克隆、646 语种视频配音、有声书、听写与转写;音频不出本机,无订阅、无按字符计费。2026-09-23WorldCrafter:免3D重建的世界模型腾讯ARC的WorldCrafter跳过3D重建:视频生成器按相机位姿查询隐式记忆,单图或文本提示即可生成数分钟场景漫游,权重已开源。2026-09-23有道 R2T2+T3PO 实时同传实测深度评测网易有道 R2T2 实时听写与 T3PO 实时翻译:两模型分登 Hugging Face ASR 与翻译 Trending 第一,可流式串联做实时同传。2026-09-23GAE:几何原生潜空间世界生成腾讯ARC的GAE把3072通道几何特征压进128通道潜空间,同一生成状态可解出RGB、深度、相机轨迹与点云;相机轨迹误差减半,FVD最多降23%。2026-09-22JEV-Speech:语音推理提速2.18倍Oruk Labs 的 Orukeet 衍生运行时:24 层编码器全部保留,在 A100 热启动 batch 1 下把p95 请求延迟从 91.93ms 压到 42.23ms,即 2.18 倍加速。不改权重与精度的稳妥版本拿到1.66 倍且 250 条录音转写完全一致;更快的版本加了 BF16 与编码器适配,代价是七语种测试多 15 个词错。2026-09-22EdgeQ:骁龙 NPU 上的端侧视觉模型Reka EdgeQ 原生跑在骁龙 8 Elite 的 Hexagon NPU 上:图像首字延迟 0.73s,MLVU 视频理解超 Gemma 4 E4B 34 分,单次推理 6.9mWh、发热低约 3 倍,推理时 GPU 全程空闲。2026-09-15Odyssey-3 发布物理智能世界模型Odyssey-3 以自回归扩散 Transformer 统一控制机械臂、人形机器人、车辆和无人机,并可在少量经验数据下学习任务,官方称仍处于早期验证阶段。2026-09-07北大 Motion-Omni 端到端口语对话系统北大推出 Motion-Omni,端到端生成语音与同步全身动作,含面部及肢体,RTF 0.78,响应快于实时。2026-09-06Vivix-W1:流式原生多模态模型,实时可交互视频生成Vivix Labs 发布 Vivix-W1,一个流式原生的多模态模型,把生成视频变成可实时响应的世界。除了常见的相机控制漫游,W1 支持在播放过程中接收触摸、文本与语音指令:点一下即可插入物体(一只猫跳上咖啡桌)、指挥角色行动,或即时重设整个场景风格(纽约街景实时变为工业革命风格)。110 秒演示展示了无需从头重生成、随输入持续演化的流式生成能力。2026-09-04StreamTalk:语音实时生成 SMPL-X 身体手势StreamTalk 将音频实时转换为身体手势,输出 SMPL-X 姿态骨架,3D 角色绑定交由用户完成;演示已在 Hugging Face Spaces 开放。2026-09-03GWM Worlds 2 实时生成可交互世界模拟Runway GWM Worlds 2 将高保真视频与音频生成扩展为实时交互模拟,用户可定义环境、主体、视觉风格、物理规则和氛围。

怎么用

还没有深读。这一段收的是工作流、实操与踩坑,不是新闻转述。

现在就能用的资产

边界与失败模式

边界与失败模式,按「这条频道特有的」到「两个成员域各自的」排。 一、频道级最容易误读的一件事:并集阶梯不是排行榜。它把两个成员域的资产按同一把排序口径(featured → 成熟度 → 指标日期新优先)拉成一条,只是为了让人一眼看全「这条线上我们逐条评过什么」。视频的 Elo 1516 与语音的延迟 100ms 不可通约,谁排在前面不表示谁更强。要名次,进成员分段,或去 /sota/video、/sota/audio 单域页看各自那把尺子。 二、评测缺位把整条频道压向保守。本站同步的 12 个榜里有文生视频与图生视频,没有任何语音榜、TTS 自然度榜或 ASR WER 榜;音乐侧只有 WildSongBench 这类第三方学术测,覆盖窄且各家采样口径不同(YuE2 的 6.9632 是 best-of-8,Suno v5 的 6.8721 不是同一种预算,两个数不可直接比大小)。所以音频侧的水位判断一律记 vendor-claim,只给可核验的公开事实(GitHub star 数、许可、价格、延迟自报)开 confirmed,不做盲听、不复算 WER。 三、音视频联合生成的对齐误差会累积。口型对不上在 5 秒内可容忍,在 30 秒叙事里观众一定察觉,而第三方目前没有量这件事的公开协议 —— 厂商 demo 一律是精选样本。凡是「一次生成带声音的视频」的结论,都要按 vendor-claim 读。 四、时长与物理仍是视频侧的硬墙。单次生成普遍停在 5-10 秒,更长靠首尾帧接力或多段拼接,接缝处的风格漂移与角色不一致要人工挑;流体、布料、多人交互、手与物体接触是高频翻车点,模型学到的是「看起来像物理」的纹理统计,不是守恒律。 五、音频侧的边界多数不在技术。语音克隆几秒样本即可,授权链、水印与滥用检测都不成熟;开源 TTS 权重可因滥用被撤回(2025-09 已有先例),「开源可用」不等于「长期可用」。本站把合规状态写进置信度判断。音乐侧的训练数据版权诉讼未决,商用交付要先看许可。 六、延迟与实时性在评测里几乎不被度量。多数高质量 TTS 的首包延迟在几百毫秒到秒级,真正可用的实时对话需要流式合成加可打断,榜单上的「最自然」在通话里可能根本不能用。长文本一致性(段落韵律、数字与专有名词读法、多音字、中英混排)是生产里最常见的翻车点,而评测集通常只读短句。 七、成本按两条线叠加,不要只算一边。720p 视频约 $0.10/秒,30 秒一条约 $3,商用交付里重 roll 三到十次是常态;语音按秒或按字符计费,批量 TTS 单价远低于视频,但实时通道的成本在并发不在时长;音乐生成接近视频量级,单曲几十秒到数分钟。一条带解说配乐的成片,预算要按「视频重 roll 次数 + 多版配音 + 多版配乐」算,不是三个单价相加。